Inhalt
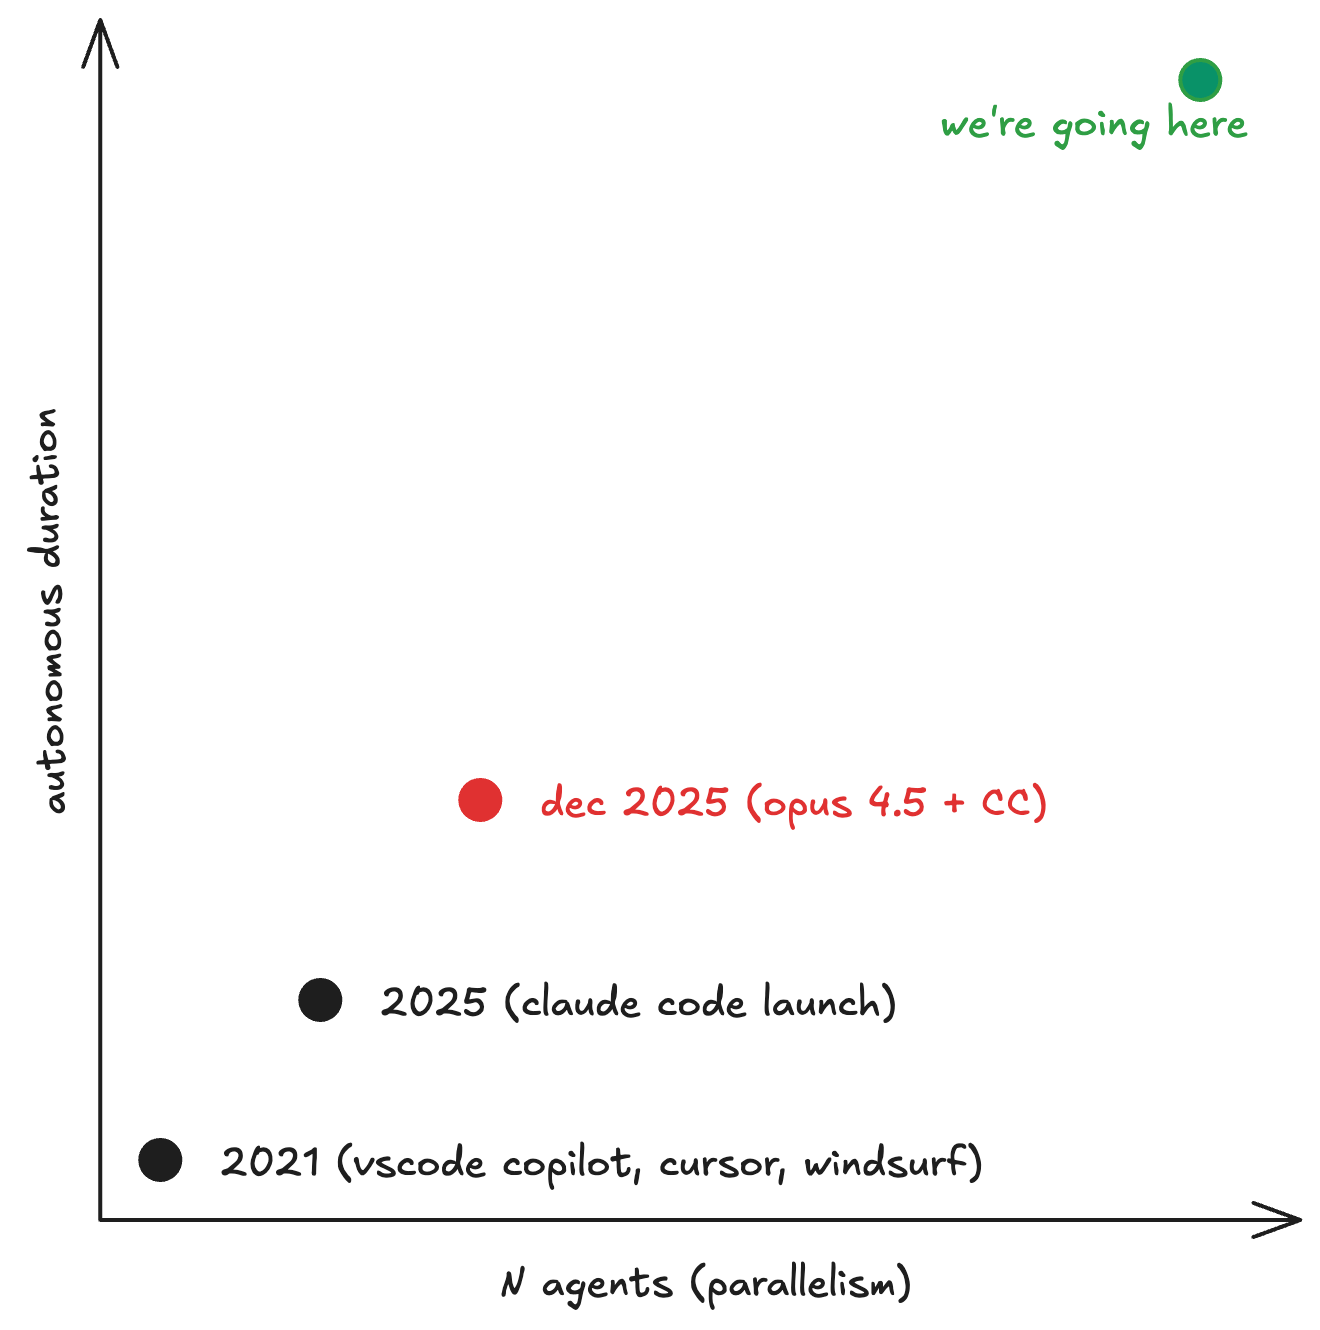
2025 war das Jahr der Agenten. Mit Claude Code fühlte sich die Arbeit mit LLMs an wie Pair Programming mit einem sehr fähigen, aber unerfahrenen Juniorentwickler. Irgendwann im Dezember 2025, mit der Veröffentlichung von Opus 4.5, wurde ein sprunghafter Zuwachs an Fähigkeiten spürbar. Claude konnte stundenlang selbstständig arbeiten.
Der naheliegende nächste Schritt ist, mit tmux viele Claude-Code-Instanzen zu betreiben und sie an separaten Issues arbeiten zu lassen.
Das wurde so üblich, dass Anthropic es als „Multi-Clauding“ zu bezeichnen begann.
In Steve Yegges Terminologie ist das Stufe 6/7 des agentischen Programmierens.
tmux ist großartig, aber der mentale Aufwand wird enorm.
Du wechselst ständig zwischen Ideenfindung, Steuerung und Review.
Es ist klar: Du bist der Engpass, und dass du nicht mehr Agenten steuern kannst, ist ein „Skill Issue“.
Das muss doch besser gehen.
Also habe ich hive gebaut.
Was ist Hive
Hive ist ein asynchroner Python-Orchestrator, der in einem einzigen Prozess läuft und mehrere LLM-Coding-Agenten über eine SQLite-Warteschlange koordiniert. Dabei nutzt er Git-Worktrees als Ausführungssandboxes.
Das System besteht aus drei Komponenten. Die Queen ist eine Claude-Sitzung, die als deine Projektmanagerin fungiert: Du beschreibst die Arbeit, sie erkundet die Codebasis, schlägt eine Aufteilung in Issues mit Abhängigkeiten vor und wartet auf deine Freigabe. Worker sind parallele Claude- (oder Codex-)Sitzungen, jeweils in einem eigenen Git-Worktree, die sich Issues aus der Warteschlange holen und sie umsetzen. Die Merge-Pipeline ist ein weiterer Agent, der für abgeschlossene Arbeiten ein Rebase ausführt, sie testet und zurück nach main mergt.
Das zentrale Designprinzip: deterministische Orchestrierung in Python, Entscheidungen mit Interpretationsspielraum werden an LLM-Sitzungen delegiert. Zustandsübergänge, Aufgabenübernahme, Eskalation? Python. Konfliktlösung, Diagnose von Testfehlern, strategische Aufgabenzerlegung? Claude.
Hier ist die Gesamtübersicht:
You
  ├─ CLI / Queen (TUI)
  └─ Daemon (background)
       ↓
SQLite Database (~/.hive/hive.db)
  ├─ Issues (work queue)
  ├─ Dependencies (DAG)
  ├─ Agents (ephemeral identity)
  ├─ Events (audit trail)
  ├─ Notes (inter-agent knowledge)
  └─ Merge Queue
       ↓
Orchestrator (async event loop)
  ├─ Main Loop (spawn workers when slots open)
  ├─ Event Consumer (status updates from backends)
  └─ Merge Processor (per-project)
       ↓
Backend Pool
  ├─ Claude WS Backend (claude CLI via WebSocket)
  ├─ Codex App Server Backend (stdio protocol)
  └─ Tau Backend (testing)
       ↓
Workers (each in its own git worktree)
Die Zustandsmaschine
Jedes Issue durchläuft einen Lebenszyklus mit sieben Zuständen. Das ist das Wichtigste, was man über hive verstehen muss, denn jede Designentscheidung ergibt sich aus der Anforderung, dass diese Zustandsmaschine korrekt funktioniert.
OPEN ──(claim)──→ IN_PROGRESS ──(success)──→ DONE ──(merge)──→ FINALIZED
  ↑                    │
  └──(retry/switch)────┘
                       │
                  (exhausted)──→ ESCALATED
                       │
                  (manual)─────→ CANCELED
Die Eskalationsregeln sehen drei aufeinanderfolgende Stufen vor.
- Erneut mit demselben Agenten versuchen, bis zu 2 Versuche. Vielleicht hatte das Modell einfach einen schlechten Durchlauf.
- Agentenwechsel: ein neuer Agent mit einem sauberen Worktree, bis zu 2 Wechsel.
- An einen Menschen eskalieren.
Es gibt auch eine Anomalieerkennung: 3 oder mehr Fehlschläge innerhalb eines 10-Minuten-Zeitfensters lösen eine sofortige Eskalation aus, unabhängig vom Budget für Wiederholungsversuche. So werden systematische Fehler (defekte Testsuite, fehlende Abhängigkeit, Probleme beim Anbieter) erkannt, bevor sie Tokens aufbrauchen.
Aufgaben übernehmen
Die Ready-Queue besteht aus einer SQL-Abfrage, die den Abhängigkeits-DAG auswertet:
SELECT * FROM issues
WHERE status = 'open'
  AND assignee IS NULL
  AND type != 'epic'
  AND NOT EXISTS (
    SELECT 1 FROM dependencies d
    JOIN issues blocker ON d.depends_on = blocker.id
    WHERE d.issue_id = issues.id
      AND blocker.status NOT IN ('done', 'finalized', 'canceled')
  )
ORDER BY priority ASC, created_at ASC
Ein Issue wird erst „ready“, wenn alle blockierenden Abhängigkeiten aufgelöst sind.
Die Übernahme erfolgt durch ein atomares Update nach dem CAS-Prinzip: prüfen, ob das Issue noch offen und niemandem zugewiesen ist, prüfen, ob die Abhängigkeiten weiterhin erfüllt sind, und dann das Update in einer einzigen Transaktion durchführen. Wenn zwei Worker gleichzeitig dasselbe Issue übernehmen wollen, gewinnt einer, und der andere erhält False zurück.
Die Backend-Abstraktion
Mit diesem Teil bin ich am zufriedensten.
Die Schnittstelle HiveBackend umfasst ungefähr 15 Methoden für die Sitzungsverwaltung (create_session, abort_session, get_session_status), die Kommunikation (send_message_async, get_messages, reply_permission) und das Event-Streaming (on(event_type, handler), connect_with_reconnect()).
Dem Orchestrator ist egal, welches Backend läuft; er ruft einfach die Schnittstelle auf.
Warum ist das wichtig? Die leistungsfähigsten Frontier-Modelle wechseln sich alle paar Monate auf dem ersten Platz ab. Und es ist unklar, wie verschiedene Modelle mit verschiedenen CLI-Wrappern zusammenspielen (ich höre, GPT 5.4 in Claude Code soll ziemlich gut sein). Durch die Unabhängigkeit von Modell und Harness muss der zentrale Orchestrierungscode nicht geändert werden, während sich alles andere rasant weiterentwickelt.
Die Merge-Pipeline
Wenn ein Worker ein Issue abschließt, gelangt die Arbeit in eine Merge-Pipeline.
Merges werden von einer dedizierten Claude-Sitzung namens „Refinery“ abgewickelt. Die Refinery erhält den Konfliktkontext oder die Testausgabe, löst das Problem und schreibt eine strukturierte Ergebnisdatei. Sie kann die Arbeit mergen (Konflikt gelöst, Tests bestanden), ablehnen (zur Überarbeitung zurück zu open schicken) oder an einen Menschen eskalieren (zu komplex oder mehrdeutig).
Die Refinery ist eine langlebige Sitzung pro Projekt, die für mehrere Merge-Vorgänge wiederverwendet wird. Wenn sich zu viel Kontext angesammelt hat (>100k Tokens oder >20 Nachrichten), ersetzt hive sie durch eine neue, um mit frischem Kontext weiterzuarbeiten. Jedes Projekt erhält ein eigenes MergeProcessor, sodass sich Merges verschiedener Projekte bei der Orchestrierung nicht gegenseitig blockieren.
Wissenstransfer zwischen Agenten
Worker schreiben .hive-notes.jsonl während der Ausführung:
{"category": "discovery", "content": "postgres dependency in main.py requires PGHOST to be set"}
{"category": "gotcha", "content": "tests require PYTHONPATH=src/"}
Wenn ein Worker fertig ist, sammelt hive seine Notizen ein und speichert sie in der Datenbank. Wenn ein neuer Worker für ein verwandtes Issue gestartet wird (dasselbe Epic, dasselbe Projekt), fügt hive relevante Notizen der anderen Worker in den Prompt ein.
Wenn also Agent #1 entdeckt, dass die Testsuite eine bestimmte Umgebungsvariable benötigt, weiß Agent #3 (der an einer verwandten Aufgabe arbeitet) das schon, bevor er beginnt. Wissen sammelt sich im gesamten Schwarm an, ohne dass ein einzelner Agent alles davon im Kontext halten muss.
Die Queen
Die Queen ist die zentrale Anlaufstelle für die Interaktion mit hive.
Sie ist eine Claude-Sitzung, die in deinem Terminal läuft (TUI-Modus).
Du gibst ihr eine Spezifikation, dann erkundet sie die Codebasis, liest das gesammelte Projektwissen aus .hive/project-context.md, schlägt eine Aufteilung in Issues mit Abhängigkeiten vor, wartet auf deine Freigabe und erstellt dann die Issues und startet den Daemon.
Für die Skriptnutzung gibt es auch einen Headless-Modus:
hive queen --headless -p "Bump all dependencies and update the lockfile"
Mit der Queen wechselst du von der Steuerung einzelner Agenten zur Verwaltung eines Projekts. Du denkst darüber nach, was passieren muss und wie es sich aufteilen lässt.
Konfiguration und Anpassbarkeit
Hive nutzt eine Konfigurationshierarchie mit vier Ebenen: integrierte Standardwerte → globale TOML-Datei (~/.hive/config.toml) → projektbezogene TOML-Datei (.hive.toml) → Umgebungsvariablen. Die interessanten Stellschrauben:
| Einstellung | Standardwert | Was sie steuert |
|---|---|---|
max_agents |
3 | Parallel laufende Worker |
worker_model |
claude-sonnet-4-6 | Modell für die Implementierung |
refinery_model |
claude-opus-4-6 | Modell für Merge-Konflikte |
max_tokens_per_issue |
200.000 | Token-Budget pro Issue |
max_retries |
2 | Wiederholungsversuche vor einem Agentenwechsel |
max_agent_switches |
2 | Wechsel vor einer Eskalation |
backend |
claude | claude | codex |
test_command |
-- | Testbefehl für die Merge-Freigabe |
Was ich gelernt habe
Die Codebasis umfasst etwa 6.500 Zeilen Python-Code. Sie ist dafür ausgelegt, lokal zu laufen, nur wenige Ressourcen zu benötigen und so einfach zu sein, dass du an einem Nachmittag den gesamten Code lesen und anfangen kannst, daran weiterzuarbeiten.
Ein paar Dinge, die ich bei der Arbeit an hive gelernt habe:
SQLite ist dafür die richtige Datenbank. Der WAL-Modus ermöglicht gleichzeitige Lesezugriffe während Schreibvorgängen, und das busy_timeout-Pragma sorgt für einen sauberen Umgang mit Sperrkonflikten. Die gesamte Koordinationsschicht lässt sich allein mit SQL-Abfragen umsetzen. Für 3–20 parallel arbeitende Agenten ist SQLite mehr als ausreichend, und der einfache Betrieb ist viel wert.
Git-Worktrees werden immer noch unterschätzt. Jeder Agent bekommt seinen eigenen Worktree des Repositories mit einem von main abgezweigten Branch. Sie kommen sich bei ihren Dateien nicht in die Quere, und wenn die Arbeit erledigt ist, führst du einen Rebase und einen Merge durch. Wenn es schiefgeht, löschst du den Worktree. Die Isolation ist perfekt, und das Aufräumen ist trivial.
Beim Notizsystem bin ich mir noch unsicher. Es leuchtet ein, dass es die Fehlerraten bei verwandten Aufgaben deutlich senken sollte, wenn Agenten Erkenntnisse über die Codebasis gewinnen und diese mit anderen Agenten teilen. Aber es ist schwierig, Aufgaben und Benchmarks zu entwerfen, die das präzise messen. Das ist etwas, das in künftigen Arbeiten noch ausgiebig untersucht werden sollte.
Den Code gibt es unter github.com/nwyin/hive. Er steht unter der MIT-Lizenz und ist dafür gedacht, geforkt und angepasst zu werden. Wenn du 3 oder mehr Agenten in tmux verwaltest und dir etwas mehr Struktur wünschst, schau ihn dir an.