contenido
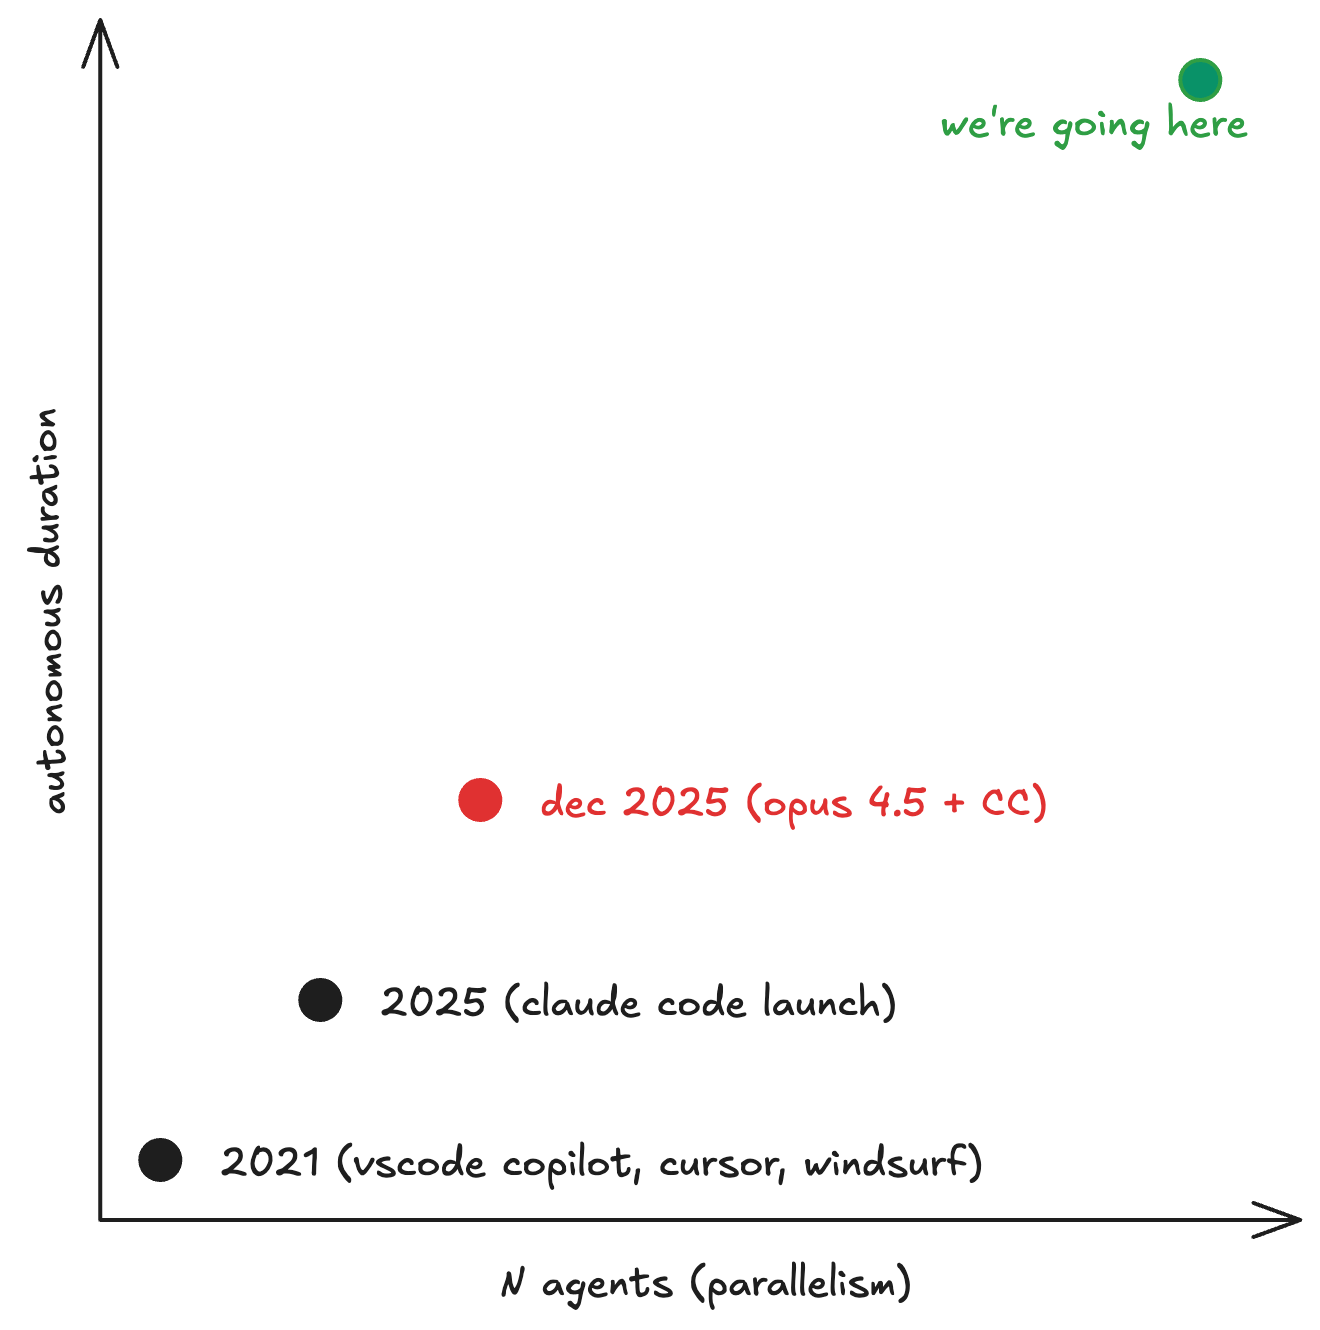
2025 fue el año de los agentes. Claude Code hizo que trabajar con LLM se pareciera a programar en pareja con un desarrollador júnior muy competente, pero inexperto. En algún momento de diciembre de 2025, con el lanzamiento de Opus 4.5, se empezó a notar un salto en sus capacidades. Claude era capaz de trabajar por su cuenta durante horas seguidas.
El siguiente paso evidente es tmux muchas instancias de Claude Code y hacer que trabajen en incidencias distintas.
Esto se volvió tan habitual que Anthropic empezó a llamarlo «multi-Clauding».
Según la terminología de Steve Yegge, esto corresponde al nivel 6/7 de la programación con agentes.
tmux está muy bien, pero la carga cognitiva se vuelve brutal.
Estás alternando constantemente entre generar ideas, dirigir y revisar.
Está claro que tú eres el cuello de botella y que no poder gestionar más agentes es un «problema de habilidad».
Tiene que haber una forma mejor.
Así que desarrollé hive.
Qué es
Hive es un orquestador asíncrono escrito en Python que se ejecuta en un único proceso y coordina varios agentes de programación basados en LLM mediante una cola en SQLite, utilizando worktrees de Git como entornos aislados de ejecución.
Hay tres componentes. La Reina es una sesión de Claude que actúa como tu gestora de proyectos: le describes el trabajo, ella explora la base de código, propone una descomposición en incidencias con dependencias y espera tu aprobación. Los Trabajadores son sesiones de Claude (o Codex) en paralelo, cada una en su propio worktree de Git, que toman incidencias de la cola y las implementan. El Flujo de integración es otro agente que hace rebase, ejecuta pruebas e integra en main el trabajo terminado.
El principio de diseño fundamental: orquestación determinista en Python y decisiones ambiguas delegadas a sesiones de LLM. ¿Transiciones de la máquina de estados, asignación de trabajo, escalado? Python. ¿Resolución de conflictos, diagnóstico de pruebas, descomposición estratégica? Claude.
Este es el esquema completo:
You
  ├─ CLI / Queen (TUI)
  └─ Daemon (background)
       ↓
SQLite Database (~/.hive/hive.db)
  ├─ Issues (work queue)
  ├─ Dependencies (DAG)
  ├─ Agents (ephemeral identity)
  ├─ Events (audit trail)
  ├─ Notes (inter-agent knowledge)
  └─ Merge Queue
       ↓
Orchestrator (async event loop)
  ├─ Main Loop (spawn workers when slots open)
  ├─ Event Consumer (status updates from backends)
  └─ Merge Processor (per-project)
       ↓
Backend Pool
  ├─ Claude WS Backend (claude CLI via WebSocket)
  ├─ Codex App Server Backend (stdio protocol)
  └─ Tau Backend (testing)
       ↓
Workers (each in its own git worktree)
La máquina de estados
Cada incidencia pasa por un ciclo de vida de 7 estados. Esto es lo más importante que hay que entender sobre hive, porque cada decisión de diseño responde a la necesidad de garantizar que esta máquina de estados funcione correctamente.
OPEN ──(claim)──→ IN_PROGRESS ──(success)──→ DONE ──(merge)──→ FINALIZED
  ↑                    │
  └──(retry/switch)────┘
                       │
                  (exhausted)──→ ESCALATED
                       │
                  (manual)─────→ CANCELED
La política de escalado sigue una cadena de tres niveles.
- Reintentar con el mismo agente, hasta 2 intentos. Puede que el modelo simplemente haya tenido una mala ejecución.
- Cambiar de agente: un agente nuevo con un worktree limpio, hasta 2 cambios.
- Escalar a una persona.
También hay un detector de anomalías: 3 o más fallos en un intervalo de 10 minutos provocan un escalado inmediato, sin tener en cuenta el límite de reintentos. Esto detecta fallos sistemáticos (batería de pruebas rota, dependencia ausente, problemas del proveedor) antes de que agoten los tokens.
Asignación de trabajo
La cola de incidencias listas es una consulta SQL que resuelve el DAG de dependencias:
SELECT * FROM issues
WHERE status = 'open'
  AND assignee IS NULL
  AND type != 'epic'
  AND NOT EXISTS (
    SELECT 1 FROM dependencies d
    JOIN issues blocker ON d.depends_on = blocker.id
    WHERE d.issue_id = issues.id
      AND blocker.status NOT IN ('done', 'finalized', 'canceled')
  )
ORDER BY priority ASC, created_at ASC
Una incidencia solo pasa a estar «lista» cuando se resuelven todos sus bloqueos.
La asignación es una actualización atómica de tipo CAS: se comprueba que la incidencia siga abierta y sin asignar, se comprueba que las dependencias sigan satisfechas y, a continuación, se actualiza en una sola transacción. Si dos trabajadores compiten por la misma incidencia, uno se la queda y el otro recibe False.
La abstracción del backend
Esta es la parte que más me satisface.
La interfaz HiveBackend consta de unos 15 métodos que abarcan la gestión de sesiones (create_session, abort_session, get_session_status), la comunicación (send_message_async, get_messages, reply_permission) y la transmisión de eventos (on(event_type, handler), connect_with_reconnect()).
Al orquestador le da igual qué backend se esté ejecutando; simplemente llama a la interfaz.
¿Por qué importa esto? Los modelos de vanguardia se van turnando en el primer puesto del podio cada pocos meses. Y no está claro cómo interactúan los distintos modelos con los distintos wrappers de CLI (he oído que GPT 5.4 en Claude Code funciona bastante bien). Ser independiente tanto del modelo como del harness significa que el código central de orquestación no necesita cambiar mientras todo lo demás evoluciona rápidamente.
El flujo de integración
Cuando un trabajador completa una incidencia, el trabajo entra en un flujo de integración.
Las integraciones las gestiona una sesión de Claude dedicada llamada «Refinería». La Refinería recibe el contexto del conflicto o la salida de las pruebas, resuelve el problema y escribe un archivo de resultados estructurado. Puede integrar el trabajo (conflicto resuelto, pruebas superadas), rechazarlo (devolverlo a open para que se rehaga) o escalar el problema a una persona (demasiado complejo o ambiguo).
La Refinería es una sesión de larga duración por proyecto, que se reutiliza en varias operaciones de integración. Cuando acumula demasiado contexto (>100k tokens o >20 mensajes), hive renueva la sesión para evitar que el contexto se sobrecargue. Cada proyecto tiene su propio MergeProcessor, de modo que la orquestación de varios proyectos no genera contención entre ellos durante las integraciones.
Transferencia de conocimiento entre agentes
Los trabajadores escriben .hive-notes.jsonl durante la ejecución:
{"category": "discovery", "content": "postgres dependency in main.py requires PGHOST to be set"}
{"category": "gotcha", "content": "tests require PYTHONPATH=src/"}
Cuando un trabajador termina, hive recopila sus notas y las guarda en la base de datos. Al iniciar un nuevo trabajador para una incidencia relacionada (misma épica, mismo proyecto), hive incorpora al prompt las notas relevantes de otros trabajadores de ese grupo.
Esto significa que, si el agente n.º 1 descubre que la batería de pruebas necesita una variable de entorno específica, el agente n.º 3 (que trabaja en una tarea relacionada) lo sabrá antes de empezar. El conocimiento se acumula en el enjambre sin que ningún agente tenga que mantenerlo todo en su contexto.
La Reina
La Reina es el principal punto de interacción con hive.
Es una sesión de Claude que se ejecuta en tu terminal (modo TUI).
Le das una especificación y entonces explora la base de código, lee .hive/project-context.md para consultar el conocimiento acumulado sobre el proyecto, propone una descomposición en incidencias con dependencias, espera tu aprobación y después crea las incidencias e inicia el demonio.
También hay un modo sin interfaz para usarlo en scripts:
hive queen --headless -p "Bump all dependencies and update the lockfile"
La Reina te permite pasar de dirigir agentes individuales a gestionar un proyecto. Piensas en qué tiene que hacerse y cómo se descompone.
Configuración y facilidad de modificación
Hive usa una configuración de 4 capas: valores predeterminados integrados → TOML global (~/.hive/config.toml) → TOML del proyecto (.hive.toml) → variables de entorno. Los ajustes más interesantes:
| Ajuste | Valor predeterminado | Qué controla |
|---|---|---|
max_agents |
3 | Trabajadores concurrentes |
worker_model |
claude-sonnet-4-6 | Modelo para la implementación |
refinery_model |
claude-opus-4-6 | Modelo para conflictos de integración |
max_tokens_per_issue |
200.000 | Presupuesto de tokens por incidencia |
max_retries |
2 | Reintentos antes de cambiar de agente |
max_agent_switches |
2 | Cambios antes del escalado |
backend |
claude | claude | codex |
test_command |
-- | Comando de pruebas que condiciona la integración |
Lo que he aprendido
La base de código tiene unas 6.500 líneas de Python. Está diseñada para ejecutarse en local, usar recursos mínimos y ser lo bastante sencilla como para que puedas leerla entera en una tarde y empezar a modificarla.
Algunas cosas que aprendí mientras trabajaba en hive:
SQLite es la base de datos adecuada para esto. El modo WAL permite realizar lecturas concurrentes durante las escrituras y el pragma busy_timeout gestiona bien la contención de bloqueos. Puedes construir toda la capa de coordinación solo con consultas SQL. Para entre 3 y 20 agentes concurrentes, SQLite es más que suficiente, y la sencillez operativa tiene mucho valor.
Los worktrees de Git siguen estando infravalorados. Cada agente tiene su propio worktree del repositorio, en una rama que parte de main. No pueden pisarse los archivos y, cuando el trabajo está terminado, haces rebase y lo integras. Cuando falla, eliminas el worktree. El aislamiento es perfecto y la limpieza es trivial.
Todavía tengo dudas sobre el sistema de notas. Tiene sentido que los agentes descubran cosas sobre la base de código y compartan esos descubrimientos con sus pares, y que eso reduzca de forma significativa las tasas de fallo en tareas relacionadas. Pero es difícil diseñar tareas y pruebas comparativas que midan esto con precisión. Es algo que debería explorarse a fondo en futuros trabajos.
El código está en github.com/nwyin/hive. Tiene licencia MIT y está diseñado para que puedas hacer un fork y modificarlo. Si gestionas 3 o más agentes en tmux y quieres algo más estructurado, échale un vistazo.