सामग्री
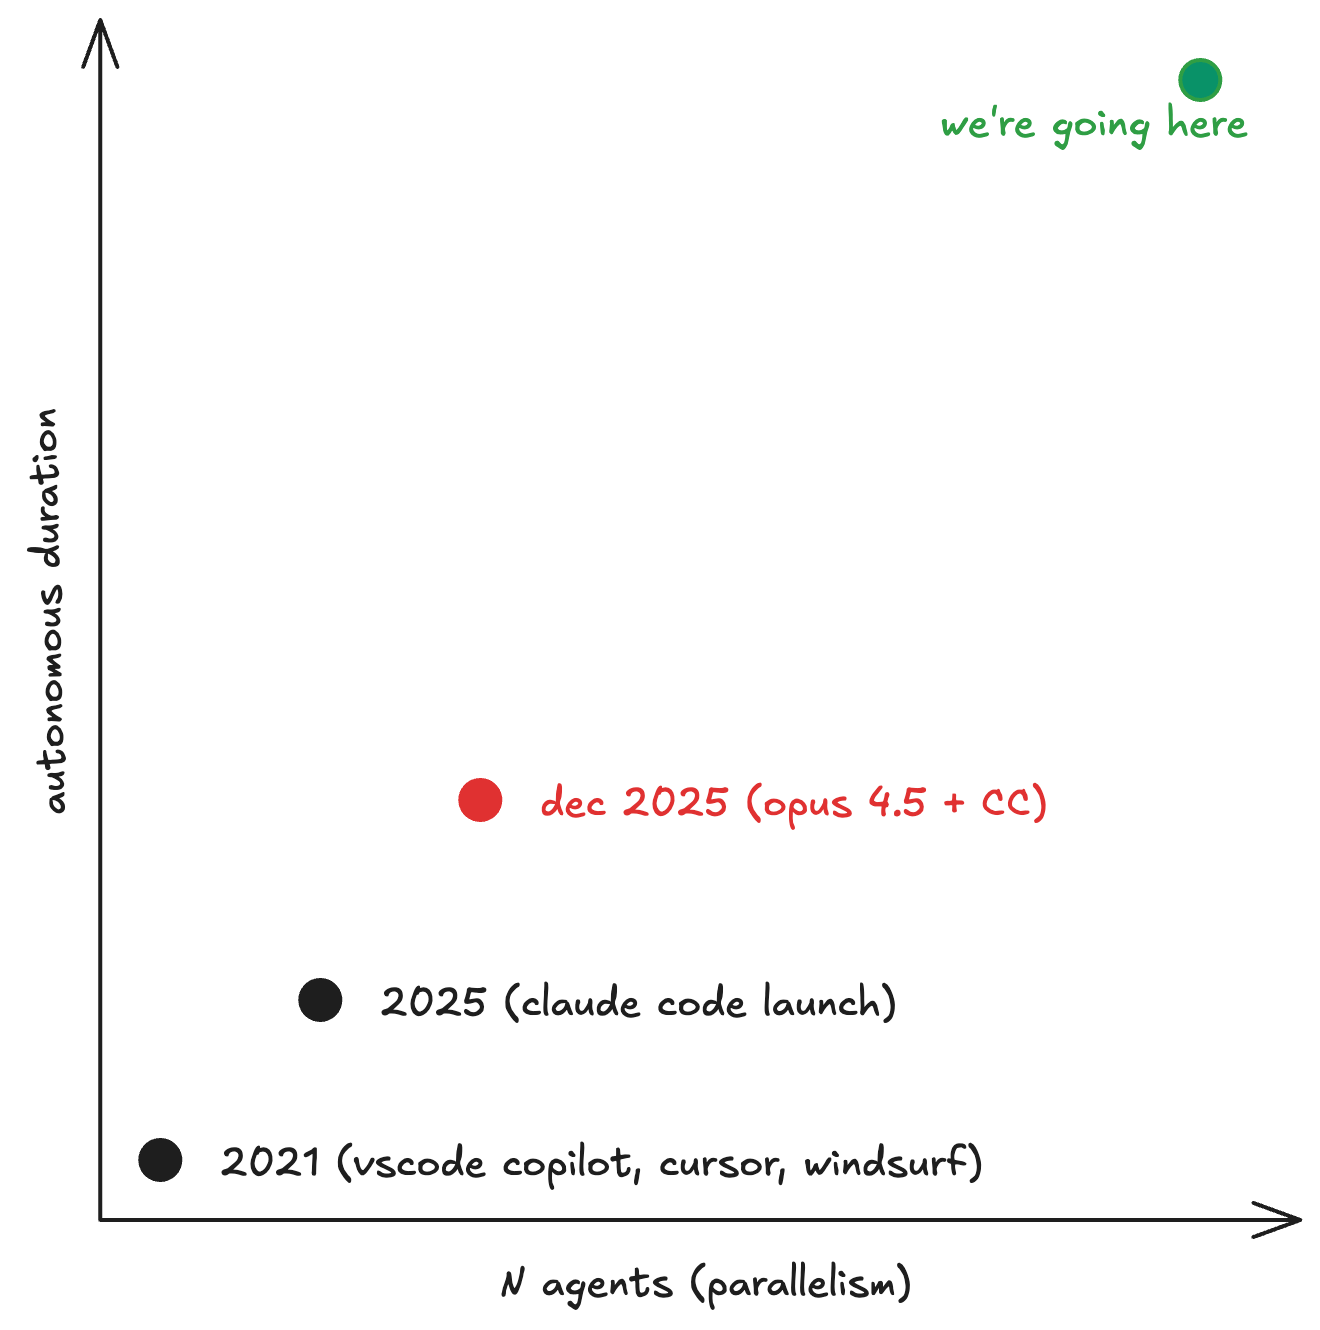
2025 एजेंटों का साल था। Claude Code ने LLM के साथ काम करना किसी बेहद कुशल लेकिन अनुभवहीन जूनियर डेवलपर के साथ पेयर प्रोग्रामिंग करने जैसा बना दिया। दिसंबर 2025 में किसी समय, Opus 4.5 के रिलीज़ होने के साथ, क्षमता में एक स्पष्ट उछाल दिखने लगा। Claude एक बार में घंटों तक अपने आप काम कर पा रहा था।
अगला स्वाभाविक कदम है Claude Code के कई इंस्टेंस tmux करना और उनसे अलग-अलग इश्यू पर काम करवाना।
यह इतना आम हो गया कि Anthropic इसे "multi-Clauding" कहने लगा।
Steve Yegge की शब्दावली में, यह एजेंटिक कोडिंग का स्तर 6/7 है।
tmux बढ़िया है, लेकिन इसे संभालने का मानसिक बोझ बहुत भारी पड़ने लगता है।
आप लगातार नए विचार सोचने, एजेंटों को दिशा देने और उनके काम की समीक्षा करने के बीच अदल-बदल करते रहते हैं।
यह साफ़ है कि अड़चन आप ही हैं, और ज़्यादा एजेंटों को संभाल न पाना आपके "कौशल की कमी" का मामला है।
ज़रूर कोई बेहतर तरीका होगा।
इसलिए मैंने hive बनाया।
यह क्या है
Hive एक ही प्रोसेस में चलने वाला एसिंक्रोनस Python ऑर्केस्ट्रेटर है, जो SQLite क्यू के ज़रिए कई LLM कोडिंग एजेंटों का समन्वय करता है और काम चलाने के लिए git worktrees को सैंडबॉक्स की तरह इस्तेमाल करता है।
इसके तीन मुख्य हिस्से हैं। क्वीन एक Claude सेशन है जो आपके प्रोजेक्ट मैनेजर की भूमिका निभाती है: आप काम का विवरण देते हैं, वह कोडबेस की छानबीन करती है, काम को आपसी निर्भरताओं वाले इश्यू में बाँटने का प्रस्ताव देती है और आपकी मंज़ूरी का इंतज़ार करती है। वर्कर समानांतर चलने वाले Claude (या Codex) सेशन हैं। हर वर्कर अपने अलग git worktree में क्यू से इश्यू उठाकर उन्हें इम्प्लीमेंट करता है। मर्ज पाइपलाइन एक और एजेंट है, जो रीबेस करता है, टेस्ट चलाता है और पूरे हो चुके काम को वापस main में मर्ज करता है।
डिज़ाइन का मूल सिद्धांत: निश्चित नियमों वाला ऑर्केस्ट्रेशन Python में, और अस्पष्टता वाले फ़ैसले LLM सेशन के ज़िम्मे। स्टेट मशीन में अवस्थाएँ बदलना, काम अपने ज़िम्मे लेना, मामला आगे सौंपना? Python। कॉन्फ़्लिक्ट सुलझाना, टेस्ट की समस्याओं का कारण खोजना, काम को रणनीतिक ढंग से हिस्सों में बाँटना? Claude।
यह रही पूरी तस्वीर:
You
  ├─ CLI / Queen (TUI)
  └─ Daemon (background)
       ↓
SQLite Database (~/.hive/hive.db)
  ├─ Issues (work queue)
  ├─ Dependencies (DAG)
  ├─ Agents (ephemeral identity)
  ├─ Events (audit trail)
  ├─ Notes (inter-agent knowledge)
  └─ Merge Queue
       ↓
Orchestrator (async event loop)
  ├─ Main Loop (spawn workers when slots open)
  ├─ Event Consumer (status updates from backends)
  └─ Merge Processor (per-project)
       ↓
Backend Pool
  ├─ Claude WS Backend (claude CLI via WebSocket)
  ├─ Codex App Server Backend (stdio protocol)
  └─ Tau Backend (testing)
       ↓
Workers (each in its own git worktree)
स्टेट मशीन
हर इश्यू 7 अवस्थाओं वाले जीवनचक्र से गुज़रता है। Hive के बारे में समझने के लिए यह सबसे ज़रूरी बात है, क्योंकि डिज़ाइन का हर निर्णय इस स्टेट मशीन को सही बनाए रखने से तय होता है।
OPEN ──(claim)──→ IN_PROGRESS ──(success)──→ DONE ──(merge)──→ FINALIZED
  ↑                    │
  └──(retry/switch)────┘
                       │
                  (exhausted)──→ ESCALATED
                       │
                  (manual)─────→ CANCELED
मामला आगे सौंपने की नीति में तीन स्तर हैं।
- उसी एजेंट के साथ फिर कोशिश करें, अधिकतम 2 प्रयास। शायद मॉडल का वह रन ही खराब रहा हो।
- एजेंट बदलें: एक साफ़ worktree के साथ नया एजेंट, अधिकतम 2 बार बदलाव।
- मामला किसी इंसान को सौंप दें।
असामान्य स्थितियों का पता लगाने वाला एक तंत्र भी है: 10 मिनट की अवधि में 3 या अधिक विफलताएँ होने पर, दोबारा कोशिश करने की तय सीमा को दरकिनार करके मामला तुरंत आगे सौंप दिया जाता है। इससे सिस्टम से जुड़ी विफलताएँ (खराब टेस्ट सूट, किसी डिपेंडेंसी का न होना, सेवा प्रदाता की समस्याएँ) ढेर सारे टोकन ख़र्च कर देने से पहले पकड़ में आ जाती हैं।
काम अपने ज़िम्मे लेना
तैयार कामों की क्यू एक SQL क्वेरी है, जो डिपेंडेंसी DAG को हल करती है:
SELECT * FROM issues
WHERE status = 'open'
  AND assignee IS NULL
  AND type != 'epic'
  AND NOT EXISTS (
    SELECT 1 FROM dependencies d
    JOIN issues blocker ON d.depends_on = blocker.id
    WHERE d.issue_id = issues.id
      AND blocker.status NOT IN ('done', 'finalized', 'canceled')
  )
ORDER BY priority ASC, created_at ASC
कोई इश्यू तभी "तैयार" होता है जब उसे रोकने वाले सभी इश्यू हल हो चुके हों।
काम अपने ज़िम्मे लेना CAS-शैली का एटॉमिक अपडेट है: पुष्टि करें कि इश्यू अभी भी खुला है और किसी को सौंपा नहीं गया है, पुष्टि करें कि डिपेंडेंसी की शर्तें अब भी पूरी हैं, फिर एक ही ट्रांज़ैक्शन में अपडेट करें। अगर दो वर्कर एक ही इश्यू लेने की होड़ में हों, तो एक सफल होता है और दूसरे को False वापस मिलता है।
बैकएंड एब्स्ट्रैक्शन
इस हिस्से से मैं सबसे ज़्यादा संतुष्ट हूँ।
HiveBackend इंटरफ़ेस में लगभग 15 मेथड हैं, जो सेशन प्रबंधन (create_session, abort_session, get_session_status), संचार (send_message_async, get_messages, reply_permission) और इवेंट स्ट्रीमिंग (on(event_type, handler), connect_with_reconnect()) को संभालते हैं।
ऑर्केस्ट्रेटर को इससे फ़र्क़ नहीं पड़ता कि कौन-सा बैकएंड चल रहा है; वह बस इंटरफ़ेस को कॉल करता है।
यह क्यों मायने रखता है? अग्रणी SOTA मॉडलों में पहले स्थान पर रहने वाला मॉडल हर कुछ महीनों में बदल जाता है। और यह स्पष्ट नहीं है कि अलग-अलग मॉडल अलग-अलग CLI रैपर के साथ कैसे काम करते हैं (मैंने सुना है कि Claude Code में GPT 5.4 काफ़ी अच्छा है)। मॉडल और हार्नेस, दोनों से स्वतंत्र होने का मतलब है कि बाकी सब कुछ तेज़ी से बदलने पर भी मुख्य ऑर्केस्ट्रेशन कोड को बदलने की ज़रूरत नहीं पड़ती।
मर्ज पाइपलाइन
जब कोई वर्कर किसी इश्यू का काम पूरा कर लेता है, तो वह काम मर्ज पाइपलाइन में जाता है।
मर्ज का काम "Refinery" नाम का एक समर्पित Claude सेशन संभालता है। Refinery को कॉन्फ़्लिक्ट का संदर्भ या टेस्ट आउटपुट मिलता है, वह समस्या सुलझाता है और एक संरचित परिणाम फ़ाइल लिखता है। वह काम मर्ज कर सकता है (कॉन्फ़्लिक्ट सुलझ गया, टेस्ट पास हो रहे हैं), उसे अस्वीकार कर सकता है (दोबारा काम करने के लिए उसे open में वापस भेज सकता है), या मामला किसी इंसान को सौंप सकता है (बहुत जटिल या अस्पष्ट होने पर)।
हर प्रोजेक्ट के लिए Refinery एक लंबे समय तक चलने वाला सेशन है, जिसे कई मर्ज ऑपरेशन में दोबारा इस्तेमाल किया जाता है। जब इसमें बहुत ज़्यादा कॉन्टेक्स्ट जमा हो जाता है (>100k टोकन या >20 संदेश), तो hive उसे ताज़ा रखने के लिए पुराने सेशन की जगह नया सेशन शुरू करता है। हर प्रोजेक्ट को अपना MergeProcessor मिलता है, इसलिए कई प्रोजेक्ट के ऑर्केस्ट्रेशन से अलग-अलग प्रोजेक्ट के मर्ज एक-दूसरे के आड़े नहीं आते।
एजेंटों के बीच ज्ञान का आदान-प्रदान
काम करते समय वर्कर .hive-notes.jsonl लिखते हैं:
{"category": "discovery", "content": "postgres dependency in main.py requires PGHOST to be set"}
{"category": "gotcha", "content": "tests require PYTHONPATH=src/"}
जब किसी वर्कर का काम पूरा हो जाता है, तो hive उसके नोट्स इकट्ठा करके डेटाबेस में रखता है। किसी संबंधित इश्यू (उसी एपिक, उसी प्रोजेक्ट का) पर नया वर्कर शुरू करते समय hive संबंधित साथी वर्करों के नोट्स प्रॉम्प्ट में जोड़ देता है।
इसका मतलब है कि अगर एजेंट #1 को पता चलता है कि टेस्ट सूट के लिए कोई ख़ास एनवायरनमेंट वेरिएबल चाहिए, तो एजेंट #3 (जो किसी संबंधित काम पर लगा है) को यह बात शुरू करने से पहले ही पता होगी। एजेंटों के पूरे समूह में ज्ञान जमा होता जाता है और किसी एक एजेंट को यह सब अपने कॉन्टेक्स्ट में रखने की ज़रूरत नहीं पड़ती।
क्वीन
क्वीन, hive से संवाद करने का मुख्य माध्यम है।
यह आपके टर्मिनल में चलने वाला Claude सेशन है (TUI मोड)।
आप उसे एक स्पेसिफ़िकेशन देते हैं, फिर वह कोडबेस की छानबीन करती है, प्रोजेक्ट के बारे में जमा जानकारी के लिए .hive/project-context.md पढ़ती है, काम को आपसी निर्भरताओं वाले इश्यू में बाँटने का प्रस्ताव देती है, आपकी मंज़ूरी का इंतज़ार करती है और फिर इश्यू बनाकर डेमन शुरू कर देती है।
स्क्रिप्टिंग के लिए एक हेडलेस मोड भी है:
hive queen --headless -p "Bump all dependencies and update the lockfile"
क्वीन के ज़रिए आप अलग-अलग एजेंटों को दिशा देने से आगे बढ़कर पूरे प्रोजेक्ट का प्रबंधन करते हैं। आप इस बारे में सोचते हैं कि क्या होना चाहिए और उसे हिस्सों में कैसे बाँटा जाए।
कॉन्फ़िगरेशन और बदलाव की सुविधा
Hive कॉन्फ़िगरेशन के लिए 4 स्तरों वाला स्टैक इस्तेमाल करता है: बिल्ट-इन डिफ़ॉल्ट मान → ग्लोबल TOML (~/.hive/config.toml) → प्रोजेक्ट TOML (.hive.toml) → एनवायरनमेंट वेरिएबल। दिलचस्प सेटिंग:
| सेटिंग | डिफ़ॉल्ट | यह क्या नियंत्रित करती है |
|---|---|---|
max_agents |
3 | एक साथ काम करने वाले वर्कर |
worker_model |
claude-sonnet-4-6 | इम्प्लीमेंटेशन के लिए मॉडल |
refinery_model |
claude-opus-4-6 | मर्ज कॉन्फ़्लिक्ट के लिए मॉडल |
max_tokens_per_issue |
200,000 | हर इश्यू का टोकन बजट |
max_retries |
2 | एजेंट बदलने से पहले दोबारा कोशिशों की संख्या |
max_agent_switches |
2 | मामला आगे सौंपने से पहले एजेंट बदलने की संख्या |
backend |
claude | claude | codex |
test_command |
-- | मर्ज की अनुमति तय करने वाली टेस्ट कमांड |
मैंने क्या सीखा है
कोडबेस में Python कोड की लगभग 6,500 पंक्तियाँ हैं। इसे लोकल मशीन पर चलने, बहुत कम संसाधन इस्तेमाल करने और इतना सरल रखने के लिए डिज़ाइन किया गया है कि आप एक दोपहर में पूरा कोड पढ़ सकें और उसमें बदलाव करना शुरू कर सकें।
Hive पर काम करते समय मैंने कुछ बातें सीखीं:
SQLite इसके लिए सही डेटाबेस है। WAL मोड में लिखते समय भी साथ-साथ पढ़ा जा सकता है और busy_timeout प्रैग्मा लॉक पाने की होड़ को सहजता से संभालता है। आप पूरी समन्वय परत सिर्फ़ SQL क्वेरी से बना सकते हैं। एक साथ काम करने वाले 3-20 एजेंटों के लिए SQLite ज़रूरत से ज़्यादा सक्षम है, और इसे चलाने व संभालने की सरलता बहुत मायने रखती है।
Git worktrees को अब भी कम आँका जाता है। हर एजेंट को रेपो का अपना worktree मिलता है, जिसकी ब्रांच main से निकलती है। वे एक-दूसरे की फ़ाइलों में दखल नहीं दे सकते, और जब काम पूरा हो जाता है, तो आप रीबेस करके मर्ज कर देते हैं। इसके विफल होने पर आप worktree हटा देते हैं। अलगाव पूरी तरह बना रहता है और सफ़ाई करना बहुत आसान है।
नोट्स सिस्टम को लेकर मैं अभी भी अनिश्चित हूँ। यह बात तर्कसंगत लगती है कि कोडबेस के बारे में नई बातें पता लगाने वाले एजेंट जब अपने साथी एजेंटों से ये बातें साझा करें, तो संबंधित कामों की विफलता दर में उल्लेखनीय कमी आनी चाहिए। लेकिन ऐसे काम और बेंचमार्क तैयार करना मुश्किल है जो इसे सटीक रूप से माप सकें। भविष्य में इस पर काफ़ी काम किया जाना चाहिए।
कोड github.com/nwyin/hive पर है। यह MIT लाइसेंस के तहत उपलब्ध है और इसे फ़ोर्क करके इसमें बदलाव करने के उद्देश्य से बनाया गया है। अगर आप tmux में 3 या अधिक एजेंट संभाल रहे हैं और कोई अधिक व्यवस्थित तरीका चाहते हैं, तो इस पर नज़र डालें।