contenuto
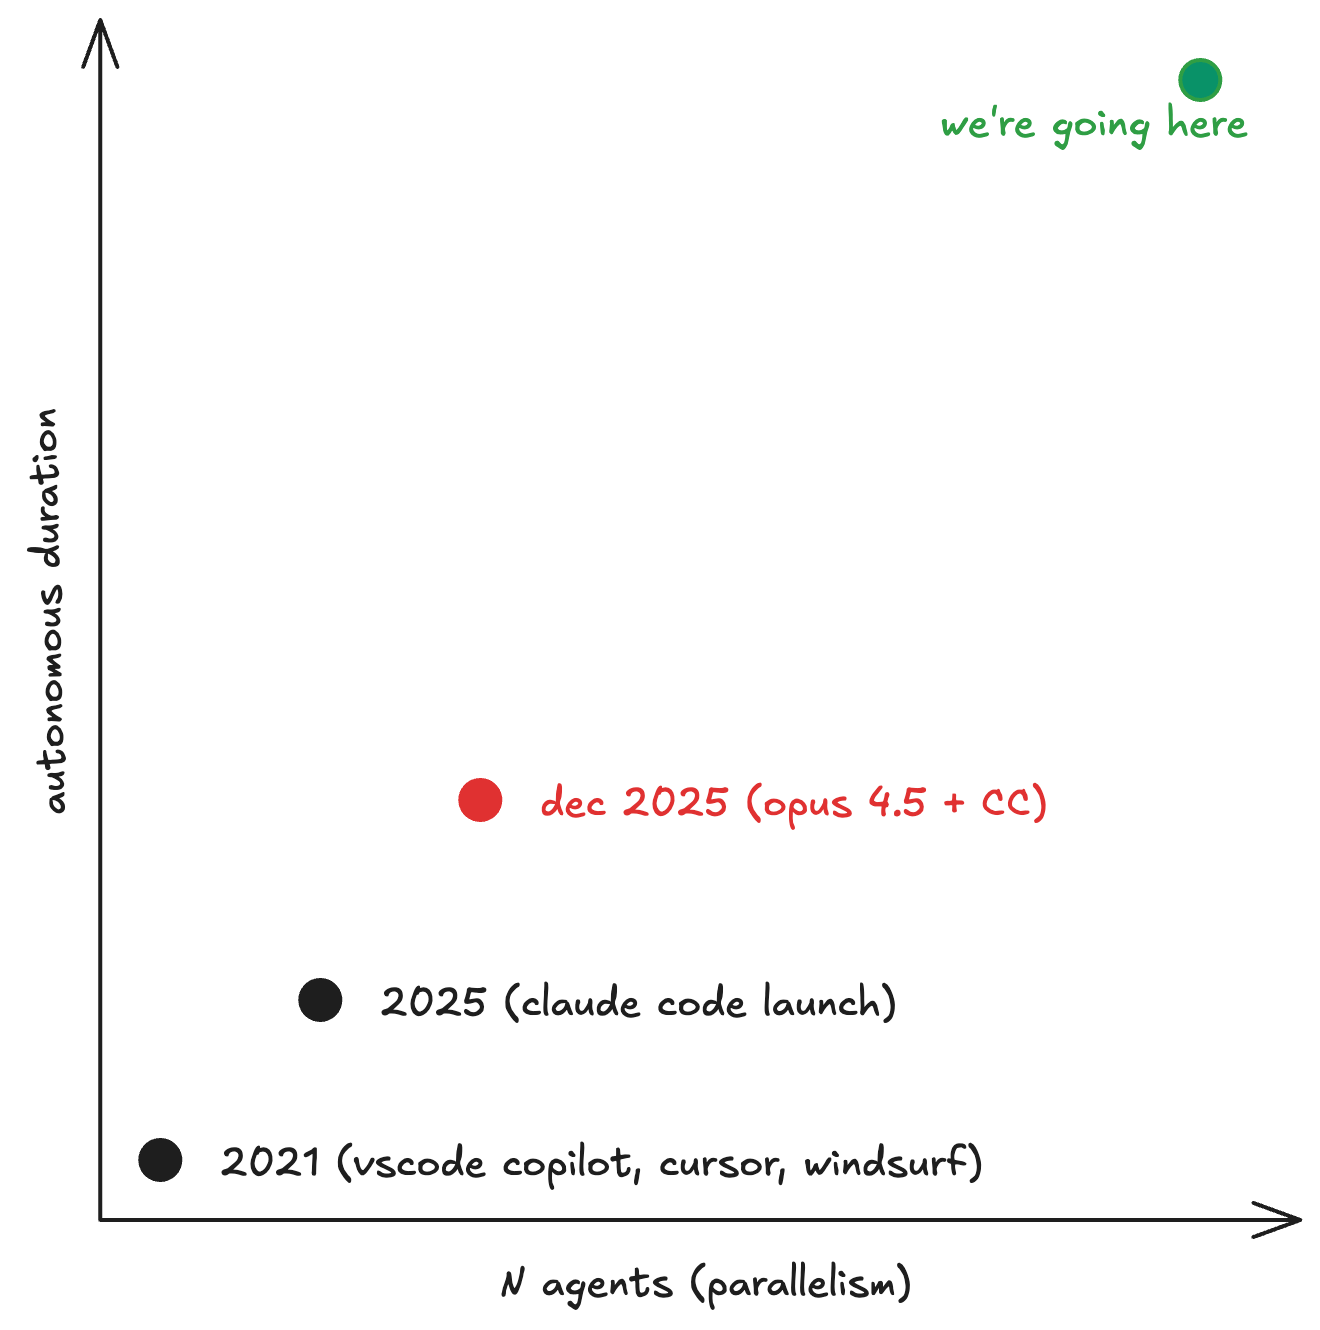
Il 2025 è stato l'anno degli agenti. Claude Code ha reso il lavoro con gli LLM simile al pair programming con uno sviluppatore junior molto abile ma inesperto. A un certo punto, nel dicembre 2025, con l'uscita di Opus 4.5, si è cominciato a notare un netto salto di capacità. Claude riusciva a lavorare da solo per ore di seguito.
Il passo successivo più ovvio è tmux molte istanze di Claude Code e farle lavorare su issue separate.
Questa pratica è diventata così comune che Anthropic ha iniziato a chiamarla "multi-Clauding".
Nella terminologia di Steve Yegge, questo corrisponde al livello 6/7 della programmazione con agenti.
tmux è fantastico, ma il carico cognitivo diventa pesantissimo.
Passi continuamente dall'ideazione alla guida degli agenti e alla revisione.
È chiaro che il collo di bottiglia sei tu e che il fatto di non riuscire a gestire più agenti è un "problema di competenze".
Deve pur esserci un modo migliore.
Così ho creato hive.
Che cos'è
Hive è un orchestratore asincrono in Python che gira in un unico processo e coordina più agenti di programmazione basati su LLM tramite una coda SQLite, usando i worktree Git come sandbox di esecuzione.
I componenti sono tre. La Queen è una sessione di Claude che fa da responsabile di progetto: descrivi il lavoro, lei esplora la codebase, propone una suddivisione in issue con dipendenze e aspetta la tua approvazione. I worker sono sessioni parallele di Claude (o Codex), ciascuna nel proprio worktree Git, che prelevano le issue dalla coda e le implementano. La pipeline di merge è un altro agente che esegue il rebase del lavoro completato, lo testa e ne fa il merge su main.
Il principio progettuale fondamentale: orchestrazione deterministica in Python, decisioni ambigue delegate alle sessioni LLM. Transizioni della macchina a stati, presa in carico, escalation? Python. Risoluzione dei conflitti, diagnosi dei test, scomposizione strategica? Claude.
Ecco il quadro completo:
You
  ├─ CLI / Queen (TUI)
  └─ Daemon (background)
       ↓
SQLite Database (~/.hive/hive.db)
  ├─ Issues (work queue)
  ├─ Dependencies (DAG)
  ├─ Agents (ephemeral identity)
  ├─ Events (audit trail)
  ├─ Notes (inter-agent knowledge)
  └─ Merge Queue
       ↓
Orchestrator (async event loop)
  ├─ Main Loop (spawn workers when slots open)
  ├─ Event Consumer (status updates from backends)
  └─ Merge Processor (per-project)
       ↓
Backend Pool
  ├─ Claude WS Backend (claude CLI via WebSocket)
  ├─ Codex App Server Backend (stdio protocol)
  └─ Tau Backend (testing)
       ↓
Workers (each in its own git worktree)
La macchina a stati
Ogni issue attraversa un ciclo di vita con 7 stati. Questa è la cosa più importante da capire di hive, perché ogni decisione progettuale deriva dalla necessità di mantenere corretta questa macchina a stati.
OPEN ──(claim)──→ IN_PROGRESS ──(success)──→ DONE ──(merge)──→ FINALIZED
  ↑                    │
  └──(retry/switch)────┘
                       │
                  (exhausted)──→ ESCALATED
                       │
                  (manual)─────→ CANCELED
La politica di escalation prevede una catena a tre livelli.
- Nuovo tentativo con lo stesso agente, fino a 2 tentativi. Magari il modello ha semplicemente avuto un'esecuzione sfortunata.
- Cambio di agente: un agente nuovo con un worktree pulito, fino a 2 cambi.
- Richiesta di intervento umano.
C'è anche un rilevatore di anomalie: 3 o più errori in un intervallo di 10 minuti fanno scattare un'escalation immediata, senza attendere l'esaurimento dei tentativi disponibili. Questo permette di individuare gli errori sistematici (suite di test non funzionante, dipendenza mancante, problemi del provider) prima che consumino token.
Prendere in carico il lavoro
La coda delle issue pronte è una query SQL che risolve il DAG delle dipendenze:
SELECT * FROM issues
WHERE status = 'open'
  AND assignee IS NULL
  AND type != 'epic'
  AND NOT EXISTS (
    SELECT 1 FROM dependencies d
    JOIN issues blocker ON d.depends_on = blocker.id
    WHERE d.issue_id = issues.id
      AND blocker.status NOT IN ('done', 'finalized', 'canceled')
  )
ORDER BY priority ASC, created_at ASC
Un'issue diventa "pronta" solo quando tutti i suoi blocchi sono stati risolti.
La presa in carico è un aggiornamento atomico di tipo CAS: verifica che l'issue sia ancora aperta e non assegnata, verifica che le dipendenze siano ancora soddisfatte, quindi esegue l'aggiornamento in un'unica transazione. Se due worker si contendono la stessa issue, uno vince e l'altro riceve False.
L'astrazione del backend
Questa è la parte che mi soddisfa di più.
L'interfaccia HiveBackend comprende circa 15 metodi che coprono la gestione delle sessioni (create_session, abort_session, get_session_status), la comunicazione (send_message_async, get_messages, reply_permission) e lo streaming degli eventi (on(event_type, handler), connect_with_reconnect()).
All'orchestratore non interessa quale backend sia in esecuzione; si limita a chiamare l'interfaccia.
Perché è importante? I modelli di frontiera allo stato dell'arte si alternano sul gradino più alto del podio ogni pochi mesi. E non è chiaro come i diversi modelli interagiscano con i vari wrapper CLI (sento dire che GPT 5.4 in Claude Code vada piuttosto bene). Essere indipendenti sia dal modello sia dall'harness significa che il codice centrale dell'orchestrazione non deve cambiare mentre tutto il resto evolve rapidamente.
La pipeline di merge
Quando un worker completa un'issue, il lavoro entra in una pipeline di merge.
I merge sono gestiti da una sessione di Claude dedicata, chiamata "Refinery". La Refinery riceve il contesto del conflitto o l'output dei test, risolve il problema e scrive un file di risultato strutturato. Può eseguire il merge del lavoro (conflitto risolto, test superati), rifiutarlo (rimandarlo a open perché venga rielaborato) oppure richiedere l'intervento di una persona (problema troppo complesso o ambiguo).
La Refinery è una sessione persistente per ciascun progetto, riutilizzata per più operazioni di merge. Quando accumula troppo contesto (>100k token o >20 messaggi), hive sostituisce la sessione per ripartire con un contesto nuovo. Ogni progetto ha il proprio MergeProcessor, così l'orchestrazione di più progetti non crea contesa sui merge tra progetti diversi.
Trasferimento di conoscenze tra agenti
I worker scrivono .hive-notes.jsonl durante l'esecuzione:
{"category": "discovery", "content": "postgres dependency in main.py requires PGHOST to be set"}
{"category": "gotcha", "content": "tests require PYTHONPATH=src/"}
Quando un worker termina, hive raccoglie le sue note e le memorizza nel database. Quando avvia un nuovo worker su un'issue correlata (stessa epic, stesso progetto), hive inserisce nel prompt le note pertinenti degli altri worker.
Questo significa che, se l'agente #1 scopre che la suite di test richiede una specifica variabile d'ambiente, l'agente #3 (che lavora su un'attività correlata) lo saprà prima ancora di iniziare. Le conoscenze si accumulano nello sciame senza che nessun agente debba tenerle tutte nel proprio contesto.
La Queen
La Queen è il principale punto di interazione con hive.
È una sessione di Claude in esecuzione nel tuo terminale (modalità TUI).
Le dai una specifica, poi esplora la codebase, legge .hive/project-context.md per accedere alle conoscenze accumulate sul progetto, propone una suddivisione in issue con dipendenze, aspetta la tua approvazione e infine crea le issue e avvia il demone.
C'è anche una modalità headless per l'uso negli script:
hive queen --headless -p "Bump all dependencies and update the lockfile"
La Queen ti permette di passare dalla guida dei singoli agenti alla gestione di un progetto. Pensi a cosa deve essere fatto e a come suddividerlo.
Configurazione e facilità di modifica
Hive usa uno stack di configurazione a 4 livelli: valori predefiniti integrati → TOML globale (~/.hive/config.toml) → TOML del progetto (.hive.toml) → variabili d'ambiente. I parametri più interessanti:
| Impostazione | Valore predefinito | Cosa controlla |
|---|---|---|
max_agents |
3 | Worker in esecuzione contemporaneamente |
worker_model |
claude-sonnet-4-6 | Modello per l'implementazione |
refinery_model |
claude-opus-4-6 | Modello per i conflitti di merge |
max_tokens_per_issue |
200.000 | Budget di token per issue |
max_retries |
2 | Nuovi tentativi prima del cambio di agente |
max_agent_switches |
2 | Cambi prima dell'escalation |
backend |
claude | claude | codex |
test_command |
-- | Comando di test da superare per il merge |
Cosa ho imparato
La codebase comprende circa 6.500 righe di Python. È pensata per funzionare in locale, usare risorse minime ed essere abbastanza semplice da poterla leggere tutta in un pomeriggio e iniziare a metterci mano.
Alcune cose che ho imparato lavorando su hive:
SQLite è il database giusto per questo. La modalità WAL consente letture concorrenti durante le scritture e il pragma busy_timeout gestisce senza intoppi la contesa sui lock. Puoi realizzare l'intero livello di coordinamento con sole query SQL. Con 3-20 agenti in esecuzione contemporaneamente, SQLite è più che sufficiente e la semplicità operativa vale molto.
I worktree Git sono ancora sottovalutati. Ogni agente ha il proprio worktree del repository, con un branch che parte da main. Non possono interferire con i file degli altri e, quando il lavoro è finito, esegui il rebase e il merge. Quando qualcosa va storto, elimini il worktree. L'isolamento è perfetto e la pulizia è banale.
Ho ancora dei dubbi sul sistema di note. È ragionevole aspettarsi che gli agenti, facendo scoperte sulla codebase e condividendole con gli altri agenti, riducano in modo significativo il tasso di fallimento nelle attività correlate. Ma è difficile progettare attività e benchmark che lo misurino con precisione. In futuro bisognerebbe dedicare molto lavoro a esplorare questo aspetto.
Il codice è su github.com/nwyin/hive. È distribuito con licenza MIT ed è pensato per crearne un fork e metterci mano. Se gestisci 3 o più agenti in tmux e vuoi qualcosa di più strutturato, dagli un'occhiata.