내용
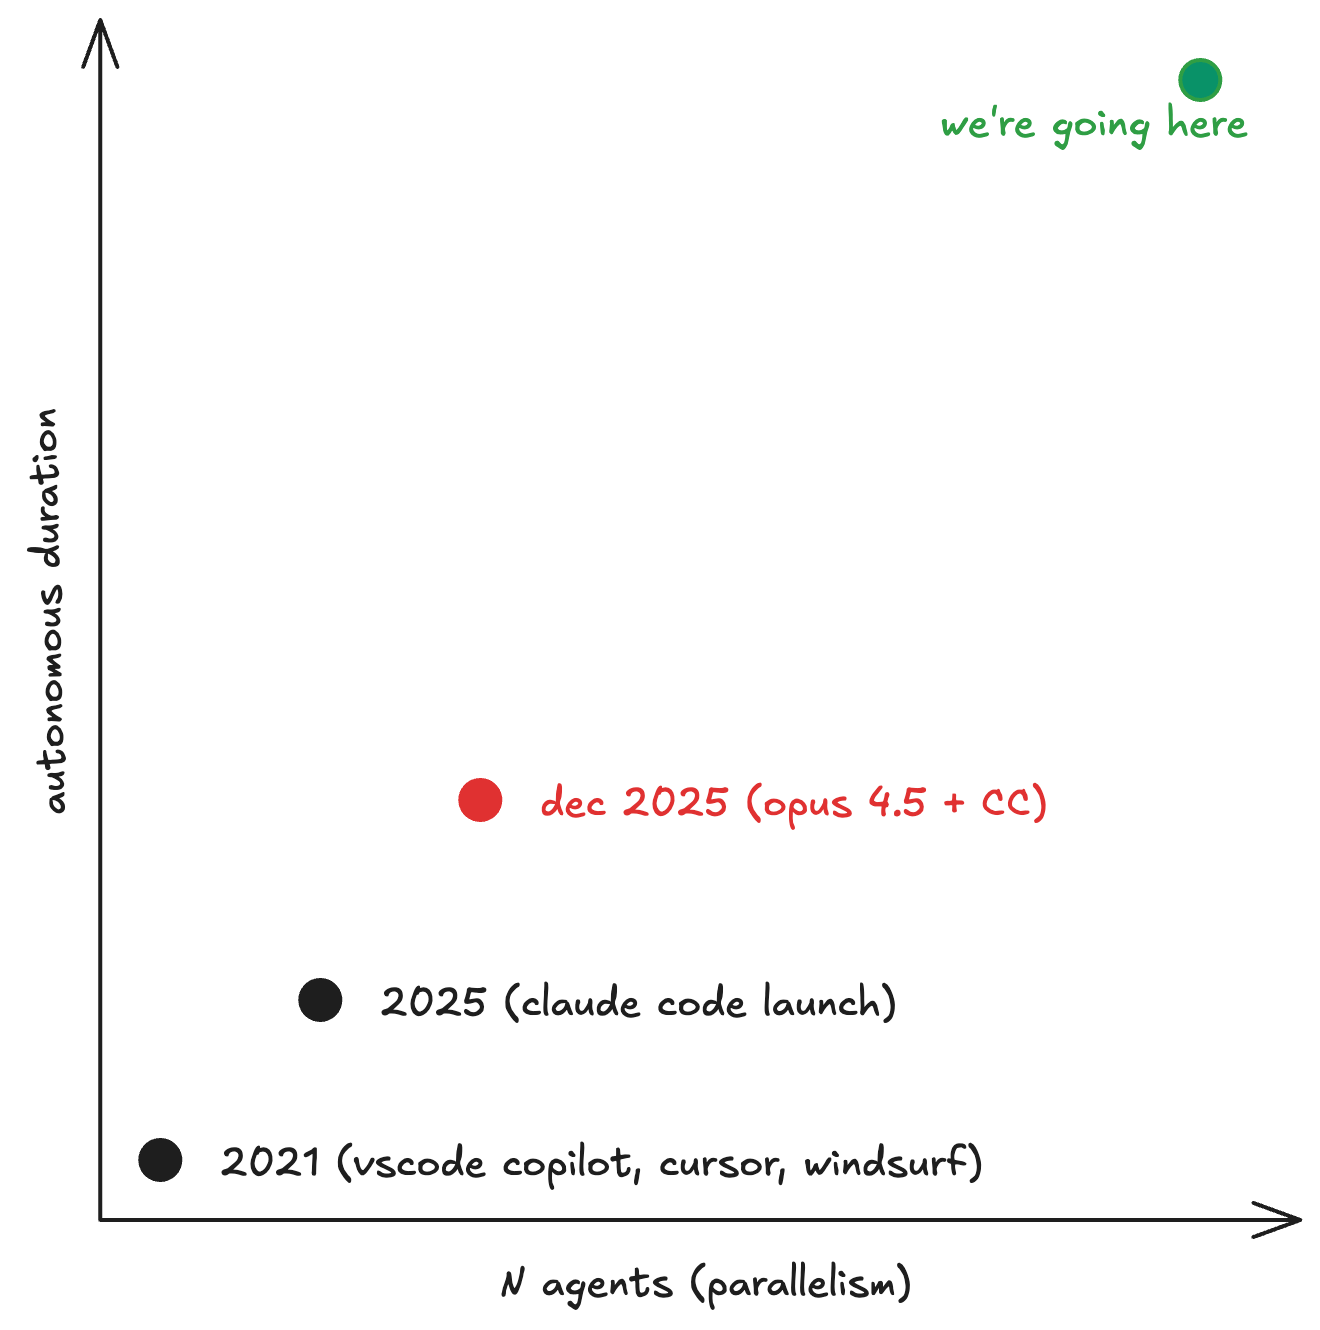
2025년은 에이전트의 해였다. Claude Code는 LLM과의 작업을 실력은 매우 뛰어나지만 경험은 부족한 주니어 개발자와 페어 프로그래밍을 하는 것과 비슷하게 바꿔 놓았다. 2025년 12월 어느 시점엔가 Opus 4.5가 출시되면서 역량이 한 단계 뛰어오른 것이 눈에 띄기 시작했다. Claude는 한 번에 몇 시간씩 혼자 작업할 수 있게 되었다.
다음 단계는 당연히 tmux로 여러 Claude Code 인스턴스를 띄워 각기 다른 이슈를 처리하게 하는 것이다.
이 방식이 워낙 흔해지자 Anthropic은 이를 "multi-Clauding"이라고 부르기 시작했다.
Steve Yegge의 표현을 빌리면, 이는 에이전트 기반 코딩의 6/7단계에 해당한다.
tmux도 훌륭하지만, 인지적 부담이 감당하기 힘들 정도로 커진다.
계속 아이디어를 내고, 방향을 잡아 주고, 결과를 검토하는 일을 오가게 된다.
자신이 병목이며, 더 많은 에이전트를 관리하지 못하는 것이 "실력 문제"라는 사실이 분명해진다.
분명 더 나은 방법이 있을 것이다.
그래서 나는 hive를 만들었다.
무엇인가
Hive는 Git 워크트리를 실행 샌드박스로 사용하고 SQLite 큐를 기반으로 여러 LLM 코딩 에이전트를 조율하는 단일 프로세스 비동기 Python 오케스트레이터다.
크게 세 부분으로 구성된다. Queen은 프로젝트 관리자 역할을 하는 Claude 세션이다. 할 일을 설명하면 코드베이스를 탐색하고, 의존성을 고려해 작업을 여러 이슈로 나누는 방안을 제안한 뒤 승인을 기다린다. 워커는 각자의 Git 워크트리에서 병렬로 실행되는 Claude(또는 Codex) 세션으로, 큐에서 이슈를 가져와 구현한다. 병합 파이프라인은 완료된 작업을 리베이스하고 테스트한 뒤 main에 병합하는 또 다른 에이전트다.
핵심 설계 원칙은 결정론적 오케스트레이션은 Python에서 처리하고, 모호한 판단은 LLM 세션에 맡기는 것이다. 상태 머신 전이, 작업 선점, 에스컬레이션은? Python. 충돌 해결, 테스트 문제 진단, 전략적인 작업 분해는? Claude.
전체 구조는 다음과 같다:
You
  ├─ CLI / Queen (TUI)
  └─ Daemon (background)
       ↓
SQLite Database (~/.hive/hive.db)
  ├─ Issues (work queue)
  ├─ Dependencies (DAG)
  ├─ Agents (ephemeral identity)
  ├─ Events (audit trail)
  ├─ Notes (inter-agent knowledge)
  └─ Merge Queue
       ↓
Orchestrator (async event loop)
  ├─ Main Loop (spawn workers when slots open)
  ├─ Event Consumer (status updates from backends)
  └─ Merge Processor (per-project)
       ↓
Backend Pool
  ├─ Claude WS Backend (claude CLI via WebSocket)
  ├─ Codex App Server Backend (stdio protocol)
  └─ Tau Backend (testing)
       ↓
Workers (each in its own git worktree)
상태 머신
모든 이슈는 7개 상태로 이루어진 수명 주기를 거친다. hive를 이해할 때 가장 중요한 부분은 이것이다. 모든 설계 결정이 이 상태 머신을 올바르게 유지한다는 원칙에서 나오기 때문이다.
OPEN ──(claim)──→ IN_PROGRESS ──(success)──→ DONE ──(merge)──→ FINALIZED
  ↑                    │
  └──(retry/switch)────┘
                       │
                  (exhausted)──→ ESCALATED
                       │
                  (manual)─────→ CANCELED
에스컬레이션 정책은 세 단계로 이루어진다.
- 같은 에이전트로 재시도하며, 시도 횟수는 최대 2회다. 모델이 그저 한 번 제대로 수행하지 못했을 수도 있다.
- 깨끗한 워크트리에서 새 에이전트로 교체한다. 교체는 최대 2회까지다.
- 사람에게 넘긴다.
이상 감지기도 있다. 10분 이내에 3회 이상 실패하면 재시도 한도를 건너뛰고 즉시 에스컬레이션한다. 이렇게 하면 구조적인 장애(고장 난 테스트 스위트, 누락된 의존성, 제공업체 문제)가 토큰을 소진하기 전에 포착된다.
작업 선점
실행 준비 큐는 의존성 DAG를 해석하는 SQL 쿼리다:
SELECT * FROM issues
WHERE status = 'open'
  AND assignee IS NULL
  AND type != 'epic'
  AND NOT EXISTS (
    SELECT 1 FROM dependencies d
    JOIN issues blocker ON d.depends_on = blocker.id
    WHERE d.issue_id = issues.id
      AND blocker.status NOT IN ('done', 'finalized', 'canceled')
  )
ORDER BY priority ASC, created_at ASC
이슈는 진행을 가로막는 모든 선행 이슈가 해결되어야만 "ready" 상태가 된다.
선점은 CAS 방식의 원자적 갱신으로 이루어진다. 이슈가 여전히 열려 있고 담당자가 없는지 확인하고, 의존성 조건이 여전히 충족되는지 확인한 다음, 하나의 트랜잭션 안에서 갱신한다. 두 워커가 같은 이슈를 두고 경쟁하면 한쪽이 선점하고 다른 쪽의 반환값은 False다.
백엔드 추상화
내가 가장 만족하는 부분이다.
HiveBackend 인터페이스는 세션 관리(create_session, abort_session, get_session_status), 통신(send_message_async, get_messages, reply_permission), 이벤트 스트리밍(on(event_type, handler), connect_with_reconnect())을 다루는 약 15개의 메서드로 이루어져 있다.
오케스트레이터는 어떤 백엔드가 실행 중인지 신경 쓰지 않고 인터페이스를 호출하기만 한다.
이것이 왜 중요할까? 최첨단 프런티어 모델들은 몇 달마다 1위 자리를 번갈아 차지한다. 게다가 모델마다 서로 다른 CLI 래퍼와 결합했을 때 어떻게 작동하는지도 확실하지 않다(Claude Code에서 GPT 5.4를 쓰면 꽤 좋다는 이야기를 들었다). 모델과 하네스 어느 쪽에도 종속되지 않으면, 나머지가 빠르게 발전해도 핵심 오케스트레이션 코드는 바꿀 필요가 없다.
병합 파이프라인
워커가 이슈를 완료하면 작업 결과는 병합 파이프라인으로 들어간다.
병합은 "Refinery"라는 전담 Claude 세션이 처리한다. Refinery는 충돌 관련 정보나 테스트 출력을 전달받아 문제를 해결하고, 구조화된 결과 파일을 작성한다. 작업을 병합하거나(충돌 해결, 테스트 통과), 거부하거나(재작업을 위해 open로 되돌림), 사람에게 넘길 수 있다(너무 복잡하거나 모호한 경우).
Refinery는 프로젝트마다 하나씩 유지되며 여러 병합 작업에서 재사용되는 장기 실행 세션이다. 컨텍스트가 너무 많이 쌓이면(토큰 10만 개 초과 또는 메시지 20개 초과) hive는 세션을 교체해 새로 시작한다. 각 프로젝트에는 자체 MergeProcessor가 있으므로 여러 프로젝트를 오케스트레이션해도 프로젝트 간 병합 경합이 발생하지 않는다.
에이전트 간 지식 전달
워커는 실행 중에 .hive-notes.jsonl를 작성한다:
{"category": "discovery", "content": "postgres dependency in main.py requires PGHOST to be set"}
{"category": "gotcha", "content": "tests require PYTHONPATH=src/"}
워커가 작업을 마치면 hive는 노트를 수집해 데이터베이스에 저장한다. 관련 이슈(같은 에픽, 같은 프로젝트)를 처리할 새 워커를 실행할 때는 관련된 다른 이슈의 노트를 프롬프트에 넣는다.
따라서 1번 에이전트가 테스트 스위트에 특정 환경 변수가 필요하다는 사실을 발견하면, 관련 작업을 하는 3번 에이전트는 시작 전부터 그 사실을 알게 된다. 어떤 에이전트도 모든 지식을 컨텍스트에 담아 둘 필요 없이 에이전트 집단 전체에 지식이 축적된다.
Queen
Queen은 hive와 상호작용하는 주된 창구다.
터미널에서 실행되는 Claude 세션이다(TUI 모드).
명세를 주면 코드베이스를 탐색하고, 축적된 프로젝트 지식을 얻기 위해 .hive/project-context.md를 읽고, 의존성을 고려해 작업을 여러 이슈로 나누는 방안을 제안한 뒤 승인을 기다린다. 이후 이슈를 생성하고 데몬을 실행한다.
스크립트에서 사용할 수 있는 헤드리스 모드도 있다:
hive queen --headless -p "Bump all dependencies and update the lockfile"
Queen을 통해 개별 에이전트의 방향을 잡아 주는 데서 프로젝트를 관리하는 것으로 전환할 수 있다. 무엇을 해야 하고 어떻게 나눌지 생각하면 된다.
설정과 수정 용이성
Hive는 4단계 설정 체계를 사용한다: 내장 기본값 → 전역 TOML (~/.hive/config.toml) → 프로젝트 TOML (.hive.toml) → 환경 변수. 눈여겨볼 설정은 다음과 같다:
| 설정 | 기본값 | 제어하는 항목 |
|---|---|---|
max_agents |
3 | 동시 실행 워커 수 |
worker_model |
claude-sonnet-4-6 | 구현에 사용할 모델 |
refinery_model |
claude-opus-4-6 | 병합 충돌 해결에 사용할 모델 |
max_tokens_per_issue |
200,000 | 이슈별 토큰 예산 |
max_retries |
2 | 에이전트 교체 전 재시도 횟수 |
max_agent_switches |
2 | 에스컬레이션 전 교체 횟수 |
backend |
claude | claude | codex |
test_command |
-- | 병합 허용 여부를 확인할 테스트 명령 |
배운 점
코드베이스는 약 6,500줄의 Python 코드로 이루어져 있다. 로컬에서 실행되고 자원을 최소한으로 사용하며, 오후 한나절이면 전체를 읽고 수정을 시작할 수 있을 만큼 단순하도록 설계했다.
hive를 만들면서 배운 점은 다음과 같다:
SQLite는 이 용도에 딱 맞는 데이터베이스다. WAL 모드에서는 쓰기가 진행되는 동안에도 동시에 읽을 수 있고, busy_timeout 프라그마는 잠금 경합을 매끄럽게 처리한다. 조율 계층 전체를 SQL 쿼리만으로 구현할 수 있다. 에이전트 3~20개를 동시에 실행하는 데는 SQLite로 충분하고도 남으며, 운영이 단순하다는 점도 큰 가치가 있다.
Git 워크트리는 여전히 저평가되어 있다. 각 에이전트는 main에서 분기한 해당 저장소의 워크트리를 하나씩 갖는다. 서로의 파일을 건드릴 수 없고, 작업이 끝나면 리베이스한 뒤 병합하면 된다. 실패하면 워크트리를 삭제하면 된다. 격리는 완벽하고 정리도 간단하다.
노트 시스템에 대해서는 아직 확신이 없다. 에이전트가 코드베이스에 관해 알아낸 것을 동료 에이전트와 공유하면 관련 작업의 실패율이 유의미하게 줄어들 것이라는 생각은 타당하다. 하지만 이를 정확하게 측정할 수 있는 작업과 벤치마크를 설계하기는 어렵다. 앞으로 많은 후속 작업에서 탐구해야 할 부분이다.
코드는 github.com/nwyin/hive에서 볼 수 있다. MIT 라이선스로 공개되어 있으며, 포크하고 자유롭게 수정할 수 있도록 설계했다. tmux에서 에이전트를 3개 이상 관리하고 있고 좀 더 체계적인 도구를 원한다면 한번 살펴보길 바란다.