nội dung
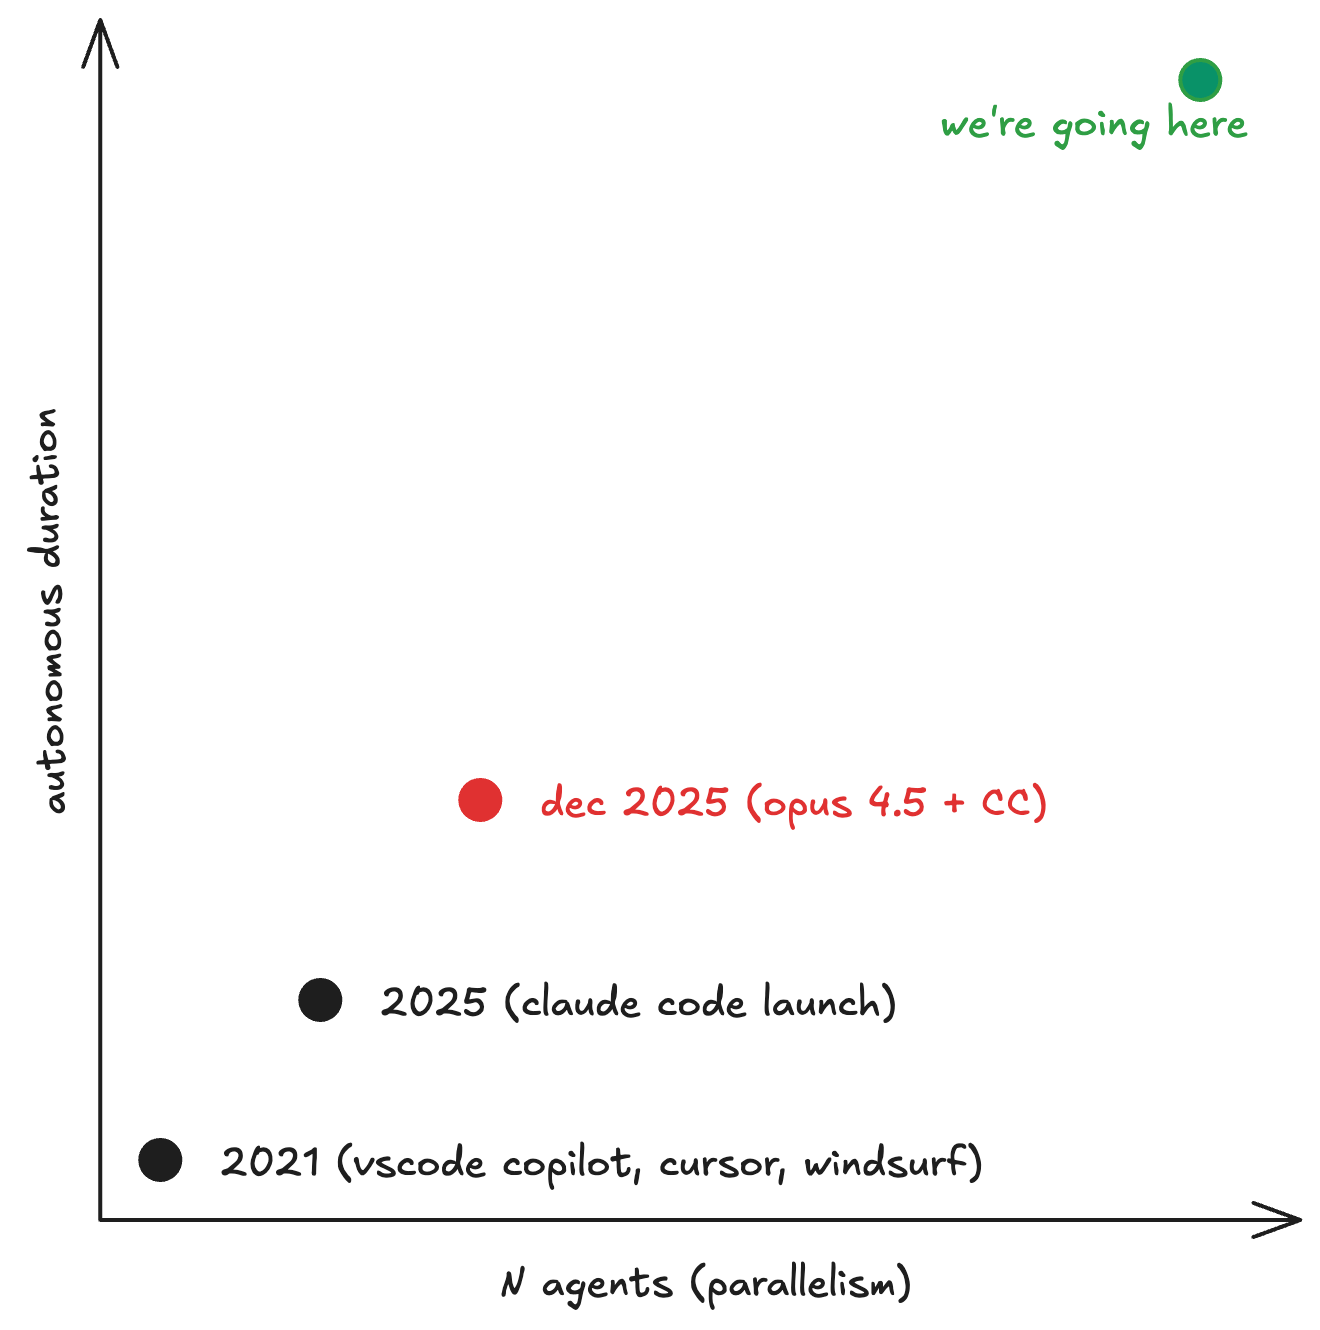
2025 là năm của các agent. Claude Code khiến việc làm việc với LLM trở nên giống như lập trình cặp cùng một lập trình viên junior rất giỏi nhưng còn thiếu kinh nghiệm. Vào một thời điểm trong tháng 12/2025, khi Opus 4.5 ra mắt, một bước nhảy về năng lực bắt đầu trở nên rõ rệt. Claude có thể tự làm việc liên tục hàng giờ liền.
Bước tiếp theo hiển nhiên là tmux nhiều phiên Claude Code và để chúng xử lý các issue riêng biệt.
Cách làm này trở nên phổ biến đến mức Anthropic bắt đầu gọi nó là "multi-Clauding".
Theo cách gọi của Steve Yegge, đây là cấp độ 6/7 của việc lập trình bằng agent.
tmux rất hay, nhưng gánh nặng nhận thức trở nên quá sức.
Bạn liên tục phải chuyển qua lại giữa việc lên ý tưởng, định hướng và rà soát.
Rõ ràng bạn là nút thắt cổ chai, và việc bạn không thể quản lý thêm agent là một "vấn đề kỹ năng".
Hẳn phải có cách tốt hơn.
Thế là tôi xây dựng hive.
Hive là gì
Hive là một bộ điều phối Python bất đồng bộ chạy trong một tiến trình, phối hợp nhiều agent lập trình LLM thông qua một hàng đợi SQLite và dùng các worktree Git làm môi trường thực thi biệt lập.
Hệ thống có ba thành phần hoạt động. Nữ hoàng là một phiên Claude đóng vai trò quản lý dự án của bạn: bạn mô tả công việc, cô ấy khám phá mã nguồn, đề xuất cách chia nhỏ công việc thành các issue có quan hệ phụ thuộc, rồi chờ bạn phê duyệt. Worker là các phiên Claude (hoặc Codex) chạy song song, mỗi phiên ở trong một worktree Git riêng, nhận các issue từ hàng đợi và triển khai chúng. Quy trình hợp nhất là một agent khác, thực hiện rebase, kiểm thử và hợp nhất phần việc đã hoàn thành trở lại nhánh main.
Nguyên tắc thiết kế cốt lõi: điều phối có tính xác định bằng Python, giao những quyết định còn mơ hồ cho các phiên LLM. Chuyển trạng thái trong máy trạng thái, nhận việc, chuyển cấp xử lý? Python. Giải quyết xung đột, chẩn đoán lỗi kiểm thử, chia nhỏ công việc ở cấp chiến lược? Claude.
Đây là bức tranh toàn cảnh:
You
  ├─ CLI / Queen (TUI)
  └─ Daemon (background)
       ↓
SQLite Database (~/.hive/hive.db)
  ├─ Issues (work queue)
  ├─ Dependencies (DAG)
  ├─ Agents (ephemeral identity)
  ├─ Events (audit trail)
  ├─ Notes (inter-agent knowledge)
  └─ Merge Queue
       ↓
Orchestrator (async event loop)
  ├─ Main Loop (spawn workers when slots open)
  ├─ Event Consumer (status updates from backends)
  └─ Merge Processor (per-project)
       ↓
Backend Pool
  ├─ Claude WS Backend (claude CLI via WebSocket)
  ├─ Codex App Server Backend (stdio protocol)
  └─ Tau Backend (testing)
       ↓
Workers (each in its own git worktree)
Máy trạng thái
Mỗi issue trải qua một vòng đời gồm 7 trạng thái. Đây là điều quan trọng nhất cần hiểu về hive, vì mọi quyết định thiết kế đều xuất phát từ yêu cầu giữ cho máy trạng thái này hoạt động chính xác.
OPEN ──(claim)──→ IN_PROGRESS ──(success)──→ DONE ──(merge)──→ FINALIZED
  ↑                    │
  └──(retry/switch)────┘
                       │
                  (exhausted)──→ ESCALATED
                       │
                  (manual)─────→ CANCELED
Chính sách chuyển cấp xử lý là một chuỗi gồm ba cấp.
- Thử lại với cùng agent, tối đa 2 lần thử. Có thể mô hình vừa có một lượt chạy không tốt.
- Đổi agent, dùng một agent mới với worktree sạch, tối đa 2 lần đổi.
- Chuyển cho con người xử lý.
Ngoài ra còn có bộ phát hiện bất thường: từ 3 lần thất bại trở lên trong khoảng 10 phút sẽ kích hoạt việc chuyển cấp xử lý ngay lập tức, bỏ qua giới hạn số lượt thử lại. Cơ chế này phát hiện các lỗi mang tính hệ thống (bộ kiểm thử bị hỏng, thiếu thành phần phụ thuộc, sự cố từ nhà cung cấp) trước khi chúng tiêu tốn quá nhiều token.
Nhận việc
Hàng đợi công việc sẵn sàng là một truy vấn SQL xác định các công việc có thể thực hiện dựa trên DAG phụ thuộc:
SELECT * FROM issues
WHERE status = 'open'
  AND assignee IS NULL
  AND type != 'epic'
  AND NOT EXISTS (
    SELECT 1 FROM dependencies d
    JOIN issues blocker ON d.depends_on = blocker.id
    WHERE d.issue_id = issues.id
      AND blocker.status NOT IN ('done', 'finalized', 'canceled')
  )
ORDER BY priority ASC, created_at ASC
Một issue chỉ trở nên "sẵn sàng" khi mọi yếu tố chặn nó đều đã được giải quyết.
Việc nhận việc là một phép cập nhật nguyên tử theo kiểu CAS: xác minh issue vẫn đang mở và chưa được giao cho ai, xác minh các điều kiện phụ thuộc vẫn được đáp ứng, rồi cập nhật trong một giao dịch duy nhất. Nếu hai worker tranh nhau nhận cùng một issue, một worker sẽ thắng và worker còn lại nhận lại False.
Lớp trừu tượng hóa backend
Đây là phần tôi hài lòng nhất.
Giao diện HiveBackend có khoảng 15 phương thức, bao gồm quản lý phiên (create_session, abort_session, get_session_status), giao tiếp (send_message_async, get_messages, reply_permission) và truyền luồng sự kiện (on(event_type, handler), connect_with_reconnect()).
Bộ điều phối không quan tâm backend nào đang chạy; nó chỉ gọi giao diện đó.
Vì sao điều này quan trọng? Các mô hình tiên tiến nhất (SOTA) thay nhau giữ ngôi đầu sau mỗi vài tháng. Và vẫn chưa rõ các mô hình khác nhau tương tác thế nào với các lớp bọc CLI khác nhau (tôi nghe nói GPT 5.4 chạy trong Claude Code khá tốt). Việc không phụ thuộc vào cả mô hình lẫn bộ khung vận hành agent giúp mã điều phối cốt lõi không cần thay đổi khi mọi thành phần khác liên tục được cải tiến với tốc độ nhanh.
Quy trình hợp nhất
Khi một worker hoàn thành một issue, phần việc đó được đưa vào quy trình hợp nhất.
Việc hợp nhất được xử lý bởi một phiên Claude chuyên trách có tên "Refinery". Refinery nhận ngữ cảnh xung đột hoặc đầu ra kiểm thử, giải quyết vấn đề và ghi một tệp kết quả có cấu trúc. Nó có thể hợp nhất phần việc đó (đã giải quyết xung đột, các kiểm thử đều đạt), từ chối (gửi lại về open để làm lại), hoặc chuyển cho con người xử lý (quá phức tạp hoặc mơ hồ).
Refinery là một phiên tồn tại lâu dài cho từng dự án, được tái sử dụng qua nhiều lần hợp nhất. Khi phiên tích lũy quá nhiều ngữ cảnh (>100k token hoặc >20 tin nhắn), hive thay bằng một phiên mới để giữ ngữ cảnh gọn gàng. Mỗi dự án có MergeProcessor riêng, nên việc điều phối nhiều dự án không gây ra tranh chấp hợp nhất giữa các dự án.
Chuyển giao kiến thức giữa các agent
Các worker ghi .hive-notes.jsonl trong quá trình thực thi:
{"category": "discovery", "content": "postgres dependency in main.py requires PGHOST to be set"}
{"category": "gotcha", "content": "tests require PYTHONPATH=src/"}
Khi một worker hoàn thành công việc, hive thu thập ghi chú của nó và lưu vào cơ sở dữ liệu. Khi khởi tạo một worker mới cho một issue liên quan (cùng epic, cùng dự án), hive đưa những ghi chú liên quan từ các worker ngang hàng vào prompt.
Điều này có nghĩa là nếu agent #1 phát hiện bộ kiểm thử cần một biến môi trường cụ thể, agent #3 (đang xử lý một tác vụ liên quan) sẽ biết điều đó trước khi bắt đầu. Kiến thức được tích lũy trên toàn bộ nhóm agent mà không agent nào cần giữ tất cả trong ngữ cảnh của mình.
Nữ hoàng
Nữ hoàng là đầu mối tương tác chính với hive.
Đó là một phiên Claude chạy trong terminal của bạn (chế độ TUI).
Bạn cung cấp bản đặc tả, rồi phiên này khám phá mã nguồn, đọc .hive/project-context.md để nắm kiến thức đã tích lũy về dự án, đề xuất cách chia nhỏ công việc thành các issue có quan hệ phụ thuộc, chờ bạn phê duyệt, sau đó tạo các issue và khởi chạy daemon.
Ngoài ra còn có chế độ không giao diện để dùng trong script:
hive queen --headless -p "Bump all dependencies and update the lockfile"
Nữ hoàng giúp bạn chuyển từ việc định hướng từng agent sang quản lý cả một dự án. Bạn suy nghĩ về những gì cần làm và cách chia nhỏ công việc.
Cấu hình và khả năng tùy biến
Hive sử dụng cấu hình 4 lớp: giá trị mặc định tích hợp sẵn → TOML toàn cục (~/.hive/config.toml) → TOML của dự án (.hive.toml) → biến môi trường. Một số tùy chọn đáng chú ý:
| Thiết lập | Mặc định | Chức năng điều khiển |
|---|---|---|
max_agents |
3 | Số worker chạy đồng thời |
worker_model |
claude-sonnet-4-6 | Mô hình dùng để triển khai |
refinery_model |
claude-opus-4-6 | Mô hình xử lý xung đột hợp nhất |
max_tokens_per_issue |
200,000 | Ngân sách token cho mỗi issue |
max_retries |
2 | Số lần thử lại trước khi đổi agent |
max_agent_switches |
2 | Số lần đổi agent trước khi chuyển cấp xử lý |
backend |
claude | claude | codex |
test_command |
-- | Lệnh kiểm thử làm điều kiện cho phép hợp nhất |
Những điều tôi đã học được
Mã nguồn gồm khoảng 6.500 dòng Python. Hệ thống được thiết kế để chạy cục bộ, dùng ít tài nguyên nhất có thể và đủ đơn giản để bạn đọc hết trong một buổi chiều rồi bắt đầu sửa đổi.
Một số điều tôi học được khi phát triển hive:
SQLite là cơ sở dữ liệu phù hợp cho việc này. Chế độ WAL cho phép đọc đồng thời trong khi ghi, còn pragma busy_timeout xử lý êm việc tranh chấp khóa. Bạn có thể xây dựng toàn bộ lớp phối hợp chỉ bằng các truy vấn SQL. Với 3-20 agent chạy đồng thời, SQLite là quá đủ, và sự đơn giản trong vận hành có giá trị rất lớn.
Worktree Git vẫn chưa được đánh giá đúng mức. Mỗi agent có một worktree riêng của kho mã, với nhánh được tách từ main. Chúng không thể ghi đè lên tệp của nhau, và khi công việc hoàn tất, bạn thực hiện rebase rồi hợp nhất. Khi công việc thất bại, bạn xóa worktree đó. Khả năng cô lập là hoàn hảo và việc dọn dẹp hết sức đơn giản.
Tôi vẫn chưa chắc chắn về hệ thống ghi chú. Việc các agent khám phá những điều về mã nguồn rồi chia sẻ những phát hiện đó với các agent ngang hàng có vẻ hợp lý và đáng ra phải giúp giảm đáng kể tỷ lệ thất bại ở những tác vụ liên quan. Nhưng rất khó thiết kế các tác vụ và bộ đánh giá chuẩn để đo lường chính xác điều này. Đây là điều cần được nghiên cứu nhiều hơn trong tương lai.
Mã nguồn nằm tại github.com/nwyin/hive. Mã được phát hành theo giấy phép MIT và được thiết kế để mọi người có thể fork và tùy biến. Nếu bạn đang quản lý từ 3 agent trở lên trong tmux và muốn một công cụ có tổ chức hơn, hãy xem thử.