เนื้อหา
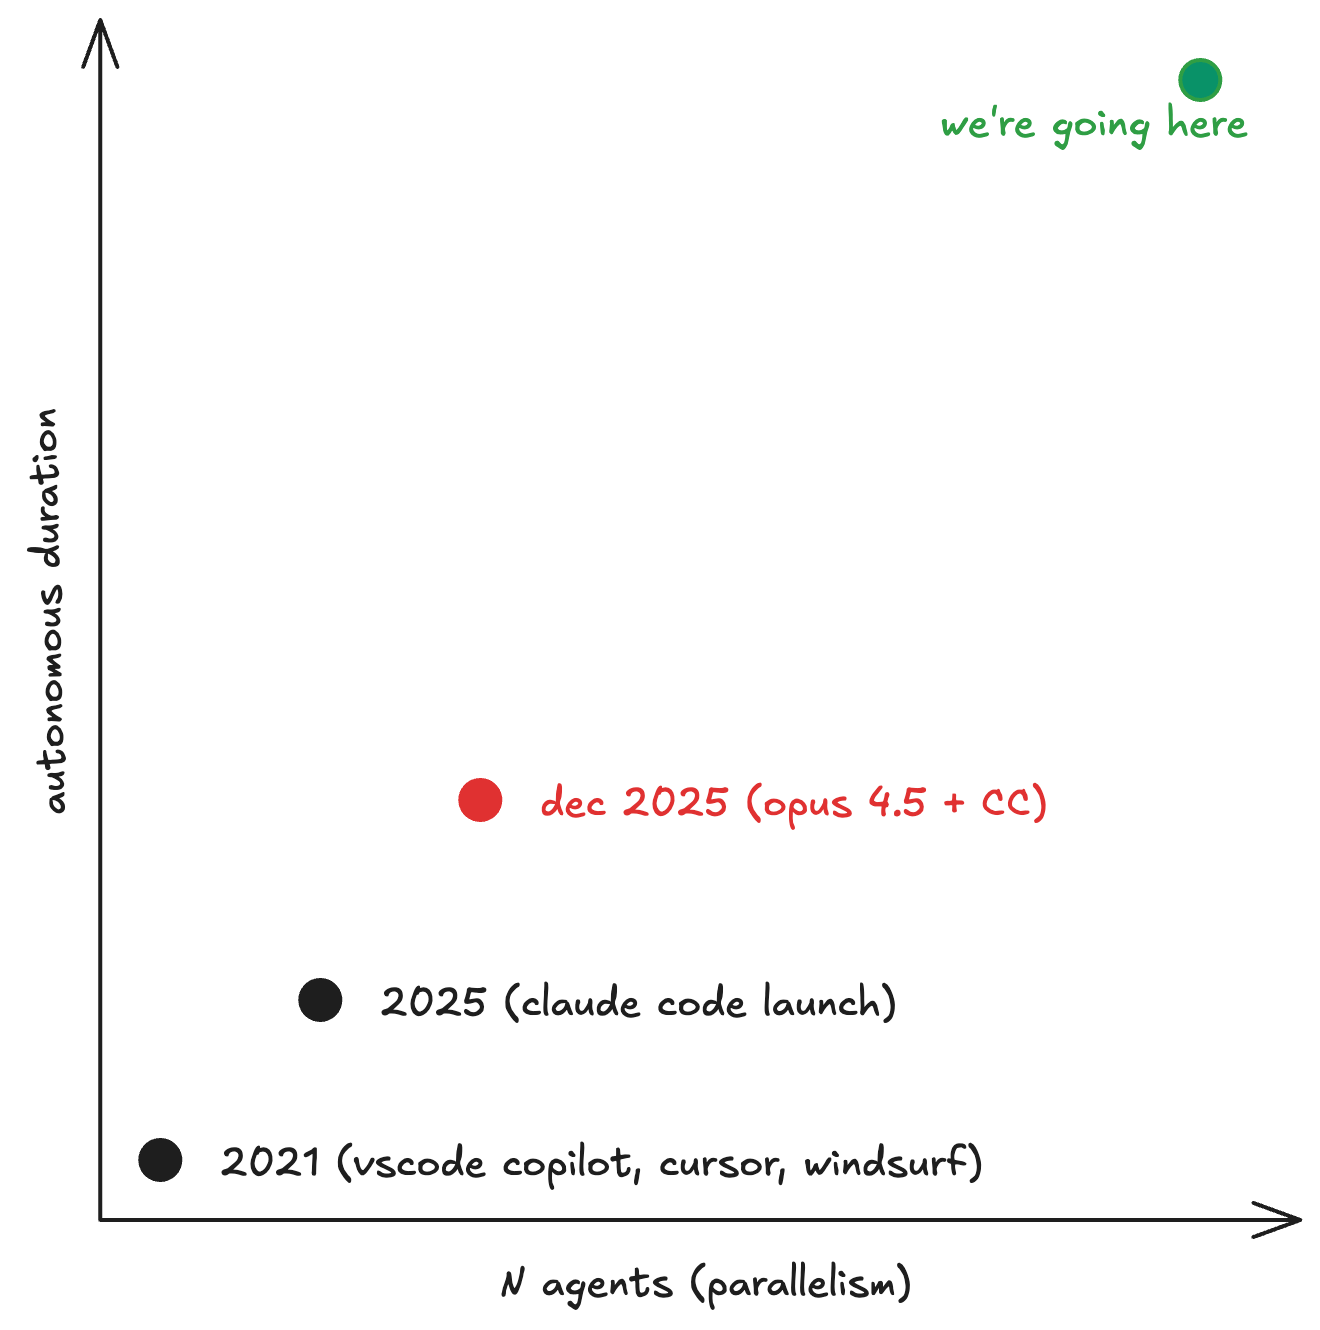
ปี 2025 คือปีแห่งเอเจนต์ Claude Code ทำให้การทำงานกับ LLM คล้ายกับการเขียนโปรแกรมเป็นคู่กับนักพัฒนารุ่นน้องที่เก่งมากแต่ยังขาดประสบการณ์ ช่วงหนึ่งในเดือนธันวาคม 2025 เมื่อ Opus 4.5 เปิดตัว ก็เริ่มเห็นความสามารถที่เพิ่มขึ้นแบบก้าวกระโดด Claude ทำงานด้วยตัวเองได้นานหลายชั่วโมงต่อครั้ง
ก้าวถัดไปที่เห็นได้ชัดคือการ tmux Claude Code หลายอินสแตนซ์ แล้วให้แต่ละอินสแตนซ์ทำงานกับ issue ที่แยกกัน
วิธีนี้แพร่หลายจน Anthropic เริ่มเรียกว่า "multi-Clauding"
ตามคำเรียกของ Steve Yegge นี่คือการเขียนโค้ดด้วยเอเจนต์ระดับ 6/7
tmux นั้นยอดเยี่ยม แต่ภาระทางความคิดกลับหนักหน่วงมาก
คุณต้องสลับไปมาระหว่างการคิดไอเดีย การกำกับทิศทาง และการตรวจทานอยู่ตลอด
เห็นได้ชัดว่าคุณเป็นคอขวด และการที่คุณจัดการเอเจนต์จำนวนมากกว่านี้ไม่ได้ก็เป็น "ปัญหาด้านทักษะ"
มันน่าจะมีวิธีที่ดีกว่านี้สิ
ฉันจึงสร้าง hive
มันคืออะไร
Hive เป็นตัวประสานงานที่เขียนด้วย Python ทำงานแบบ async ภายในโพรเซสเดียว ประสานงานเอเจนต์เขียนโค้ดที่ใช้ LLM หลายตัวผ่านคิว SQLite โดยใช้ git worktree เป็นแซนด์บ็อกซ์สำหรับรันงาน
มีองค์ประกอบที่ทำงานร่วมกันอยู่สามส่วน Queen เป็นเซสชัน Claude ที่ทำหน้าที่เป็นผู้จัดการโครงการของคุณ: คุณอธิบายงาน เธอจะสำรวจโค้ดเบส เสนอวิธีแบ่งงานเป็น issue พร้อมความสัมพันธ์การพึ่งพาระหว่างงาน แล้วรอให้คุณอนุมัติ Workers เป็นเซสชัน Claude (หรือ Codex) ที่ทำงานขนานกัน แต่ละเซสชันมี git worktree ของตัวเอง คอยหยิบ issue จากคิวไปลงมือทำ Merge Pipeline เป็นเอเจนต์อีกตัวหนึ่งที่รีเบส ทดสอบ และเมิร์จงานที่เสร็จแล้วกลับเข้า main
หลักการออกแบบสำคัญคือ ใช้ Python ประสานงานตามกฎตายตัว และมอบหมายการตัดสินใจที่คลุมเครือให้เซสชัน LLM การเปลี่ยนสถานะของ state machine การรับงาน การส่งต่อปัญหา? Python การแก้ conflict การวิเคราะห์ปัญหาจากการทดสอบ การแบ่งงานเชิงกลยุทธ์? Claude
นี่คือภาพรวมทั้งหมด:
You
  ├─ CLI / Queen (TUI)
  └─ Daemon (background)
       ↓
SQLite Database (~/.hive/hive.db)
  ├─ Issues (work queue)
  ├─ Dependencies (DAG)
  ├─ Agents (ephemeral identity)
  ├─ Events (audit trail)
  ├─ Notes (inter-agent knowledge)
  └─ Merge Queue
       ↓
Orchestrator (async event loop)
  ├─ Main Loop (spawn workers when slots open)
  ├─ Event Consumer (status updates from backends)
  └─ Merge Processor (per-project)
       ↓
Backend Pool
  ├─ Claude WS Backend (claude CLI via WebSocket)
  ├─ Codex App Server Backend (stdio protocol)
  └─ Tau Backend (testing)
       ↓
Workers (each in its own git worktree)
กลไกการเปลี่ยนสถานะ
ทุก issue จะผ่านวงจรชีวิตที่มี 7 สถานะ นี่คือสิ่งสำคัญที่สุดที่ต้องเข้าใจเกี่ยวกับ hive เพราะ การตัดสินใจออกแบบทุกอย่าง ล้วนตั้งอยู่บนการรักษาความถูกต้องของ state machine นี้
OPEN ──(claim)──→ IN_PROGRESS ──(success)──→ DONE ──(merge)──→ FINALIZED
  ↑                    │
  └──(retry/switch)────┘
                       │
                  (exhausted)──→ ESCALATED
                       │
                  (manual)─────→ CANCELED
นโยบายการส่งต่อปัญหามีลำดับสามขั้น
- ลองใหม่ด้วยเอเจนต์ตัวเดิม สูงสุด 2 ครั้ง บางทีโมเดลอาจแค่ทำงานพลาดไปในรอบนั้น
- เปลี่ยนเอเจนต์ ใช้เอเจนต์ตัวใหม่พร้อม worktree ที่ไม่มีการเปลี่ยนแปลงค้างอยู่ เปลี่ยนได้สูงสุด 2 ครั้ง
- ส่งต่อให้มนุษย์จัดการ
ยังมีตัวตรวจจับความผิดปกติด้วย: หากล้มเหลว 3 ครั้งขึ้นไปภายในช่วงเวลา 10 นาที จะส่งต่อปัญหาทันทีโดยข้ามโควตาการลองใหม่ วิธีนี้ช่วยตรวจจับความล้มเหลวเชิงระบบ (ชุดทดสอบที่ใช้การไม่ได้, dependency ที่ขาดหายไป, ปัญหาจากผู้ให้บริการ) ก่อนที่จะสิ้นเปลืองโทเคนไปกับปัญหาเหล่านั้น
การรับงาน
คิวงานที่พร้อมทำได้มาจากคำสั่ง SQL ที่ตรวจสอบ DAG ของ dependency:
SELECT * FROM issues
WHERE status = 'open'
  AND assignee IS NULL
  AND type != 'epic'
  AND NOT EXISTS (
    SELECT 1 FROM dependencies d
    JOIN issues blocker ON d.depends_on = blocker.id
    WHERE d.issue_id = issues.id
      AND blocker.status NOT IN ('done', 'finalized', 'canceled')
  )
ORDER BY priority ASC, created_at ASC
issue จะ "พร้อมทำ" ก็ต่อเมื่อสิ่งที่ขวางอยู่ทั้งหมดได้รับการแก้ไขแล้ว
การรับงานเป็นการอัปเดตแบบอะตอมมิกในลักษณะ CAS: ตรวจสอบว่า issue ยังเปิดอยู่และยังไม่มีผู้รับผิดชอบ ตรวจสอบว่าเงื่อนไข dependency ยังคงครบถ้วน แล้วอัปเดตภายในธุรกรรมเดียว หาก worker สองตัวแย่งรับ issue เดียวกัน ตัวหนึ่งจะสำเร็จ ส่วนอีกตัวจะได้รับ False กลับมา
ชั้นนามธรรมของ backend
นี่คือส่วนที่ฉันพอใจมากที่สุด
อินเทอร์เฟซ HiveBackend มีเมธอดประมาณ 15 รายการ ครอบคลุมการจัดการเซสชัน (create_session, abort_session, get_session_status) การสื่อสาร (send_message_async, get_messages, reply_permission) และการสตรีมเหตุการณ์ (on(event_type, handler), connect_with_reconnect())
ตัวประสานงานไม่จำเป็นต้องสนใจว่า backend ใดกำลังทำงานอยู่ แค่เรียกใช้อินเทอร์เฟซก็พอ
ทำไมเรื่องนี้จึงสำคัญ? โมเดลชั้นนำระดับ SOTA ผลัดกันขึ้นครองอันดับหนึ่งทุกไม่กี่เดือน และยังไม่ชัดเจนว่าโมเดลแต่ละตัวทำงานร่วมกับ CLI wrapper แต่ละแบบอย่างไร (ได้ยินมาว่า GPT 5.4 ใน Claude Code ค่อนข้างดี) การไม่ผูกกับทั้งโมเดลและ harness ทำให้โค้ดส่วนประสานงานหลักไม่ต้องเปลี่ยนตามส่วนอื่น ๆ ที่พัฒนาอย่างรวดเร็ว
กระบวนการเมิร์จ
เมื่อ worker ทำ issue เสร็จ งานนั้นจะเข้าสู่กระบวนการเมิร์จ
การเมิร์จมีเซสชัน Claude ที่รับผิดชอบโดยเฉพาะชื่อว่า "Refinery" โดย Refinery จะได้รับบริบทของ conflict หรือผลลัพธ์จากการทดสอบ แก้ปัญหา แล้วเขียนไฟล์ผลลัพธ์ที่มีโครงสร้าง มันสามารถเมิร์จงาน (แก้ conflict แล้วและผ่านการทดสอบ) ปฏิเสธงาน (ส่งกลับไปที่ open เพื่อแก้ไข) หรือส่งต่อให้มนุษย์จัดการ (ซับซ้อนหรือคลุมเครือเกินไป)
Refinery เป็นเซสชันที่คงอยู่ระยะยาวหนึ่งเซสชันต่อโครงการ และนำกลับมาใช้กับการเมิร์จหลายครั้ง เมื่อสะสมบริบทมากเกินไป (>100k โทเคน หรือ >20 ข้อความ) hive จะเปลี่ยนเป็นเซสชันใหม่เพื่อให้เซสชันสดใหม่อยู่เสมอ แต่ละโครงการมี MergeProcessor ของตัวเอง การประสานงานหลายโครงการจึงไม่ทำให้การเมิร์จข้ามโครงการแย่งทรัพยากรกัน
การถ่ายทอดความรู้ระหว่างเอเจนต์
Worker จะเขียน .hive-notes.jsonl ระหว่างทำงาน:
{"category": "discovery", "content": "postgres dependency in main.py requires PGHOST to be set"}
{"category": "gotcha", "content": "tests require PYTHONPATH=src/"}
เมื่อ worker ทำงานเสร็จ hive จะรวบรวมบันทึกของมันและเก็บไว้ในฐานข้อมูล เมื่อสร้าง worker ใหม่สำหรับ issue ที่เกี่ยวข้อง (อยู่ใน epic เดียวกัน โครงการเดียวกัน) hive จะแทรกบันทึกที่เกี่ยวข้องจากงานอื่นในกลุ่มเดียวกันลงในพรอมป์ต์
นั่นหมายความว่า ถ้าเอเจนต์ #1 พบว่าชุดทดสอบต้องใช้ตัวแปรสภาพแวดล้อมเฉพาะ เอเจนต์ #3 (ที่ทำงานซึ่งเกี่ยวข้องกัน) ก็จะรู้เรื่องนี้ตั้งแต่ก่อนเริ่มงาน ความรู้สะสมเพิ่มขึ้นทั่วทั้งฝูงเอเจนต์ โดยไม่มีเอเจนต์ตัวใดจำเป็นต้องเก็บทั้งหมดไว้ในบริบทของตัวเอง
Queen
Queen คือจุดหลักที่คุณใช้โต้ตอบกับ hive
เป็นเซสชัน Claude ที่ทำงานในเทอร์มินัลของคุณ (โหมด TUI)
คุณให้สเปกงาน จากนั้นเซสชันนี้จะสำรวจโค้ดเบส อ่าน .hive/project-context.md เพื่อดูความรู้เกี่ยวกับโครงการที่สะสมไว้ เสนอวิธีแบ่งงานเป็น issue พร้อมความสัมพันธ์การพึ่งพาระหว่างงาน รอให้คุณอนุมัติ แล้วจึงสร้าง issue และเริ่มการทำงานของ daemon
ยังมีโหมด headless สำหรับใช้ในสคริปต์ด้วย:
hive queen --headless -p "Bump all dependencies and update the lockfile"
Queen ช่วยให้คุณเปลี่ยนจากการกำกับเอเจนต์ทีละตัวมาเป็นการบริหารโครงการ คุณคิดถึง สิ่งที่ต้องทำ และ วิธีแบ่งงานออกเป็นส่วน ๆ
การตั้งค่าและความสะดวกในการดัดแปลง
Hive ใช้การตั้งค่าแบบ 4 ชั้น: ค่าเริ่มต้นในตัว → TOML ส่วนกลาง (~/.hive/config.toml) → TOML ของโครงการ (.hive.toml) → ตัวแปรสภาพแวดล้อม ตัวเลือกที่น่าสนใจมีดังนี้:
| การตั้งค่า | ค่าเริ่มต้น | สิ่งที่ควบคุม |
|---|---|---|
max_agents |
3 | จำนวน worker ที่ทำงานพร้อมกัน |
worker_model |
claude-sonnet-4-6 | โมเดลสำหรับพัฒนาโค้ด |
refinery_model |
claude-opus-4-6 | โมเดลสำหรับแก้ conflict ระหว่างเมิร์จ |
max_tokens_per_issue |
200,000 | โควตาโทเคนต่อ issue |
max_retries |
2 | จำนวนครั้งที่ลองใหม่ก่อนเปลี่ยนเอเจนต์ |
max_agent_switches |
2 | จำนวนครั้งที่เปลี่ยนเอเจนต์ก่อนส่งต่อปัญหา |
backend |
claude | claude | codex |
test_command |
-- | คำสั่งทดสอบที่ใช้เป็นเกณฑ์ก่อนเมิร์จ |
สิ่งที่ฉันได้เรียนรู้
โค้ดเบสมีโค้ด Python ประมาณ 6,500 บรรทัด ออกแบบมาให้ทำงานบนเครื่อง ใช้ทรัพยากรน้อย และเรียบง่ายพอที่คุณจะอ่านทั้งหมดจบในช่วงบ่ายเดียวแล้วเริ่มดัดแปลงได้
สิ่งที่ฉันได้เรียนรู้ระหว่างพัฒนา hive มีดังนี้:
SQLite คือฐานข้อมูลที่เหมาะกับงานนี้ โหมด WAL ช่วยให้อ่านข้อมูลได้พร้อมกันแม้ระหว่างที่มีการเขียน และ pragma busy_timeout จัดการการแย่งล็อกได้อย่างราบรื่น คุณทำให้ชั้นประสานงานทั้งหมดประกอบด้วยคำสั่ง SQL ล้วน ๆ ได้ สำหรับเอเจนต์ที่ทำงานพร้อมกัน 3-20 ตัว SQLite ก็เพียงพอเหลือเฟือ และความเรียบง่ายในการดูแลระบบนั้นมีค่ามาก
Git worktree ยังมีคนเห็นคุณค่าน้อยกว่าที่ควร เอเจนต์แต่ละตัวจะมี worktree ของ repo เป็นของตัวเอง โดยแตก branch จาก main จึงไม่ไปรบกวนไฟล์ของกันและกัน และเมื่อทำงานเสร็จ คุณก็รีเบสแล้วเมิร์จ เมื่องานล้มเหลว คุณก็ลบ worktree ทิ้ง แยกการทำงานได้อย่างสมบูรณ์แบบ และเก็บกวาดได้ง่ายมาก
ฉันยังไม่แน่ใจเกี่ยวกับระบบบันทึก ฟังดูสมเหตุสมผลที่การให้เอเจนต์ค้นพบสิ่งต่าง ๆ เกี่ยวกับโค้ดเบสและแบ่งปันสิ่งที่พบกับเอเจนต์ตัวอื่นในกลุ่มเดียวกันน่าจะช่วยลดอัตราความล้มเหลวของงานที่เกี่ยวข้องกันได้อย่างมีนัยสำคัญ แต่การออกแบบงานและเบนช์มาร์กที่วัดเรื่องนี้ได้แม่นยำนั้นทำได้ยาก นี่คือสิ่งที่ควรศึกษาอีกมากในอนาคต
โค้ดอยู่ที่ github.com/nwyin/hive ใช้สัญญาอนุญาต MIT และออกแบบมาให้ fork และดัดแปลงต่อได้ ถ้าคุณกำลังจัดการเอเจนต์ 3 ตัวขึ้นไปใน tmux และอยากได้อะไรที่เป็นระบบมากขึ้น ลองเข้าไปดูได้