contenu
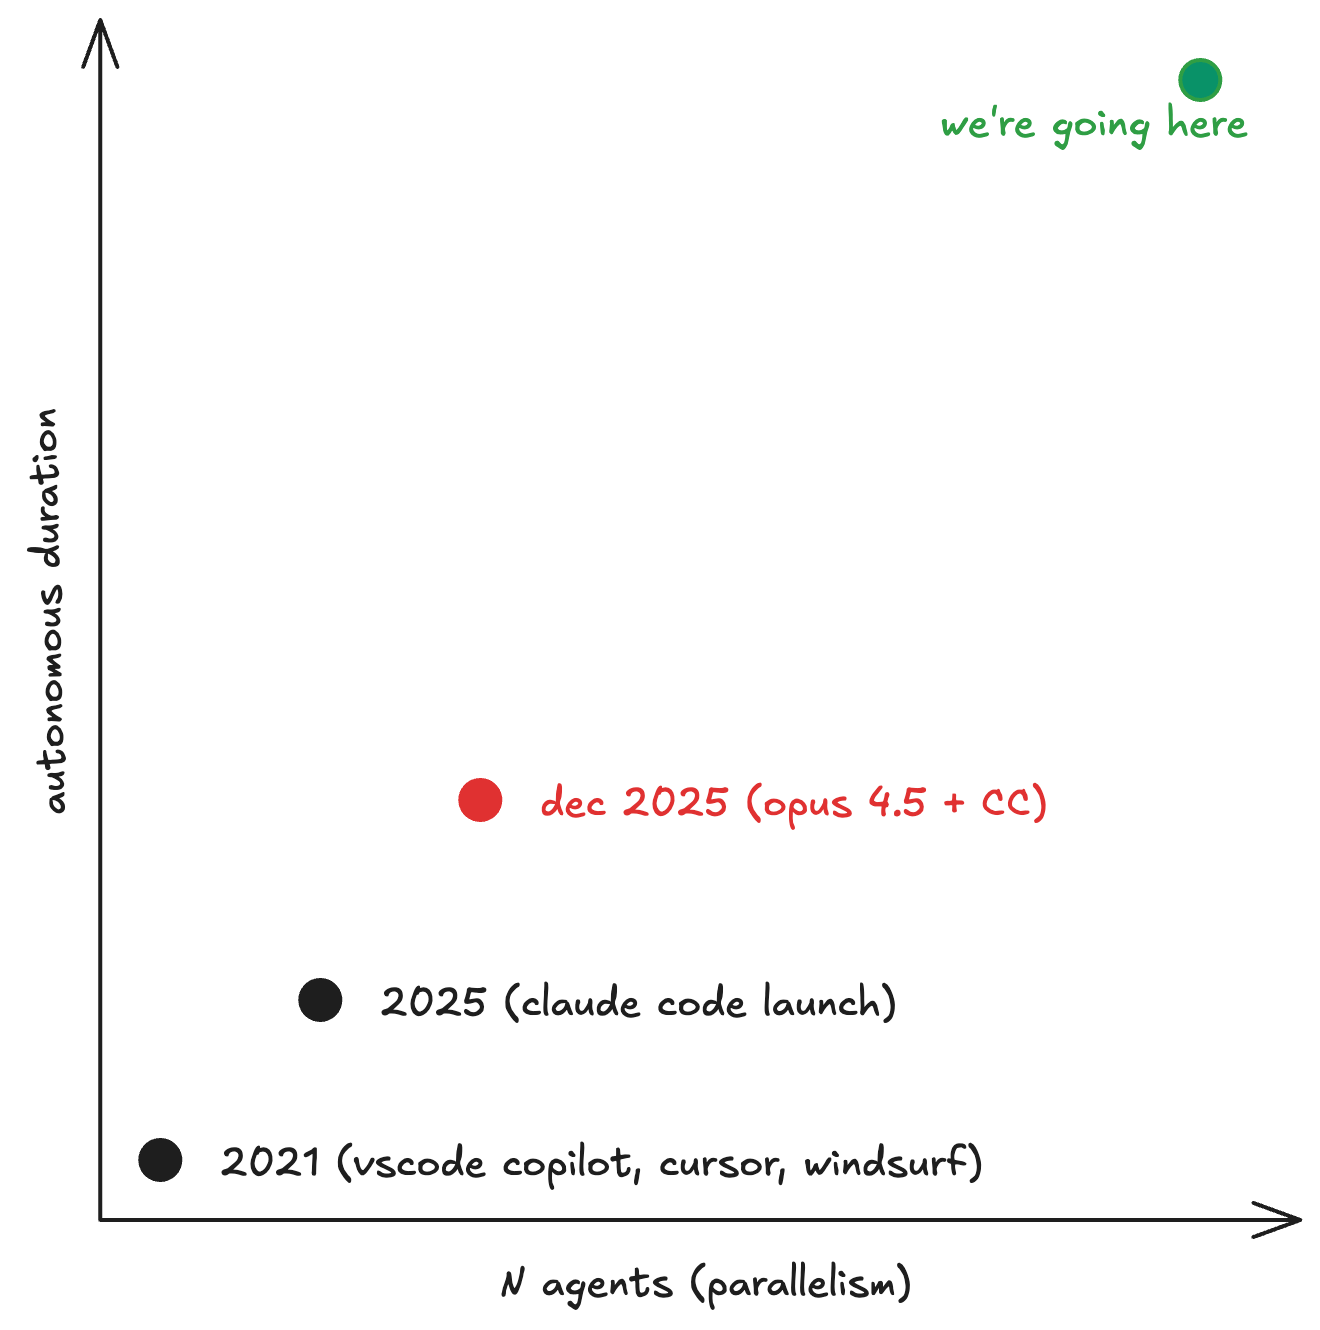
2025 a été l’année des agents. Avec Claude Code, travailler avec des LLM est devenu comparable à de la programmation en binôme avec un développeur junior très compétent, mais inexpérimenté. Courant décembre 2025, avec la sortie d’Opus 4.5, un bond dans les capacités est devenu perceptible. Claude pouvait travailler seul pendant des heures d’affilée.
L’étape suivante, évidente, consiste à tmux de nombreuses instances de Claude Code et à les faire travailler sur des tickets distincts.
Cette pratique est devenue si courante qu’Anthropic a commencé à la désigner sous le nom de « multi-Clauding ».
Dans la terminologie de Steve Yegge, cela correspond au niveau 6/7 de la programmation agentique.
tmux, c’est très bien, mais la charge cognitive devient écrasante.
Vous passez constamment de la recherche d’idées au pilotage et à la revue du travail.
Il est clair que vous êtes le goulot d’étranglement, et que votre incapacité à gérer davantage d’agents est un « problème de compétence ».
Il doit bien y avoir une meilleure façon de faire.
J’ai donc créé hive.
De quoi s’agit-il
Hive est un orchestrateur asynchrone en Python, exécuté dans un seul processus, qui coordonne plusieurs agents de programmation basés sur des LLM autour d’une file d’attente SQLite, en utilisant des worktrees Git comme environnements d’exécution isolés.
Il comporte trois éléments. La Reine est une session Claude qui joue le rôle de cheffe de projet : vous décrivez le travail, elle explore le code source, propose un découpage en tickets avec leurs dépendances et attend votre approbation. Les exécutants sont des sessions Claude (ou Codex) parallèles, chacune dans son propre worktree Git, qui prennent des tickets dans la file d’attente et réalisent le travail correspondant. Le pipeline de fusion est un autre agent qui effectue les rebases, exécute les tests et fusionne le travail terminé dans main.
Le principe de conception central : une orchestration déterministe en Python, les décisions ambiguës étant déléguées aux sessions de LLM. Transitions de la machine à états, attribution, escalade ? Python. Résolution des conflits, diagnostic des tests, découpage stratégique ? Claude.
Voici la vue d’ensemble :
You
  ├─ CLI / Queen (TUI)
  └─ Daemon (background)
       ↓
SQLite Database (~/.hive/hive.db)
  ├─ Issues (work queue)
  ├─ Dependencies (DAG)
  ├─ Agents (ephemeral identity)
  ├─ Events (audit trail)
  ├─ Notes (inter-agent knowledge)
  └─ Merge Queue
       ↓
Orchestrator (async event loop)
  ├─ Main Loop (spawn workers when slots open)
  ├─ Event Consumer (status updates from backends)
  └─ Merge Processor (per-project)
       ↓
Backend Pool
  ├─ Claude WS Backend (claude CLI via WebSocket)
  ├─ Codex App Server Backend (stdio protocol)
  └─ Tau Backend (testing)
       ↓
Workers (each in its own git worktree)
La machine à états
Chaque ticket passe par un cycle de vie à 7 états. C’est ce qu’il y a de plus important à comprendre à propos de hive, car chaque décision de conception découle de la nécessité de préserver la cohérence de cette machine à états.
OPEN ──(claim)──→ IN_PROGRESS ──(success)──→ DONE ──(merge)──→ FINALIZED
  ↑                    │
  └──(retry/switch)────┘
                       │
                  (exhausted)──→ ESCALATED
                       │
                  (manual)─────→ CANCELED
La politique d’escalade suit une chaîne à trois niveaux.
- Réessayer avec le même agent, jusqu’à 2 tentatives. Peut-être que cette exécution du modèle s’est simplement mal passée.
- Changer d’agent : un nouvel agent avec un worktree propre, jusqu’à 2 changements.
- Transmettre à un humain.
Un détecteur d’anomalies est également prévu : au moins 3 échecs sur une fenêtre de 10 minutes déclenchent une escalade immédiate, sans tenir compte du budget de nouvelles tentatives. Cela permet de détecter les défaillances systématiques (suite de tests défectueuse, dépendance manquante, problèmes chez le fournisseur) avant qu’elles n’engloutissent des tokens.
L’attribution du travail
La file des tickets prêts à être traités repose sur une requête SQL qui résout le DAG des dépendances :
SELECT * FROM issues
WHERE status = 'open'
  AND assignee IS NULL
  AND type != 'epic'
  AND NOT EXISTS (
    SELECT 1 FROM dependencies d
    JOIN issues blocker ON d.depends_on = blocker.id
    WHERE d.issue_id = issues.id
      AND blocker.status NOT IN ('done', 'finalized', 'canceled')
  )
ORDER BY priority ASC, created_at ASC
Un ticket ne devient « prêt » que lorsque tous ses blocages sont levés.
L’attribution repose sur une mise à jour atomique de type CAS : vérifier que le ticket est toujours ouvert et n’est attribué à personne, vérifier que les dépendances sont toujours satisfaites, puis effectuer la mise à jour au sein d’une seule transaction. Si deux exécutants tentent de s’attribuer le même ticket au même moment, l’un l’obtient et l’autre reçoit False en retour.
L’abstraction du backend
C’est la partie qui me satisfait le plus.
L’interface HiveBackend comprend environ 15 méthodes couvrant la gestion des sessions (create_session, abort_session, get_session_status), la communication (send_message_async, get_messages, reply_permission) et le streaming d’événements (on(event_type, handler), connect_with_reconnect()).
L’orchestrateur ne se préoccupe pas du backend utilisé ; il se contente d’appeler l’interface.
Pourquoi est-ce important ? Les modèles de pointe se relaient à la première place du podium tous les quelques mois. Et on ne sait pas très bien comment les différents modèles interagissent avec les différentes surcouches CLI (j’entends dire que GPT 5.4 dans Claude Code est plutôt bon). Être indépendant à la fois du modèle et du harness signifie que le code central d’orchestration n’a pas besoin de changer alors que tout le reste évolue rapidement.
Le pipeline de fusion
Lorsqu’un exécutant termine un ticket, son travail entre dans un pipeline de fusion.
Les fusions sont prises en charge par une session Claude dédiée appelée la « Raffinerie ». La Raffinerie reçoit le contexte du conflit ou la sortie des tests, résout le problème et écrit un fichier de résultat structuré. Elle peut fusionner le travail (conflit résolu, tests réussis), le rejeter (le renvoyer à open pour reprise) ou faire appel à un humain (situation trop complexe ou ambiguë).
La Raffinerie est une session de longue durée propre à chaque projet, réutilisée pour plusieurs opérations de fusion. Lorsqu’elle accumule trop de contexte (>100k tokens ou >20 messages), hive renouvelle la session pour repartir avec un contexte frais. Chaque projet dispose de son propre MergeProcessor, ce qui évite que l’orchestration de plusieurs projets ne crée une contention entre les fusions de projets différents.
Le transfert de connaissances entre agents
Les exécutants rédigent .hive-notes.jsonl pendant l’exécution :
{"category": "discovery", "content": "postgres dependency in main.py requires PGHOST to be set"}
{"category": "gotcha", "content": "tests require PYTHONPATH=src/"}
Lorsqu’un exécutant a terminé, hive recueille ses notes et les stocke dans la base de données. Quand hive lance un nouvel exécutant sur un ticket lié (même epic, même projet), il injecte dans le prompt les notes pertinentes issues des tickets connexes.
Cela signifie que si l’agent n° 1 découvre que la suite de tests a besoin d’une variable d’environnement précise, l’agent n° 3 (qui travaille sur une tâche liée) le saura avant même de commencer. Les connaissances s’accumulent à l’échelle de l’essaim sans qu’aucun agent ait besoin de toutes les garder dans son contexte.
La Reine
La Reine est le principal point d’interaction avec hive.
C’est une session Claude exécutée dans votre terminal (en mode TUI).
Vous lui donnez une spécification ; elle explore alors le code source, lit .hive/project-context.md pour consulter les connaissances accumulées sur le projet, propose un découpage en tickets avec leurs dépendances, attend votre approbation, puis crée les tickets et lance le démon.
Il existe aussi un mode sans interface pour une utilisation dans des scripts :
hive queen --headless -p "Bump all dependencies and update the lockfile"
La Reine vous permet de passer du pilotage d’agents individuels à la gestion d’un projet. Vous réfléchissez à ce qui doit être fait et à la façon de découper ce travail.
Configuration et facilité de modification
Hive utilise une configuration à 4 niveaux : valeurs par défaut intégrées → TOML global (~/.hive/config.toml) → TOML du projet (.hive.toml) → variables d’environnement. Les paramètres intéressants :
| Paramètre | Valeur par défaut | Ce qu’il contrôle |
|---|---|---|
max_agents |
3 | Exécutants simultanés |
worker_model |
claude-sonnet-4-6 | Modèle pour l’implémentation |
refinery_model |
claude-opus-4-6 | Modèle pour les conflits de fusion |
max_tokens_per_issue |
200 000 | Budget de tokens par ticket |
max_retries |
2 | Nouvelles tentatives avant de changer d’agent |
max_agent_switches |
2 | Changements d’agent avant escalade |
backend |
claude | claude | codex |
test_command |
-- | Commande de test conditionnant la fusion |
Ce que j’ai appris
Le code source compte environ 6 500 lignes de Python. Il est conçu pour s’exécuter localement, utiliser un minimum de ressources et être assez simple pour que vous puissiez tout lire en un après-midi et commencer à le modifier.
Quelques enseignements tirés de mon travail sur hive :
SQLite est la bonne base de données pour cet usage. Le mode WAL permet des lectures concurrentes pendant les écritures, et le pragma busy_timeout gère proprement la contention sur les verrous. Vous pouvez faire reposer toute la couche de coordination sur de simples requêtes SQL. Pour 3 à 20 agents simultanés, SQLite est largement suffisant, et la simplicité d’exploitation compte énormément.
Les worktrees Git restent sous-estimés. Chaque agent dispose de son propre worktree du dépôt, sur une branche créée à partir de main. Ils ne peuvent pas empiéter sur les fichiers les uns des autres et, une fois le travail terminé, vous effectuez un rebase et une fusion. En cas d’échec, vous supprimez le worktree. L’isolation est parfaite et le nettoyage est trivial.
J’ai encore des incertitudes sur le système de notes. Il paraît logique que le partage, entre agents, des découvertes faites sur le code source réduise sensiblement les taux d’échec sur les tâches liées. Mais il est difficile de concevoir des tâches et des benchmarks qui mesurent cela avec précision. C’est un sujet qui devrait être largement exploré dans les travaux à venir.
Le code est disponible sur github.com/nwyin/hive. Il est sous licence MIT et conçu pour être forké et modifié. Si vous gérez au moins 3 agents dans tmux et que vous cherchez quelque chose de plus structuré, allez y jeter un œil.