conteúdo
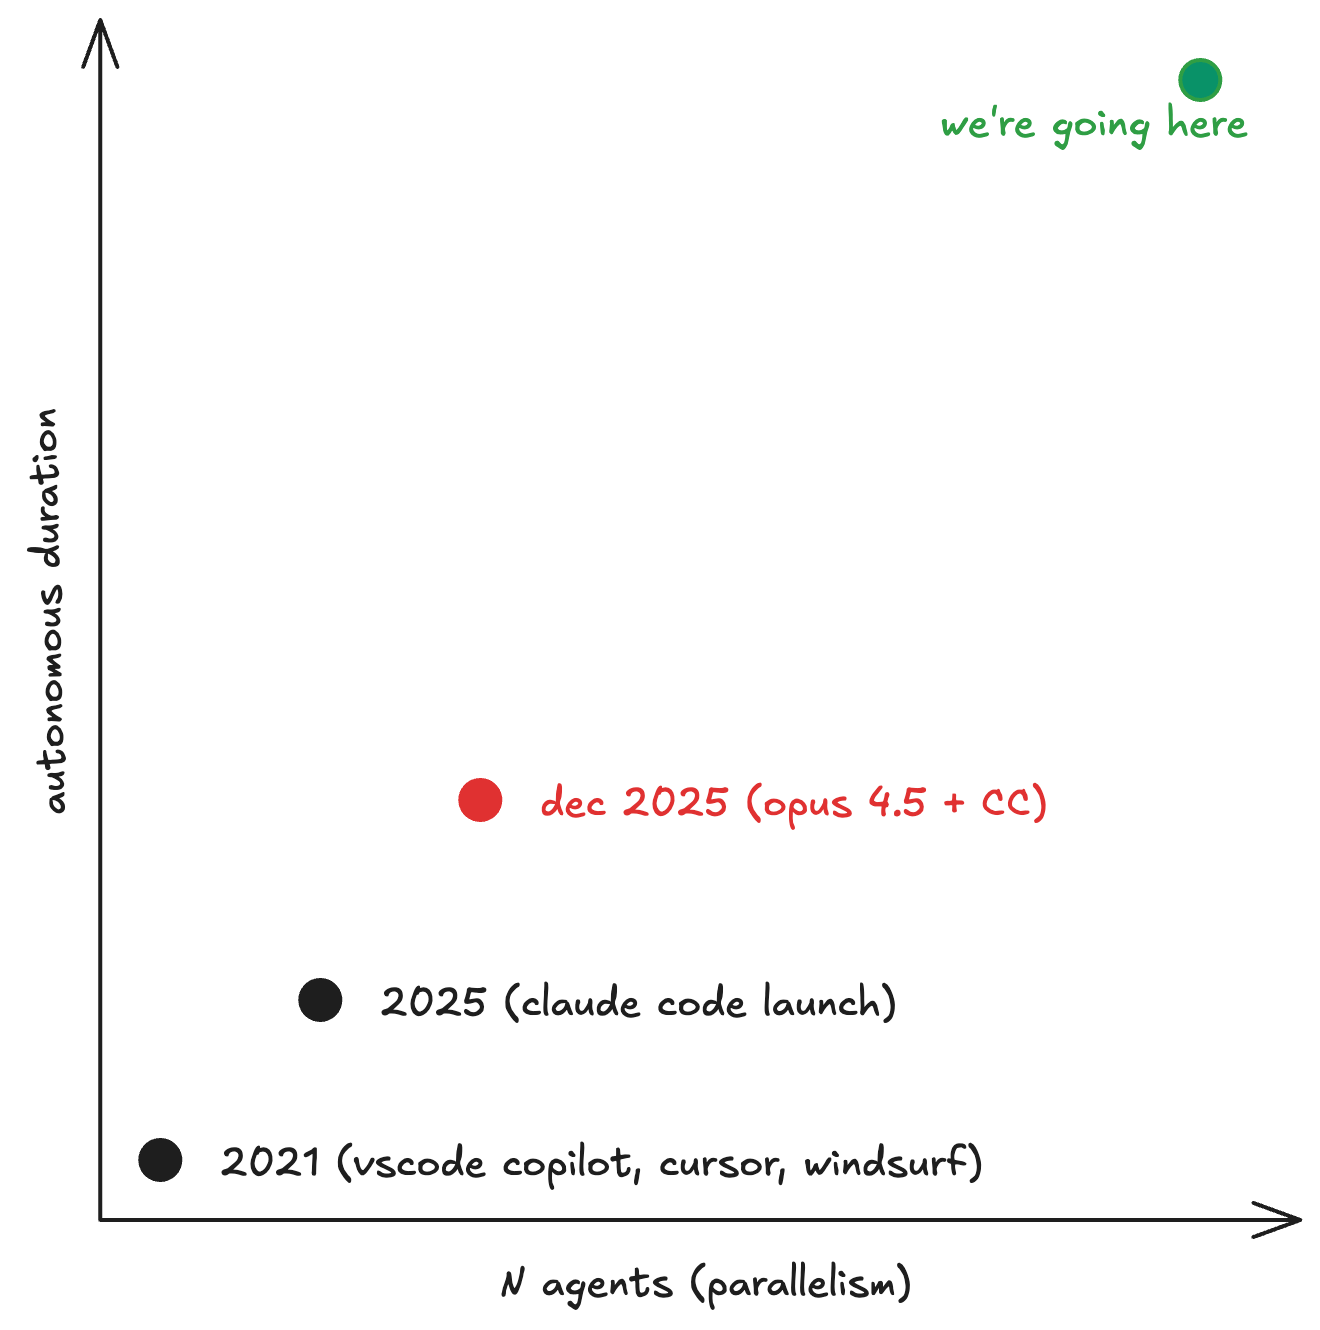
2025 foi o ano dos agentes. O Claude Code tornou o trabalho com LLMs parecido com programar em par com um desenvolvedor júnior muito habilidoso, mas inexperiente. Em algum momento de dezembro de 2025, com o lançamento do Opus 4.5, ficou perceptível um salto de capacidade. O Claude conseguia trabalhar sozinho por horas a fio.
O próximo passo óbvio é tmux várias instâncias do Claude Code e colocá-las para trabalhar em issues diferentes.
Isso se tornou tão comum que a Anthropic passou a chamar essa prática de "multi-Clauding".
No jargão de Steve Yegge, esse é o nível 6/7 da programação com agentes.
tmux é ótimo, mas a sobrecarga cognitiva fica brutal.
Você alterna constantemente entre gerar ideias, orientar os agentes e revisar o trabalho.
Fica claro que você é o gargalo e que não conseguir gerenciar mais agentes é uma "questão de habilidade".
Deve haver um jeito melhor.
Então criei o hive.
O que é
O Hive é um orquestrador assíncrono em Python, de processo único, que coordena vários agentes de programação baseados em LLMs por meio de uma fila em SQLite, usando worktrees do Git como sandboxes de execução.
Há três componentes. A Rainha é uma sessão do Claude que atua como sua gerente de projetos: você descreve o trabalho, ela explora a base de código, propõe uma divisão em issues com dependências e aguarda sua aprovação. Workers são sessões paralelas do Claude (ou do Codex), cada uma em sua própria worktree do Git, que pegam issues da fila e as implementam. O Pipeline de Merge é outro agente que faz o rebase, executa testes e faz o merge do trabalho concluído de volta na main.
O princípio central do projeto: orquestração determinística em Python, decisões ambíguas delegadas a sessões de LLM. Transições da máquina de estados, atribuição de tarefas, escalonamento? Python. Resolução de conflitos, diagnóstico de testes, decomposição estratégica? Claude.
Aqui está a visão completa:
You
  ├─ CLI / Queen (TUI)
  └─ Daemon (background)
       ↓
SQLite Database (~/.hive/hive.db)
  ├─ Issues (work queue)
  ├─ Dependencies (DAG)
  ├─ Agents (ephemeral identity)
  ├─ Events (audit trail)
  ├─ Notes (inter-agent knowledge)
  └─ Merge Queue
       ↓
Orchestrator (async event loop)
  ├─ Main Loop (spawn workers when slots open)
  ├─ Event Consumer (status updates from backends)
  └─ Merge Processor (per-project)
       ↓
Backend Pool
  ├─ Claude WS Backend (claude CLI via WebSocket)
  ├─ Codex App Server Backend (stdio protocol)
  └─ Tau Backend (testing)
       ↓
Workers (each in its own git worktree)
A máquina de estados
Cada issue passa por um ciclo de vida de 7 estados. Esse é o ponto mais importante para entender o hive, porque toda decisão de projeto decorre da necessidade de manter essa máquina de estados correta.
OPEN ──(claim)──→ IN_PROGRESS ──(success)──→ DONE ──(merge)──→ FINALIZED
  ↑                    │
  └──(retry/switch)────┘
                       │
                  (exhausted)──→ ESCALATED
                       │
                  (manual)─────→ CANCELED
A política de escalonamento segue uma cadeia de três níveis.
- Tentar novamente com o mesmo agente, até 2 tentativas. Talvez o modelo só tenha tido uma execução ruim.
- Trocar de agente, usando um novo agente com uma worktree limpa, até 2 trocas.
- Escalar para um humano.
Também há um detector de anomalias: 3 ou mais falhas em uma janela de 10 minutos acionam um escalonamento imediato, ignorando o limite de novas tentativas. Isso detecta falhas sistemáticas (suíte de testes quebrada, dependência ausente, problemas com o provedor) antes que elas queimem tokens.
Assumindo tarefas
A fila de tarefas prontas é uma consulta SQL que resolve o DAG de dependências:
SELECT * FROM issues
WHERE status = 'open'
  AND assignee IS NULL
  AND type != 'epic'
  AND NOT EXISTS (
    SELECT 1 FROM dependencies d
    JOIN issues blocker ON d.depends_on = blocker.id
    WHERE d.issue_id = issues.id
      AND blocker.status NOT IN ('done', 'finalized', 'canceled')
  )
ORDER BY priority ASC, created_at ASC
Uma issue só fica "pronta" quando todos os itens que a bloqueiam são resolvidos.
A atribuição de uma issue é feita com uma atualização atômica no estilo CAS: verificar se a issue continua aberta e sem responsável, verificar se as dependências continuam satisfeitas e, então, fazer a atualização em uma única transação. Se dois workers disputarem a mesma issue, um vence e o outro recebe False como retorno.
A abstração do backend
Esta é a parte que mais me agrada.
A interface HiveBackend tem cerca de 15 métodos que abrangem o gerenciamento de sessões (create_session, abort_session, get_session_status), a comunicação (send_message_async, get_messages, reply_permission) e o streaming de eventos (on(event_type, handler), connect_with_reconnect()).
O orquestrador não se importa com qual backend está em execução; ele apenas chama a interface.
Por que isso importa? Os modelos de ponta (SOTA) se revezam no topo do pódio a cada poucos meses. E não está claro como modelos diferentes interagem com diferentes wrappers de CLI (ouvi dizer que o GPT 5.4 no Claude Code é muito bom). Ser independente tanto do modelo quanto do harness significa que o código central de orquestração não precisa mudar enquanto todo o resto evolui rapidamente.
O pipeline de merge
Quando um worker conclui uma issue, o trabalho entra em um pipeline de merge.
Os merges ficam a cargo de uma sessão dedicada do Claude chamada "Refinaria". A Refinaria recebe o contexto do conflito ou a saída dos testes, resolve o problema e grava um arquivo estruturado com o resultado. Ela pode fazer o merge do trabalho (conflito resolvido, testes passando), rejeitá-lo (devolvê-lo para open para retrabalho) ou escalar para um humano (complexo ou ambíguo demais).
A Refinaria é uma sessão de longa duração por projeto, reutilizada em várias operações de merge. Quando ela acumula contexto demais (>100 mil tokens ou >20 mensagens), o hive a substitui por uma nova sessão para manter o contexto limpo. Cada projeto tem seu próprio MergeProcessor, então a orquestração de vários projetos não causa contenção entre merges de projetos diferentes.
Transferência de conhecimento entre agentes
Os workers escrevem .hive-notes.jsonl durante a execução:
{"category": "discovery", "content": "postgres dependency in main.py requires PGHOST to be set"}
{"category": "gotcha", "content": "tests require PYTHONPATH=src/"}
Quando um worker termina, o hive coleta suas notas e as armazena no banco de dados. Ao iniciar um novo worker em uma issue relacionada (mesmo épico, mesmo projeto), o hive injeta no prompt as notas relevantes de outros workers.
Isso significa que, se o agente nº 1 descobrir que a suíte de testes precisa de uma variável de ambiente específica, o agente nº 3 (que está trabalhando em uma tarefa relacionada) saberá disso antes de começar. O conhecimento se acumula no enxame sem que nenhum agente precise manter tudo no contexto.
A Rainha
A Rainha é o principal ponto de interação com o hive.
É uma sessão do Claude que roda no seu terminal (modo TUI).
Você fornece uma especificação, e ela então explora a base de código, lê .hive/project-context.md para acessar o conhecimento acumulado sobre o projeto, propõe uma divisão em issues com dependências, aguarda sua aprovação e, depois, cria as issues e inicia o daemon.
Também há um modo headless para uso em scripts:
hive queen --headless -p "Bump all dependencies and update the lockfile"
É com a Rainha que você deixa de orientar agentes individuais e passa a gerenciar um projeto. Você pensa em o que precisa acontecer e como dividir esse trabalho.
Configuração e facilidade de modificação
O Hive usa uma pilha de configuração com 4 camadas: configurações padrão embutidas → TOML global (~/.hive/config.toml) → TOML do projeto (.hive.toml) → variáveis de ambiente. Os ajustes mais interessantes:
| Configuração | Padrão | O que controla |
|---|---|---|
max_agents |
3 | Workers simultâneos |
worker_model |
claude-sonnet-4-6 | Modelo para implementação |
refinery_model |
claude-opus-4-6 | Modelo para conflitos de merge |
max_tokens_per_issue |
200.000 | Limite de tokens por issue |
max_retries |
2 | Novas tentativas antes da troca de agente |
max_agent_switches |
2 | Trocas antes do escalonamento |
backend |
claude | claude | codex |
test_command |
-- | Comando de teste para validar o merge |
O que aprendi
A base de código tem cerca de 6.500 linhas de código Python. Ela foi projetada para rodar localmente, usar o mínimo de recursos e ser simples o bastante para que você possa ler tudo em uma tarde e começar a mexer no código.
Algumas coisas que aprendi ao trabalhar no hive:
O SQLite é o banco de dados certo para isso. O modo WAL permite leituras simultâneas durante as gravações, e o pragma busy_timeout lida bem com a contenção de locks. Você pode fazer toda a camada de coordenação só com consultas SQL. Para 3 a 20 agentes simultâneos, o SQLite é mais do que suficiente, e a simplicidade operacional vale muito.
As worktrees do Git continuam subestimadas. Cada agente recebe sua própria worktree do repositório, com uma branch criada a partir da main. Eles não conseguem interferir nos arquivos uns dos outros e, quando o trabalho termina, você faz o rebase e o merge. Quando dá errado, você exclui a worktree. O isolamento é perfeito e a limpeza é trivial.
Ainda tenho dúvidas sobre o sistema de notas. Faz sentido esperar que os agentes, ao descobrir coisas sobre a base de código e compartilhar essas descobertas com outros agentes, reduzam significativamente as taxas de falha em tarefas relacionadas. Mas é difícil criar tarefas e benchmarks que meçam isso com precisão. Isso é algo que deveria ser bastante explorado em trabalhos futuros.
O código está em github.com/nwyin/hive. Ele usa a licença MIT e foi feito para que você crie forks e modifique o código. Se você gerencia 3 ou mais agentes no tmux e quer algo mais estruturado, dê uma olhada.