treść
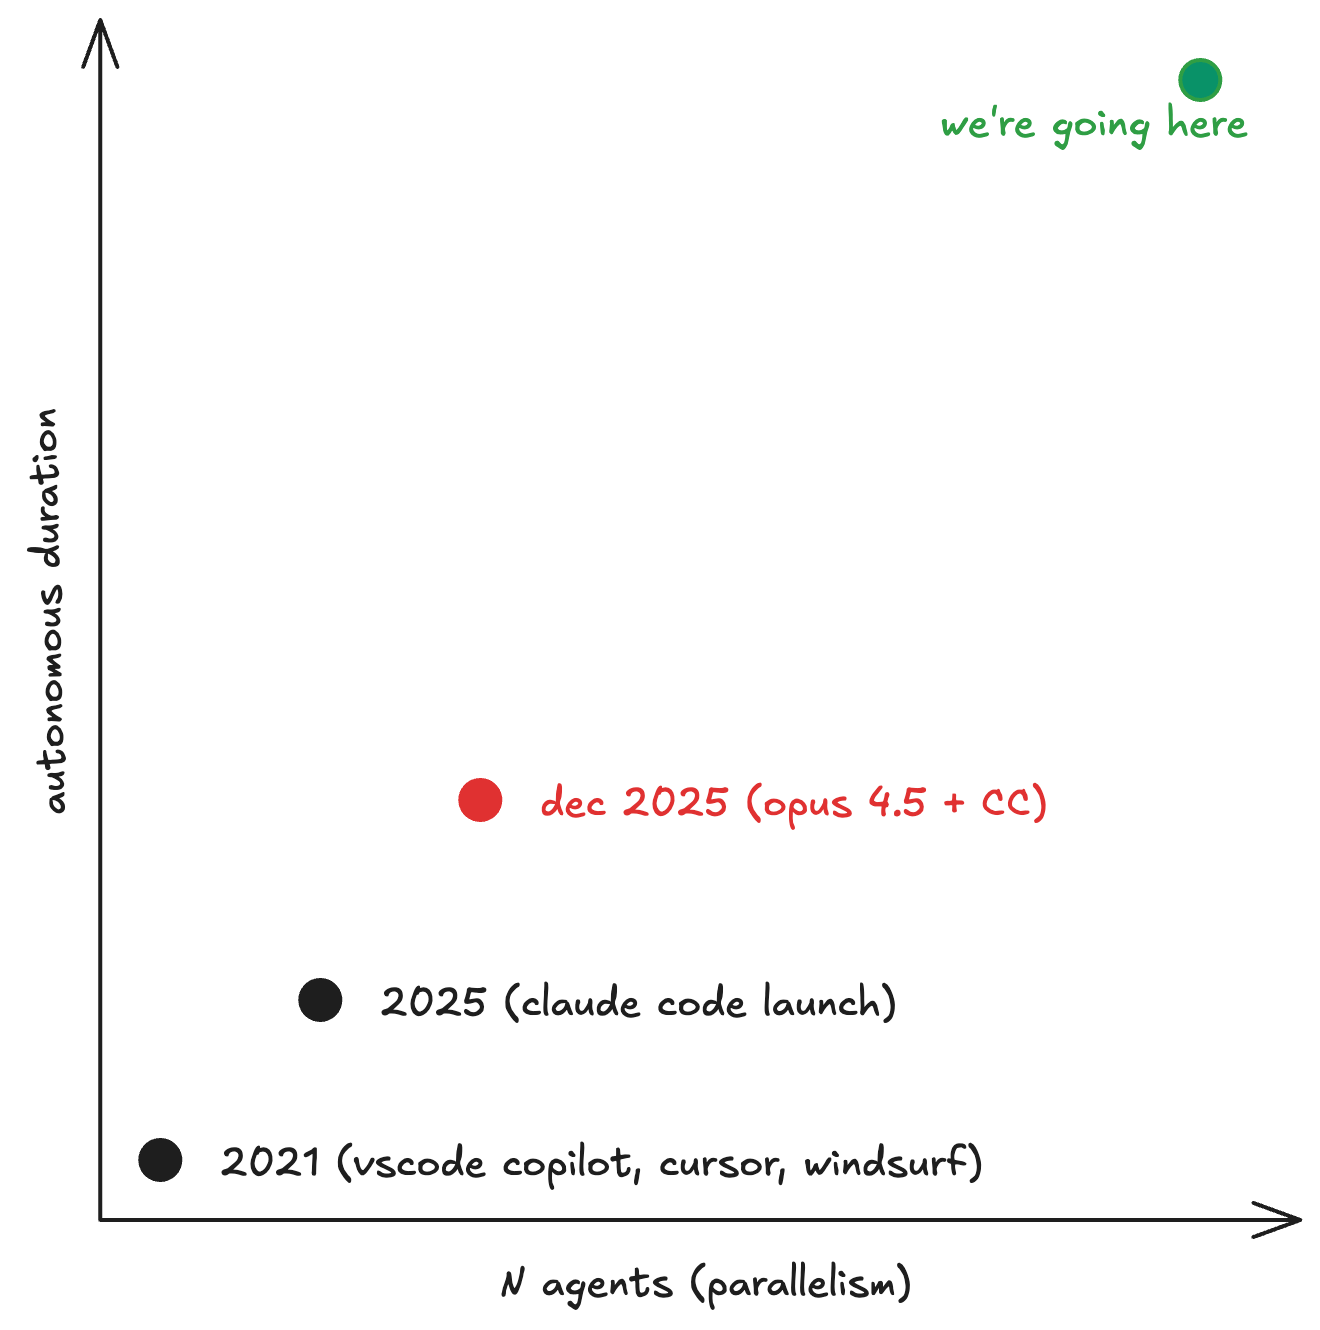
2025 był rokiem agentów. Dzięki Claude Code praca z LLM-ami zaczęła przypominać programowanie w parze z bardzo sprawnym, ale niedoświadczonym młodszym programistą. Gdzieś w grudniu 2025 roku, wraz z premierą Opus 4.5, dał się zauważyć skokowy wzrost możliwości. Claude potrafił pracować samodzielnie przez kilka godzin z rzędu.
Oczywistym kolejnym krokiem jest uruchomienie za pomocą tmux wielu instancji Claude Code i zlecenie im pracy nad osobnymi zgłoszeniami.
Stało się to tak powszechne, że Anthropic zaczęło określać to mianem „multi-Clauding”.
W terminologii Steve’a Yegge’a to poziom 6/7 programowania agentowego.
tmux sprawdza się świetnie, ale obciążenie poznawcze daje mocno w kość.
Ciągle przełączasz się między wymyślaniem pomysłów, kierowaniem pracą i przeglądaniem rezultatów.
Widać, że to ty jesteś wąskim gardłem, a to, że nie potrafisz zarządzać większą liczbą agentów, to „kwestia umiejętności”.
Musi istnieć lepszy sposób.
Dlatego stworzyłem hive.
Co to jest
Hive to asynchroniczny orkiestrator napisany w Pythonie, działający w jednym procesie, który koordynuje pracę wielu agentów programistycznych opartych na LLM-ach za pomocą kolejki w SQLite, wykorzystując drzewa robocze Git jako izolowane środowiska wykonawcze.
Całość składa się z trzech elementów. Królowa to sesja Claude, która pełni rolę kierowniczki twojego projektu: opisujesz pracę do wykonania, ona analizuje bazę kodu, proponuje podział na zgłoszenia z zależnościami i czeka na twoją zgodę. Agenci wykonawczy to równoległe sesje Claude (lub Codex), każda we własnym drzewie roboczym Git, które pobierają zgłoszenia z kolejki i je realizują. Potok scalania to kolejny agent, który wykonuje rebase, uruchamia testy i scala ukończone prace z gałęzią main.
Podstawowa zasada projektu: deterministyczna orkiestracja w Pythonie, decyzje w niejednoznacznych sytuacjach powierzane sesjom LLM. Przejścia w maszynie stanów, przejmowanie zadań, eskalacja? Python. Rozwiązywanie konfliktów, diagnozowanie problemów z testami, strategiczny podział pracy? Claude.
Oto pełny obraz:
You
  ├─ CLI / Queen (TUI)
  └─ Daemon (background)
       ↓
SQLite Database (~/.hive/hive.db)
  ├─ Issues (work queue)
  ├─ Dependencies (DAG)
  ├─ Agents (ephemeral identity)
  ├─ Events (audit trail)
  ├─ Notes (inter-agent knowledge)
  └─ Merge Queue
       ↓
Orchestrator (async event loop)
  ├─ Main Loop (spawn workers when slots open)
  ├─ Event Consumer (status updates from backends)
  └─ Merge Processor (per-project)
       ↓
Backend Pool
  ├─ Claude WS Backend (claude CLI via WebSocket)
  ├─ Codex App Server Backend (stdio protocol)
  └─ Tau Backend (testing)
       ↓
Workers (each in its own git worktree)
Maszyna stanów
Każde zgłoszenie przechodzi przez cykl życia złożony z 7 stanów. To najważniejsza rzecz, którą trzeba zrozumieć w hive, ponieważ każda decyzja projektowa wynika z potrzeby utrzymania poprawności tej maszyny stanów.
OPEN ──(claim)──→ IN_PROGRESS ──(success)──→ DONE ──(merge)──→ FINALIZED
  ↑                    │
  └──(retry/switch)────┘
                       │
                  (exhausted)──→ ESCALATED
                       │
                  (manual)─────→ CANCELED
Polityka eskalacji obejmuje trzy poziomy.
- Ponowienie próby z tym samym agentem, maksymalnie 2 próby. Może modelowi po prostu nie wyszło tym razem.
- Zmiana agenta: nowy agent z czystym drzewem roboczym, maksymalnie 2 zmiany.
- Eskalacja do człowieka.
Jest też detektor anomalii: co najmniej 3 niepowodzenia w ciągu 10 minut powodują natychmiastową eskalację, z pominięciem limitu ponowień. Pozwala to wychwycić problemy systemowe (niedziałający zestaw testów, brakującą zależność, problemy u dostawcy), zanim pochłoną tokeny.
Przejmowanie zadań
Kolejka gotowych zgłoszeń to zapytanie SQL, które rozstrzyga zależności w grafie DAG:
SELECT * FROM issues
WHERE status = 'open'
  AND assignee IS NULL
  AND type != 'epic'
  AND NOT EXISTS (
    SELECT 1 FROM dependencies d
    JOIN issues blocker ON d.depends_on = blocker.id
    WHERE d.issue_id = issues.id
      AND blocker.status NOT IN ('done', 'finalized', 'canceled')
  )
ORDER BY priority ASC, created_at ASC
Zgłoszenie staje się „gotowe” dopiero wtedy, gdy wszystkie blokujące je zgłoszenia zostaną rozwiązane.
Przejmowanie zgłoszenia to atomowa aktualizacja w stylu CAS: sprawdzenie, czy zgłoszenie jest nadal otwarte i nieprzypisane do nikogo, sprawdzenie, czy zależności są nadal spełnione, a następnie aktualizacja w jednej transakcji. Jeśli dwóch agentów wykonawczych rywalizuje o to samo zgłoszenie, jeden wygrywa, a drugi otrzymuje w odpowiedzi False.
Abstrakcja backendu
Z tej części jestem najbardziej zadowolony.
Interfejs HiveBackend obejmuje ~15 metod związanych z zarządzaniem sesjami (create_session, abort_session, get_session_status), komunikacją (send_message_async, get_messages, reply_permission) i strumieniowaniem zdarzeń (on(event_type, handler), connect_with_reconnect()).
Dla orkiestratora nie ma znaczenia, który backend działa; po prostu korzysta z interfejsu.
Dlaczego to ma znaczenie? Najbardziej zaawansowane modele co kilka miesięcy wymieniają się na najwyższym stopniu podium. Nie jest też jasne, jak różne modele współpracują z różnymi nakładkami CLI (słyszałem, że GPT 5.4 w Claude Code radzi sobie całkiem dobrze). Niezależność zarówno od modelu, jak i warstwy uruchomieniowej oznacza, że główny kod orkiestracji nie musi się zmieniać, gdy wszystko wokół szybko ewoluuje.
Potok scalania
Kiedy agent wykonawczy kończy zgłoszenie, jego praca trafia do potoku scalania.
Scalaniem zajmuje się dedykowana sesja Claude o nazwie „Rafineria”. Rafineria otrzymuje kontekst konfliktu lub wyniki testów, rozwiązuje problem i zapisuje ustrukturyzowany plik z wynikiem. Może scalić pracę (konflikt rozwiązany, testy przechodzą), odrzucić ją (odesłać do open w celu poprawy) lub eskalować do człowieka (problem zbyt złożony lub niejednoznaczny).
Rafineria to długotrwała sesja przypisana do projektu, wykorzystywana ponownie przy kolejnych operacjach scalania. Gdy zgromadzi zbyt dużo kontekstu (>100 tys. tokenów lub >20 wiadomości), hive uruchamia nową sesję, żeby zacząć ze świeżym kontekstem. Każdy projekt otrzymuje własny MergeProcessor, więc orkiestracja wielu projektów nie prowadzi do rywalizacji między projektami przy scalaniu.
Przekazywanie wiedzy między agentami
Agenci wykonawczy zapisują .hive-notes.jsonl w trakcie pracy:
{"category": "discovery", "content": "postgres dependency in main.py requires PGHOST to be set"}
{"category": "gotcha", "content": "tests require PYTHONPATH=src/"}
Po zakończeniu pracy agenta hive zbiera jego notatki i zapisuje je w bazie danych. Uruchamiając nowego agenta wykonawczego do powiązanego zgłoszenia (ten sam epik, ten sam projekt), hive dodaje do promptu odpowiednie notatki z pokrewnych zgłoszeń.
To znaczy, że jeśli agent nr 1 odkryje, że zestaw testów wymaga konkretnej zmiennej środowiskowej, agent nr 3 (pracujący nad powiązanym zadaniem) będzie o tym wiedział, zanim zacznie. Wiedza gromadzi się w całym roju, a żaden agent nie musi trzymać jej całej w swoim kontekście.
Królowa
Królowa to główny punkt kontaktu z hive.
To sesja Claude działająca w twoim terminalu (w trybie TUI).
Przekazujesz jej specyfikację, a ona analizuje bazę kodu, czyta .hive/project-context.md, aby poznać zgromadzoną wiedzę o projekcie, proponuje podział na zgłoszenia z zależnościami, czeka na twoją zgodę, a następnie tworzy zgłoszenia i uruchamia demona.
Dostępny jest też tryb headless do użytku w skryptach:
hive queen --headless -p "Bump all dependencies and update the lockfile"
Dzięki Królowej przechodzisz od kierowania poszczególnymi agentami do zarządzania projektem. Myślisz o tym, co trzeba zrobić i jak to podzielić.
Konfiguracja i łatwość modyfikacji
Hive korzysta z 4-warstwowego stosu konfiguracji: wbudowane wartości domyślne → globalny TOML (~/.hive/config.toml) → TOML projektu (.hive.toml) → zmienne środowiskowe. Interesujące ustawienia:
| Ustawienie | Wartość domyślna | Za co odpowiada |
|---|---|---|
max_agents |
3 | Liczba równocześnie działających agentów wykonawczych |
worker_model |
claude-sonnet-4-6 | Model do implementacji |
refinery_model |
claude-opus-4-6 | Model do rozwiązywania konfliktów scalania |
max_tokens_per_issue |
200 000 | Limit tokenów na zgłoszenie |
max_retries |
2 | Liczba ponowień przed zmianą agenta |
max_agent_switches |
2 | Liczba zmian agenta przed eskalacją |
backend |
claude | claude | codex |
test_command |
-- | Polecenie uruchamiające testy wymagane do scalenia |
Czego się nauczyłem
Baza kodu liczy około 6500 wierszy Pythona. Całość zaprojektowano tak, by działała lokalnie, zużywała minimalne zasoby i była na tyle prosta, żeby dało się przeczytać ją w całości w jedno popołudnie i zacząć ją modyfikować.
Kilka rzeczy, których nauczyłem się podczas pracy nad hive:
SQLite to właściwa baza danych do tego zastosowania. Tryb WAL pozwala odczytywać dane równolegle z zapisem, a pragma busy_timeout sprawnie obsługuje rywalizację o blokady. Całą warstwę koordynacji można oprzeć wyłącznie na zapytaniach SQL. Dla 3–20 równocześnie działających agentów SQLite wystarcza z zapasem, a prostota utrzymania jest wiele warta.
Drzewa robocze Git wciąż są niedoceniane. Każdy agent dostaje własne drzewo robocze repozytorium z gałęzią wyprowadzoną z main. Nie mogą sobie nawzajem nadpisywać plików, a po zakończeniu pracy wykonujesz rebase i scalasz zmiany. Gdy coś się nie uda, usuwasz drzewo robocze. Izolacja jest idealna, a sprzątanie banalnie proste.
Wciąż mam wątpliwości co do systemu notatek. Wydaje się logiczne, że agenci odkrywający coś o bazie kodu i dzielący się swoimi odkryciami z agentami pracującymi nad pokrewnymi zadaniami powinni znacząco zmniejszać odsetek niepowodzeń w takich zadaniach. Ale trudno zaprojektować zadania i benchmarki, które pozwalają to dokładnie zmierzyć. To temat, który warto szerzej zbadać w dalszych pracach.
Kod jest dostępny na github.com/nwyin/hive. Ma licencję MIT i powstał z myślą o tworzeniu forków i modyfikowaniu. Jeśli zarządzasz co najmniej 3 agentami w tmux i chcesz czegoś bardziej uporządkowanego, przyjrzyj mu się.