isi
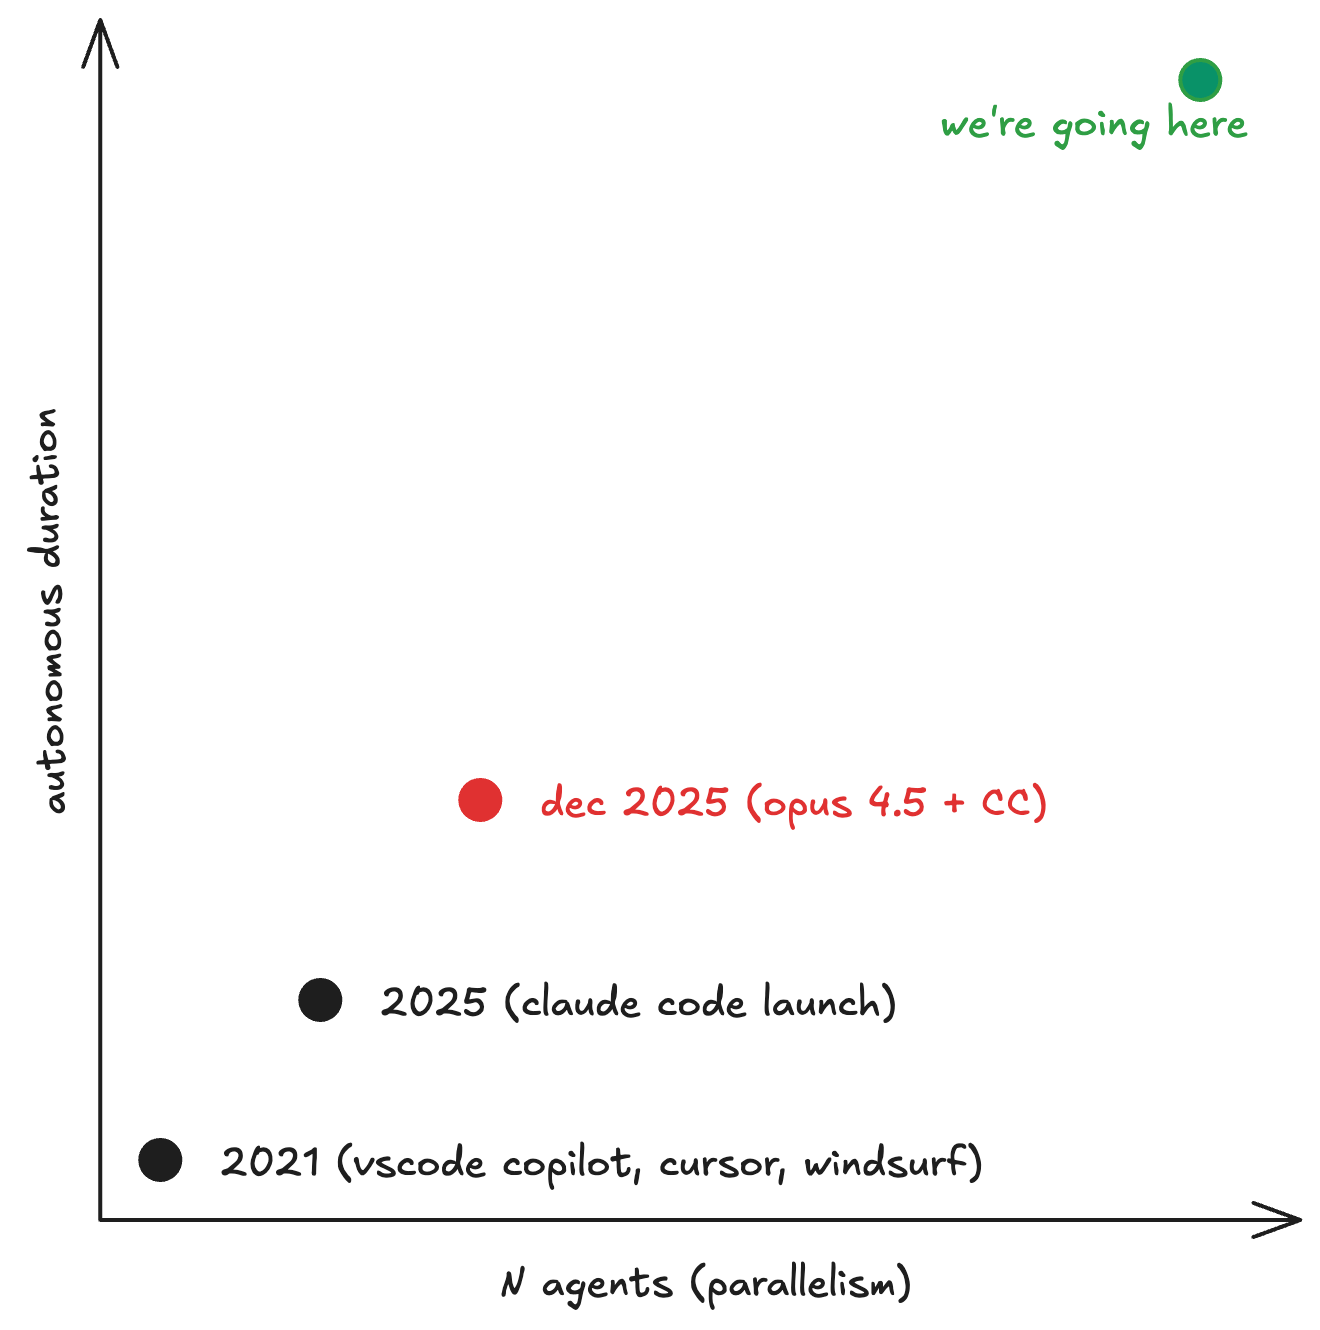
2025 adalah tahun para agen. Claude Code membuat bekerja dengan LLM terasa seperti melakukan pair programming dengan pengembang junior yang sangat terampil tetapi belum berpengalaman. Sekitar waktu perilisan Opus 4.5 pada Desember 2025, lonjakan kemampuan mulai terlihat. Claude mampu bekerja sendiri selama berjam-jam.
Langkah berikutnya yang jelas adalah tmux banyak instans Claude Code dan meminta mereka mengerjakan issue yang berbeda.
Hal ini menjadi begitu umum hingga Anthropic mulai menyebutnya "multi-Clauding".
Dalam istilah Steve Yegge, ini adalah level 6/7 pemrograman berbasis agen.
tmux memang hebat, tetapi beban kognitifnya menjadi sangat berat.
Anda terus-menerus berganti antara menghasilkan ide, memberi arahan, dan meninjau hasil.
Jelas bahwa Andalah yang menjadi penghambat, dan ketidakmampuan Anda mengelola lebih banyak agen adalah "masalah keterampilan".
Pasti ada cara yang lebih baik.
Jadi, saya membuat hive.
Apa itu
Hive adalah orkestrator Python asinkron dengan satu proses yang mengoordinasikan beberapa agen pemrograman LLM melalui antrean SQLite, menggunakan git worktree sebagai sandbox eksekusi.
Ada tiga komponen utama. Queen adalah sesi Claude yang bertindak sebagai manajer proyek Anda: Anda menjelaskan pekerjaannya, ia menjelajahi basis kode, mengusulkan pembagian pekerjaan menjadi issue beserta dependensinya, lalu menunggu persetujuan Anda. Worker adalah sesi Claude (atau Codex) yang berjalan paralel, masing-masing di git worktree sendiri, mengambil issue dari antrean dan mengimplementasikannya. Pipeline Penggabungan adalah agen lain yang melakukan rebase, menjalankan pengujian, dan menggabungkan pekerjaan yang selesai kembali ke main.
Prinsip desain intinya: orkestrasi deterministik di Python, keputusan yang ambigu diserahkan kepada sesi LLM. Transisi mesin status, klaim pekerjaan, eskalasi? Python. Penyelesaian konflik, diagnosis pengujian, pembagian pekerjaan secara strategis? Claude.
Berikut gambaran lengkapnya:
You
  ├─ CLI / Queen (TUI)
  └─ Daemon (background)
       ↓
SQLite Database (~/.hive/hive.db)
  ├─ Issues (work queue)
  ├─ Dependencies (DAG)
  ├─ Agents (ephemeral identity)
  ├─ Events (audit trail)
  ├─ Notes (inter-agent knowledge)
  └─ Merge Queue
       ↓
Orchestrator (async event loop)
  ├─ Main Loop (spawn workers when slots open)
  ├─ Event Consumer (status updates from backends)
  └─ Merge Processor (per-project)
       ↓
Backend Pool
  ├─ Claude WS Backend (claude CLI via WebSocket)
  ├─ Codex App Server Backend (stdio protocol)
  └─ Tau Backend (testing)
       ↓
Workers (each in its own git worktree)
Mesin status
Setiap issue menjalani siklus hidup dengan 7 status. Inilah hal terpenting yang perlu dipahami tentang hive, karena setiap keputusan desain berangkat dari kebutuhan untuk menjaga agar mesin status ini bekerja dengan benar.
OPEN ──(claim)──→ IN_PROGRESS ──(success)──→ DONE ──(merge)──→ FINALIZED
  ↑                    │
  └──(retry/switch)────┘
                       │
                  (exhausted)──→ ESCALATED
                       │
                  (manual)─────→ CANCELED
Kebijakan eskalasinya terdiri dari tiga tingkat berurutan.
- Coba lagi dengan agen yang sama, hingga 2 percobaan. Mungkin modelnya hanya kebetulan berkinerja buruk pada percobaan itu.
- Ganti agen dengan agen baru yang memiliki worktree bersih, hingga 2 kali penggantian.
- Eskalasi kepada manusia.
Ada juga pendeteksi anomali: 3 kegagalan atau lebih dalam rentang 10 menit memicu eskalasi langsung, melewati jatah percobaan ulang. Ini mendeteksi kegagalan sistematis (rangkaian pengujian yang rusak, dependensi yang tidak tersedia, masalah penyedia layanan) sebelum kegagalan tersebut menghabiskan token.
Mengklaim pekerjaan
Antrean issue yang siap dikerjakan berupa kueri SQL yang mengevaluasi DAG dependensi:
SELECT * FROM issues
WHERE status = 'open'
  AND assignee IS NULL
  AND type != 'epic'
  AND NOT EXISTS (
    SELECT 1 FROM dependencies d
    JOIN issues blocker ON d.depends_on = blocker.id
    WHERE d.issue_id = issues.id
      AND blocker.status NOT IN ('done', 'finalized', 'canceled')
  )
ORDER BY priority ASC, created_at ASC
Sebuah issue baru menjadi "siap" setelah semua penghambatnya terselesaikan.
Klaim dilakukan melalui pembaruan atomik bergaya CAS: pastikan issue masih terbuka dan belum ditugaskan kepada siapa pun, pastikan dependensinya masih terpenuhi, lalu lakukan pembaruan dalam satu transaksi. Jika dua worker berebut issue yang sama, satu berhasil dan yang lain mendapat False sebagai hasilnya.
Abstraksi backend
Inilah bagian yang paling membuat saya puas.
Antarmuka HiveBackend memiliki sekitar 15 metode yang mencakup pengelolaan sesi (create_session, abort_session, get_session_status), komunikasi (send_message_async, get_messages, reply_permission), dan streaming event (on(event_type, handler), connect_with_reconnect()).
Orkestrator tidak perlu tahu backend mana yang berjalan; ia cukup memanggil antarmuka tersebut.
Mengapa ini penting? Model-model frontier SOTA bergantian menempati posisi teratas setiap beberapa bulan. Dan belum jelas bagaimana model yang berbeda berinteraksi dengan wrapper CLI yang berbeda (saya dengar GPT 5.4 di Claude Code cukup bagus). Dengan tidak bergantung pada model maupun harness, kode inti orkestrasi tidak perlu berubah seiring pesatnya iterasi pada semua bagian lainnya.
Pipeline penggabungan
Ketika worker menyelesaikan sebuah issue, pekerjaan itu masuk ke pipeline penggabungan.
Penggabungan ditangani oleh sesi Claude khusus yang disebut "Refinery". Refinery menerima konteks konflik atau keluaran pengujian, menyelesaikan masalahnya, lalu menulis berkas hasil yang terstruktur. Agen ini bisa menggabungkan pekerjaan (konflik terselesaikan, pengujian lulus), menolaknya (mengirimkannya kembali ke open untuk dikerjakan ulang), atau melakukan eskalasi kepada manusia (terlalu kompleks atau ambigu).
Refinery adalah sesi berumur panjang untuk tiap proyek, yang digunakan kembali dalam beberapa operasi penggabungan. Ketika konteks yang terkumpul terlalu banyak (>100k token atau >20 pesan), hive menggantinya dengan sesi baru agar konteksnya tetap segar. Setiap proyek mendapat MergeProcessor sendiri, sehingga orkestrasi beberapa proyek tidak membuat proses penggabungan dari proyek-proyek berbeda saling berebut akses.
Transfer pengetahuan antaragen
Worker menulis .hive-notes.jsonl selama eksekusi:
{"category": "discovery", "content": "postgres dependency in main.py requires PGHOST to be set"}
{"category": "gotcha", "content": "tests require PYTHONPATH=src/"}
Ketika sebuah worker selesai bekerja, hive mengumpulkan catatannya dan menyimpannya di basis data. Saat menjalankan worker baru untuk issue terkait (epic yang sama, proyek yang sama), hive menyisipkan catatan relevan dari worker lain ke dalam prompt.
Artinya, jika agen #1 menemukan bahwa rangkaian pengujian memerlukan variabel lingkungan tertentu, agen #3 (yang mengerjakan tugas terkait) akan mengetahuinya sebelum mulai bekerja. Pengetahuan terus terkumpul di seluruh kawanan agen tanpa ada agen yang perlu menyimpan semuanya dalam konteksnya.
Queen
Queen adalah titik interaksi utama dengan hive.
Ini adalah sesi Claude yang berjalan di terminal Anda (mode TUI).
Anda memberinya spesifikasi, lalu ia menjelajahi basis kode, membaca .hive/project-context.md untuk mempelajari pengetahuan proyek yang telah terkumpul, mengusulkan pembagian menjadi issue beserta dependensinya, menunggu persetujuan Anda, lalu membuat issue tersebut dan menjalankan daemon.
Mode headless juga tersedia untuk penggunaan melalui skrip:
hive queen --headless -p "Bump all dependencies and update the lockfile"
Queen memungkinkan Anda beralih dari mengarahkan agen satu per satu ke mengelola proyek. Anda memikirkan apa yang perlu dikerjakan dan bagaimana membaginya.
Konfigurasi dan kemudahan modifikasi
Hive menggunakan tumpukan konfigurasi 4 lapis: nilai bawaan internal → TOML global (~/.hive/config.toml) → TOML proyek (.hive.toml) → variabel lingkungan. Pengaturan yang menarik:
| Pengaturan | Nilai bawaan | Yang dikendalikan |
|---|---|---|
max_agents |
3 | Worker yang berjalan bersamaan |
worker_model |
claude-sonnet-4-6 | Model untuk implementasi |
refinery_model |
claude-opus-4-6 | Model untuk konflik penggabungan |
max_tokens_per_issue |
200.000 | Anggaran token per issue |
max_retries |
2 | Percobaan ulang sebelum mengganti agen |
max_agent_switches |
2 | Penggantian agen sebelum eskalasi |
backend |
claude | claude | codex |
test_command |
-- | Perintah pengujian sebagai syarat penggabungan |
Yang saya pelajari
Basis kodenya terdiri dari sekitar 6.500 baris kode Python. Dirancang untuk berjalan secara lokal, menggunakan sumber daya seminimal mungkin, dan cukup sederhana sehingga Anda bisa membaca seluruh kodenya dalam satu sore lalu mulai mengutak-atiknya.
Beberapa hal yang saya pelajari saat mengerjakan hive:
SQLite adalah basis data yang tepat untuk ini. Mode WAL memungkinkan pembacaan berjalan bersamaan dengan penulisan, dan pragma busy_timeout menangani perebutan kunci dengan baik. Anda bisa membangun seluruh lapisan koordinasi hanya dengan kueri SQL. Untuk 3-20 agen yang berjalan bersamaan, SQLite sudah lebih dari cukup, dan kesederhanaan operasionalnya sangat berharga.
Git worktree masih belum cukup diapresiasi. Setiap agen mendapat worktree repo sendiri, yang bercabang dari main. Mereka tidak bisa saling mengganggu berkas satu sama lain, dan setelah pekerjaan selesai, Anda melakukan rebase dan penggabungan. Ketika pekerjaan gagal, Anda menghapus worktree-nya. Isolasinya sempurna dan pembersihannya sangat mudah.
Saya masih belum yakin tentang sistem catatan ini. Masuk akal jika agen yang menemukan berbagai hal tentang basis kode lalu membagikan temuan tersebut kepada agen sejawat seharusnya dapat menurunkan tingkat kegagalan pada tugas terkait secara berarti. Namun, sulit merancang tugas dan tolok ukur yang mengukur hal ini secara akurat. Hal ini perlu banyak dieksplorasi dalam pekerjaan selanjutnya.
Kodenya tersedia di github.com/nwyin/hive. Kode ini berlisensi MIT dan dirancang agar bisa di-fork dan diutak-atik. Jika Anda mengelola 3 agen atau lebih di tmux dan menginginkan sesuatu yang lebih terstruktur, coba lihat.