содержание
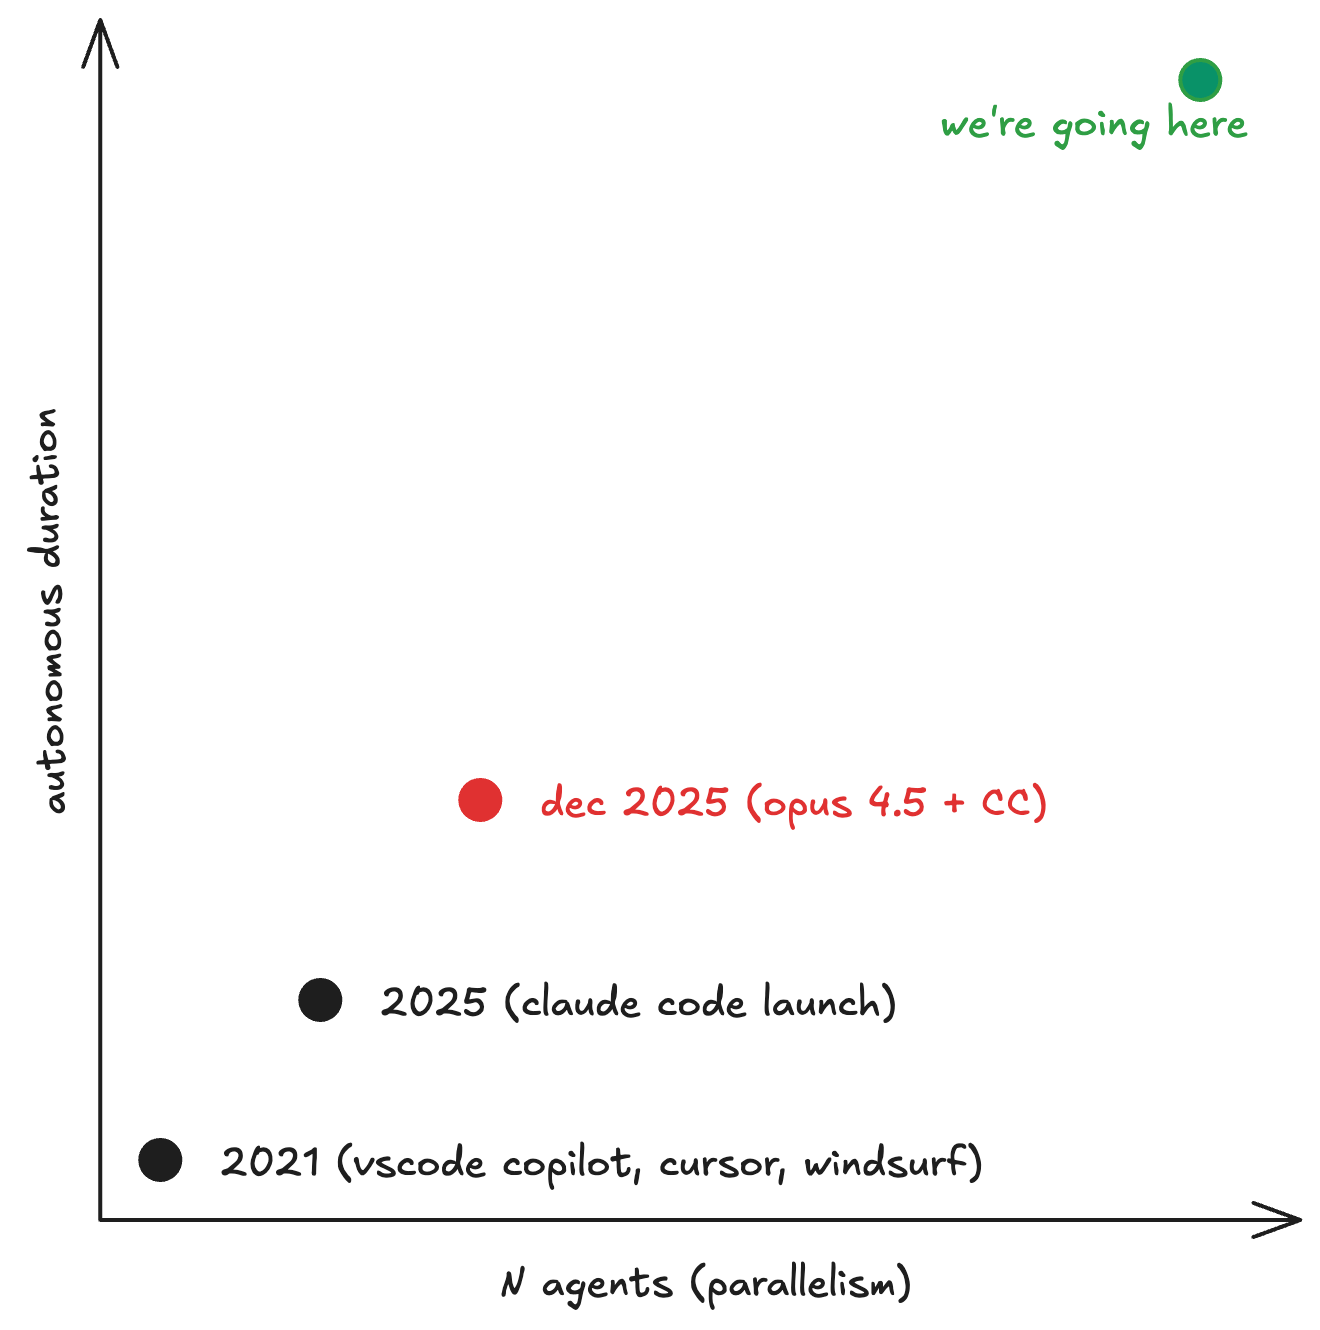
2025-й стал годом агентов. Благодаря Claude Code работа с LLM стала похожа на парное программирование с очень умелым, но неопытным младшим разработчиком. Где-то в декабре 2025 года, с выходом Opus 4.5, стал заметен скачок возможностей. Claude смог самостоятельно работать часами.
Очевидный следующий шаг — tmux множество экземпляров Claude Code и поручить им работу над разными задачами.
Это стало настолько распространённым, что Anthropic начала называть такой подход «multi-Clauding».
В терминологии Стива Йегге это уровень 6/7 программирования с агентами.
tmux — это здорово, но когнитивная нагрузка становится невыносимой.
Приходится постоянно переключаться между генерацией идей, руководством агентами и проверкой результатов.
Становится ясно, что узкое место — вы сами и что управлять большим числом агентов вам мешает «нехватка навыков».
Должен же быть способ получше.
Поэтому я создал hive.
Что это такое
Hive — это однопроцессный асинхронный оркестратор на Python, который координирует работу нескольких LLM-агентов для написания кода через очередь в SQLite, используя рабочие деревья Git как изолированные среды выполнения.
В нём три основных компонента. Королева — это сессия Claude, которая выполняет роль вашего менеджера проекта: вы описываете работу, она исследует кодовую базу, предлагает разбить работу на задачи с зависимостями и ждёт вашего одобрения. Исполнители — это параллельные сессии Claude (или Codex), каждая в своём рабочем дереве Git; они берут задачи из очереди и выполняют их. Конвейер слияния — это ещё один агент, который выполняет rebase, запускает тесты и сливает завершённые изменения в ветку main.
Основной принцип проектирования: детерминированная оркестрация на Python, а решения в неоднозначных ситуациях делегируются сессиям LLM. Переходы между состояниями, взятие задач в работу, эскалация? Python. Разрешение конфликтов, диагностика сбоев тестов, стратегическое разбиение работы на задачи? Claude.
Вот полная картина:
You
  ├─ CLI / Queen (TUI)
  └─ Daemon (background)
       ↓
SQLite Database (~/.hive/hive.db)
  ├─ Issues (work queue)
  ├─ Dependencies (DAG)
  ├─ Agents (ephemeral identity)
  ├─ Events (audit trail)
  ├─ Notes (inter-agent knowledge)
  └─ Merge Queue
       ↓
Orchestrator (async event loop)
  ├─ Main Loop (spawn workers when slots open)
  ├─ Event Consumer (status updates from backends)
  └─ Merge Processor (per-project)
       ↓
Backend Pool
  ├─ Claude WS Backend (claude CLI via WebSocket)
  ├─ Codex App Server Backend (stdio protocol)
  └─ Tau Backend (testing)
       ↓
Workers (each in its own git worktree)
Конечный автомат
Каждая задача проходит жизненный цикл из 7 состояний. Это главное, что нужно понять о hive, потому что каждое проектное решение продиктовано необходимостью поддерживать корректную работу этого конечного автомата.
OPEN ──(claim)──→ IN_PROGRESS ──(success)──→ DONE ──(merge)──→ FINALIZED
  ↑                    │
  └──(retry/switch)────┘
                       │
                  (exhausted)──→ ESCALATED
                       │
                  (manual)─────→ CANCELED
Политика эскалации состоит из трёх последовательных уровней.
- Повторить запуск с тем же агентом, максимум 2 раза. Возможно, модели просто не повезло с конкретным запуском.
- Сменить агента: новый агент с чистым рабочим деревом, до 2 смен.
- Передать решение человеку.
Есть и детектор аномалий: 3 и более сбоя за 10 минут вызывают немедленную эскалацию, независимо от оставшегося числа повторных попыток. Это позволяет выявлять систематические сбои (неработающий набор тестов, отсутствующую зависимость, проблемы у провайдера), прежде чем на них будет потрачено много токенов.
Взятие задач в работу
Очередь готовых к работе задач — это SQL-запрос, который учитывает направленный ациклический граф зависимостей:
SELECT * FROM issues
WHERE status = 'open'
  AND assignee IS NULL
  AND type != 'epic'
  AND NOT EXISTS (
    SELECT 1 FROM dependencies d
    JOIN issues blocker ON d.depends_on = blocker.id
    WHERE d.issue_id = issues.id
      AND blocker.status NOT IN ('done', 'finalized', 'canceled')
  )
ORDER BY priority ASC, created_at ASC
Задача становится «готовой» только тогда, когда решены все блокирующие её задачи.
Взятие задачи в работу — это атомарное обновление в стиле CAS: проверить, что задача всё ещё открыта и никому не назначена, проверить, что зависимости по-прежнему удовлетворены, а затем выполнить обновление в одной транзакции. Если два исполнителя одновременно претендуют на одну задачу, один выигрывает, а другой получает в ответ False.
Абстракция бэкенда
Этой частью я доволен больше всего.
Интерфейс HiveBackend включает ~15 методов для управления сессиями (create_session, abort_session, get_session_status), обмена сообщениями (send_message_async, get_messages, reply_permission) и потоковой передачи событий (on(event_type, handler), connect_with_reconnect()).
Оркестратору неважно, какой бэкенд используется: он просто вызывает методы интерфейса.
Почему это важно? Среди самых передовых моделей лидер меняется каждые несколько месяцев. К тому же непонятно, как разные модели взаимодействуют с разными CLI-оболочками (я слышал, что GPT 5.4 в Claude Code работает довольно хорошо). Независимость и от модели, и от её обвязки означает, что основной код оркестрации не нужно менять, пока всё остальное стремительно обновляется.
Конвейер слияния
Когда исполнитель завершает задачу, результат его работы поступает в конвейер слияния.
Слияниями занимается отдельная сессия Claude под названием «Refinery». Refinery получает контекст конфликта или вывод тестов, решает проблему и записывает структурированный файл с результатом. Она может слить изменения (конфликт разрешён, тесты проходят), отклонить их (вернуть в open на доработку) или передать решение человеку (слишком сложно или неоднозначно).
У каждого проекта своя долгоживущая сессия Refinery, которая используется для нескольких операций слияния. Когда в ней накапливается слишком много контекста (>100k токенов или >20 сообщений), hive заменяет её новой, чтобы начать со свежим контекстом. У каждого проекта свой MergeProcessor, поэтому при оркестрации нескольких проектов они не конкурируют друг с другом за слияние.
Обмен знаниями между агентами
Во время выполнения задачи исполнители пишут .hive-notes.jsonl:
{"category": "discovery", "content": "postgres dependency in main.py requires PGHOST to be set"}
{"category": "gotcha", "content": "tests require PYTHONPATH=src/"}
Когда исполнитель завершает работу, hive собирает его заметки и сохраняет их в базе данных. При запуске нового исполнителя для связанной задачи (тот же эпик, тот же проект) hive добавляет в промпт подходящие заметки других исполнителей.
Это значит, что если агент №1 обнаружит, что для набора тестов нужна определённая переменная окружения, агент №3 (работающий над связанной задачей) будет знать об этом ещё до начала работы. Знания накапливаются во всём рое, при этом ни одному агенту не нужно держать их целиком в контексте.
Королева
Королева — основная точка взаимодействия с hive.
Это сессия Claude, работающая в вашем терминале (в режиме TUI).
Вы даёте ей спецификацию, а она исследует кодовую базу, читает .hive/project-context.md с накопленными знаниями о проекте, предлагает разбить работу на задачи с зависимостями, ждёт вашего одобрения, а затем создаёт задачи и запускает демон.
Для использования в скриптах есть и режим без интерфейса:
hive queen --headless -p "Bump all dependencies and update the lockfile"
Королева позволяет перейти от руководства отдельными агентами к управлению проектом. Вы думаете о том, что нужно сделать и как разбить это на задачи.
Настройка и доработка
Конфигурация Hive состоит из 4 уровней: встроенные значения по умолчанию → глобальный TOML (~/.hive/config.toml) → TOML проекта (.hive.toml) → переменные окружения. Вот интересные параметры:
| Параметр | По умолчанию | За что отвечает |
|---|---|---|
max_agents |
3 | Число одновременно работающих исполнителей |
worker_model |
claude-sonnet-4-6 | Модель для реализации задач |
refinery_model |
claude-opus-4-6 | Модель для разрешения конфликтов слияния |
max_tokens_per_issue |
200 000 | Лимит токенов на задачу |
max_retries |
2 | Число повторных попыток до смены агента |
max_agent_switches |
2 | Число смен агента до эскалации |
backend |
claude | claude | codex |
test_command |
-- | Команда тестов для допуска к слиянию |
Чему я научился
В кодовой базе около 6 500 строк кода на Python. Она рассчитана на локальный запуск и минимальное потребление ресурсов и достаточно проста, чтобы за полдня прочитать весь код и начать его дорабатывать.
Вот что я узнал, работая над hive:
SQLite — именно та база данных, которая здесь нужна. Режим WAL позволяет читать данные параллельно с записью, а прагма busy_timeout корректно обрабатывает конкуренцию за блокировки. Весь слой координации можно реализовать одними SQL-запросами. Для 3–20 параллельно работающих агентов SQLite более чем достаточно, а простота эксплуатации дорогого стоит.
Рабочие деревья Git по-прежнему недооценивают. Каждый агент получает собственное рабочее дерево репозитория в отдельной ветке, созданной от main. Они не мешают друг другу работать с файлами, а когда работа закончена, вы выполняете rebase и слияние. Если работа не удалась, вы удаляете рабочее дерево. Изоляция идеальная, а очистка элементарна.
Я пока не уверен насчёт системы заметок. По идее, если агенты узнают что-то о кодовой базе и делятся своими находками с другими агентами, это должно заметно снижать долю неудач в связанных задачах. Но разработать задачи и бенчмарки, которые точно это измеряют, сложно. В дальнейшей работе стоит уделить этому много внимания.
Код доступен на github.com/nwyin/hive. Он распространяется под лицензией MIT и рассчитан на то, чтобы его форкали и дорабатывали. Если вы управляете 3 и более агентами в tmux и хотите чего-то более структурированного, посмотрите на этот проект.