内容
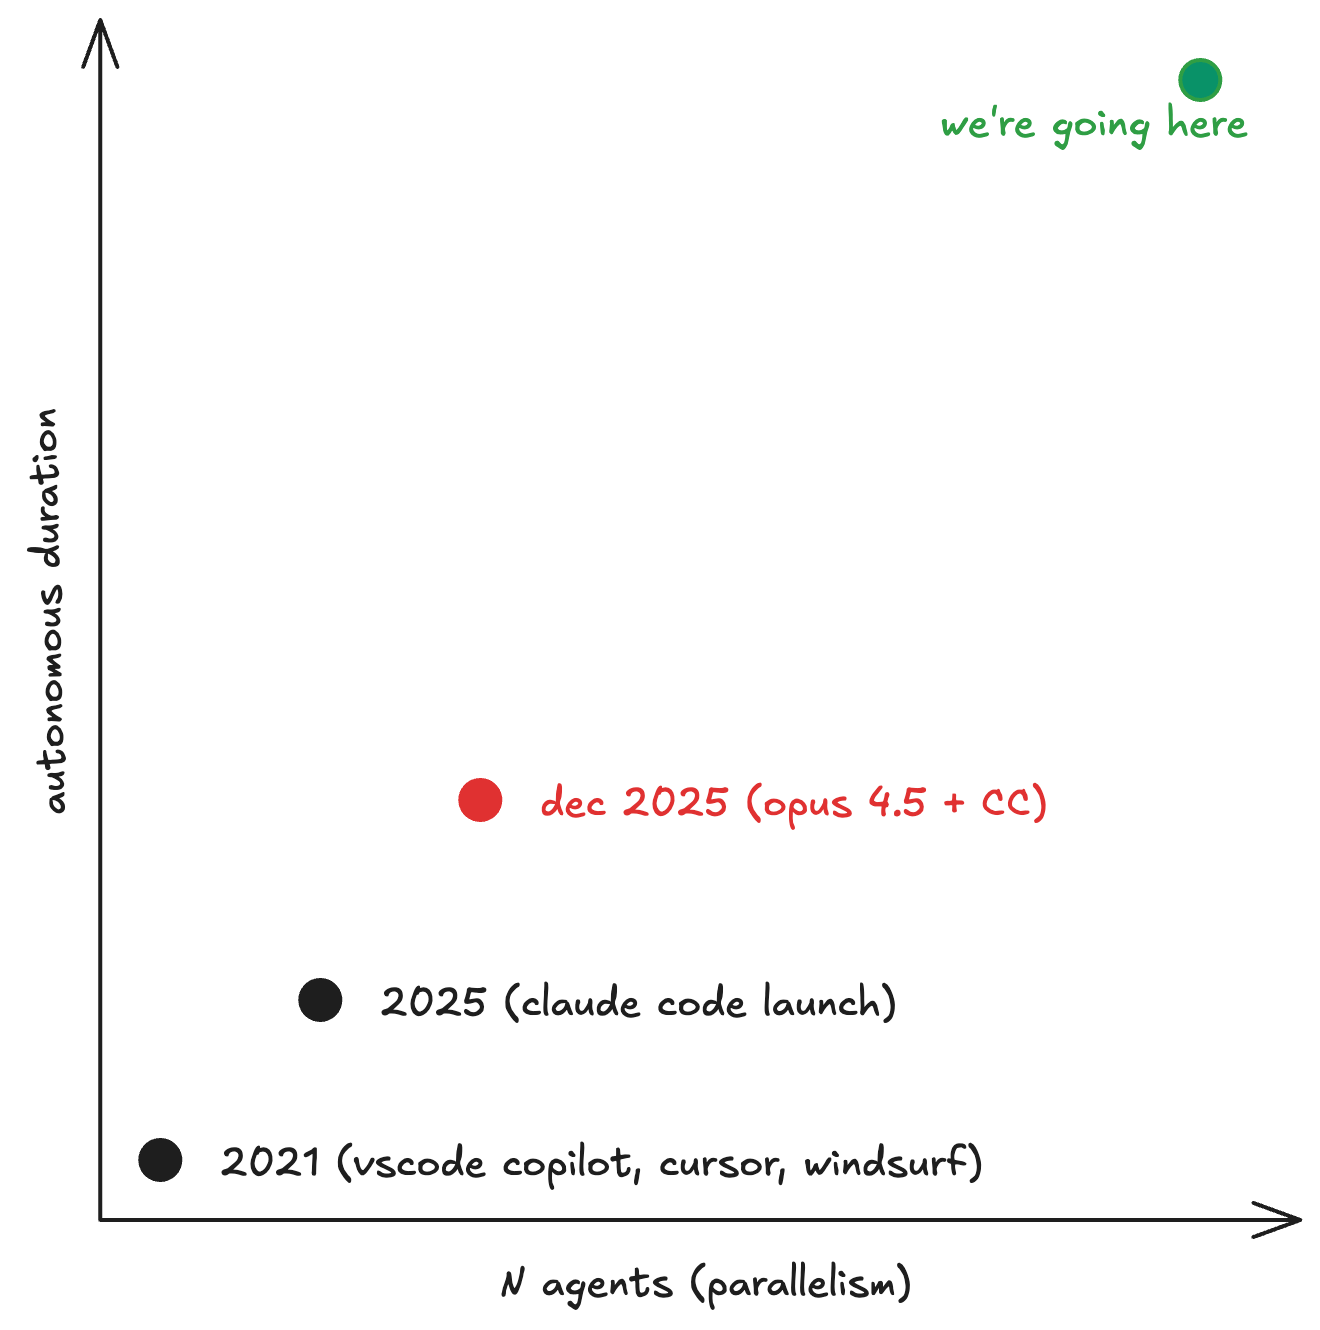
2025年はエージェントの年でした。 Claude Codeによって、LLMとの作業は、とても腕は立つけれど経験は浅い若手開発者とのペアプログラミングのようになりました。 2025年12月のある時点で、Opus 4.5のリリースとともに、能力が一段階上がったことを実感できるようになりました。 Claudeは一度に何時間も、自力で作業を続けられるようになったのです。
次に考えるのは当然、多数のClaude Codeインスタンスをtmuxして、それぞれ別のIssueに取り組ませることです。
これがあまりに一般的になったので、Anthropicも「multi-Clauding」と呼ぶようになりました。
Steve Yeggeの言い方なら、これはエージェント型コーディングのレベル6/7に当たります。
tmuxは素晴らしいのですが、認知的な負荷があまりにも大きくなります。
アイデア出し、指示、レビューの間を絶えず行き来することになります。
自分がボトルネックであり、もっと多くのエージェントを管理できないのは「スキルの問題」なのだと、はっきりわかります。
もっといい方法があるはずです。
そこで、私はhiveを作りました。
どんなものか
Hiveは、SQLiteのキューを介して複数のLLMコーディングエージェントを連携させる、単一プロセスで動く非同期Pythonオーケストレーターです。実行用のサンドボックスにはGitワークツリーを使います。
構成要素は3つあります。 Queenは、プロジェクトマネージャーを務めるClaudeセッションです。あなたが作業内容を説明すると、彼女がコードベースを調べ、依存関係を持つ複数のIssueへの分割を提案し、あなたの承認を待ちます。 ワーカーは、並列で動くClaude(またはCodex)のセッションです。それぞれ専用のGitワークツリーで、キューからIssueを取り出して実装します。 マージパイプラインは、完了した作業をリベースし、テストして、mainにマージする別のエージェントです。
設計の基本原則は、決定論的なオーケストレーションをPythonで行い、曖昧さを伴う判断をLLMセッションに委ねることです。 ステートマシンの遷移、作業の引き受け、エスカレーションは? Pythonです。 競合の解消、テストの問題の診断、戦略的なタスク分割は? Claudeです。
全体像は次のとおりです:
You
  ├─ CLI / Queen (TUI)
  └─ Daemon (background)
       ↓
SQLite Database (~/.hive/hive.db)
  ├─ Issues (work queue)
  ├─ Dependencies (DAG)
  ├─ Agents (ephemeral identity)
  ├─ Events (audit trail)
  ├─ Notes (inter-agent knowledge)
  └─ Merge Queue
       ↓
Orchestrator (async event loop)
  ├─ Main Loop (spawn workers when slots open)
  ├─ Event Consumer (status updates from backends)
  └─ Merge Processor (per-project)
       ↓
Backend Pool
  ├─ Claude WS Backend (claude CLI via WebSocket)
  ├─ Codex App Server Backend (stdio protocol)
  └─ Tau Backend (testing)
       ↓
Workers (each in its own git worktree)
ステートマシン
すべてのIssueは、7つの状態からなるライフサイクルをたどります。これはhiveを理解するうえで最も重要な点です。あらゆる設計判断が、このステートマシンの正しさを保つことから導かれているためです。
OPEN ──(claim)──→ IN_PROGRESS ──(success)──→ DONE ──(merge)──→ FINALIZED
  ↑                    │
  └──(retry/switch)────┘
                       │
                  (exhausted)──→ ESCALATED
                       │
                  (manual)─────→ CANCELED
エスカレーションの方針は3段階です。
- 同じエージェントで再試行します。試行回数は最大2回です。たまたまモデルの動作がうまくいかなかっただけかもしれません。
- エージェントを切り替えます。クリーンなワークツリーを持つ新しいエージェントに交代し、切り替えは最大2回までです。
- 人間にエスカレーションします。
異常検知の仕組みもあります。10分間に3回以上の失敗が発生すると、再試行回数の残りに関係なく、即座にエスカレーションします。 これにより、共通の原因による障害(壊れたテストスイート、依存関係の欠落、プロバイダー側の問題)を、トークンを浪費する前に検知できます。
作業の引き受け
readyキューの実体は、依存関係のDAGを解決するSQLクエリです:
SELECT * FROM issues
WHERE status = 'open'
  AND assignee IS NULL
  AND type != 'epic'
  AND NOT EXISTS (
    SELECT 1 FROM dependencies d
    JOIN issues blocker ON d.depends_on = blocker.id
    WHERE d.issue_id = issues.id
      AND blocker.status NOT IN ('done', 'finalized', 'canceled')
  )
ORDER BY priority ASC, created_at ASC
すべてのブロッカーが解消されて初めて、Issueは「ready」になります。
引き受けはCAS方式のアトミックな更新です。Issueがまだオープンで担当者が割り当てられていないことを確認し、依存関係が引き続き満たされていることも確認してから、1つのトランザクション内で更新します。2つのワーカーが同じIssueの取得を競うと、一方が勝ち、もう一方にはFalseが返ります。
バックエンドの抽象化
ここが、私が最も気に入っている部分です。
HiveBackendインターフェースには約15個のメソッドがあり、セッション管理(create_session、abort_session、get_session_status)、通信(send_message_async、get_messages、reply_permission)、イベントストリーミング(on(event_type, handler)、connect_with_reconnect())をカバーしています。
オーケストレーターは、どのバックエンドが動いているかを気にせず、ただインターフェースを呼び出します。
なぜこれが重要なのでしょうか? 最先端モデルの首位は、数か月ごとに入れ替わります。 また、モデルとCLIラッパーの組み合わせごとの振る舞いも、はっきりしていません(Claude Codeで動かすGPT 5.4はかなり良いと聞きます)。 モデルにもハーネスにも依存しない設計なら、ほかのすべてが急速に進化しても、オーケストレーションの中核コードを変える必要がありません。
マージパイプライン
ワーカーがIssueを完了すると、その成果はマージパイプラインに入ります。
マージは「Refinery」と呼ばれる専用のClaudeセッションが担当します。Refineryは競合の状況やテスト出力を受け取り、問題を解決して、構造化された結果ファイルを書き出します。変更をマージする(競合が解消され、テストが通った場合)、却下する(やり直しのためにopenへ戻す)、人間にエスカレーションする(複雑すぎる、または曖昧すぎる場合)という対応ができます。
Refineryはプロジェクトごとに長期間維持されるセッションで、複数回のマージ処理に再利用されます。コンテキストが蓄積しすぎた場合(10万トークン超、または20メッセージ超)、hiveはセッションを入れ替えてリフレッシュします。各プロジェクトには専用のMergeProcessorが割り当てられるため、複数のプロジェクトをオーケストレーションしても、プロジェクト間でマージ処理が競合することはありません。
エージェント間での知識の受け渡し
ワーカーは実行中に.hive-notes.jsonlを書きます:
{"category": "discovery", "content": "postgres dependency in main.py requires PGHOST to be set"}
{"category": "gotcha", "content": "tests require PYTHONPATH=src/"}
ワーカーが作業を完了すると、hiveはそのノートを収集し、データベースに保存します。関連するIssue(同じエピック、同じプロジェクト)のために新しいワーカーを起動するとき、hiveは関連するほかのワーカーのノートをプロンプトに挿入します。
つまり、エージェント#1がテストスイートには特定の環境変数が必要だと気づけば、関連タスクに取り組むエージェント#3は、作業を始める前からそのことを知っています。どのエージェントもすべての知識をコンテキスト内に保持する必要がなく、エージェント群全体で知識が蓄積されていきます。
Queen
Queenは、hiveとのやり取りの中心となる窓口です。
ターミナル内で動くClaudeセッションです(TUIモード)。
仕様を渡すと、コードベースを調査し、蓄積されたプロジェクトの知識を得るために.hive/project-context.mdを読み、依存関係を持つ複数のIssueへの分割を提案し、あなたの承認を待ってから、Issueを作成してデーモンを起動します。
スクリプト向けのヘッドレスモードもあります:
hive queen --headless -p "Bump all dependencies and update the lockfile"
Queenによって、個々のエージェントへの指示から、プロジェクトの管理へと軸足を移せます。 考えるのは、何をする必要があるか、そしてそれをどう分割するかです。
設定と改造のしやすさ
Hiveは4層構成の設定を使います:組み込みのデフォルト値 → グローバルTOML(~/.hive/config.toml) → プロジェクトTOML(.hive.toml) → 環境変数。注目したい設定項目は次のとおりです:
| 設定項目 | デフォルト値 | 制御する内容 |
|---|---|---|
max_agents |
3 | 同時実行するワーカー数 |
worker_model |
claude-sonnet-4-6 | 実装に使うモデル |
refinery_model |
claude-opus-4-6 | マージ競合の解消に使うモデル |
max_tokens_per_issue |
200,000 | Issueごとのトークン予算 |
max_retries |
2 | エージェント切り替え前の再試行回数 |
max_agent_switches |
2 | エスカレーション前の切り替え回数 |
backend |
claude | claude | codex |
test_command |
-- | マージの可否を判定するテストコマンド |
学んだこと
コードベースはPythonで約6,500行の規模です。 ローカルで動作し、リソースの使用を最小限に抑え、午後の数時間で全体を読んで改造を始められるほどシンプルになるよう設計されています。
hiveの開発を通じて私が学んだことを、いくつか挙げます:
この用途にふさわしいデータベースはSQLiteです。 WALモードなら書き込み中も並行して読み取りができ、busy_timeoutプラグマがロック競合をうまく処理してくれます。 連携を制御するレイヤー全体を、SQLクエリだけで実現できます。 3〜20個のエージェントの同時実行なら、SQLiteで十分すぎるほどですし、運用のシンプルさにも大きな価値があります。
Gitワークツリーは、今でも過小評価されています。 各エージェントには、そのリポジトリのmainから分岐した専用のワークツリーが割り当てられます。 互いのファイルに干渉することはなく、作業が終わったらリベースしてマージします。 失敗したら、ワークツリーを削除します。 分離は完璧で、後片付けも簡単です。
ノートの仕組みについては、今も確信が持てません。 エージェントがコードベースについて発見したことを仲間のエージェントと共有すれば、関連タスクの失敗率を目に見えて下げられるはずだというのは、筋の通った考えです。 でも、その効果を正確に測るタスクやベンチマークを設計するのは難しいのです。 今後、もっと掘り下げていくべきテーマです。
コードはgithub.com/nwyin/hiveにあります。MITライセンスを採用しており、フォークして改造しやすいように設計されています。 tmuxで3つ以上のエージェントを管理していて、もう少し体系立った仕組みが欲しいなら、ぜひ見てみてください。