內容
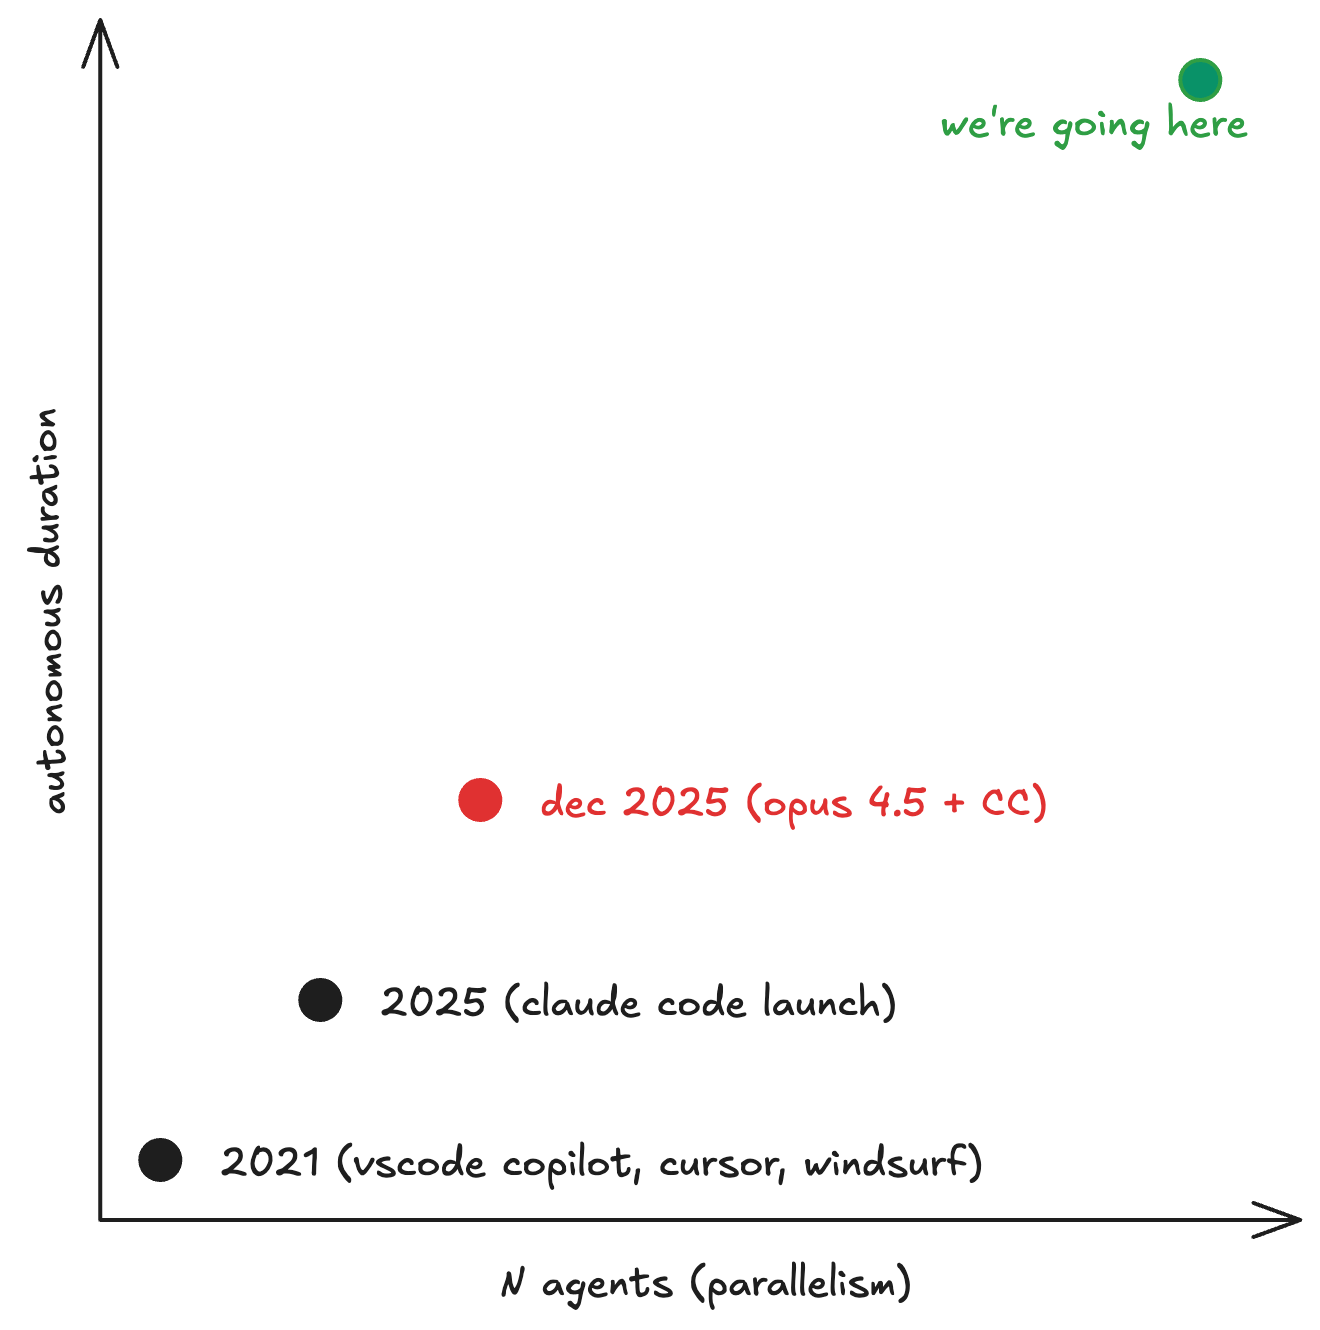
2025 年是代理之年。 Claude Code 讓與 LLM 合作,變得像是與一位技術很強、但經驗不足的初階開發者進行結對程式設計。 2025 年 12 月的某個時候,隨著 Opus 4.5 發布,模型能力開始出現明顯的躍升。 Claude 能夠連續好幾個小時獨立工作。
下一步顯然就是 tmux 多個 Claude Code 執行個體,讓它們各自處理不同的議題。
這種做法變得如此普遍,連 Anthropic 都開始稱它為「multi-Clauding」。
按照 Steve Yegge 的說法,這屬於代理式程式開發的第 6/7 級。
tmux 很棒,但認知負擔會變得極為沉重。
你得不斷在構思、引導與審查之間切換。
很明顯,你自己就是瓶頸,而你管理不了更多代理,是個「能力問題」。
總該有更好的辦法。
所以我做了 hive。
這是什麼
Hive 是以 Python 撰寫、採用單一行程與非同步架構的協調器,透過 SQLite 佇列協調多個 LLM 程式開發代理,並以 git worktree 作為執行沙箱。
它有三個運作元件。 蜂后是一個擔任你專案經理的 Claude 工作階段:你描述工作內容,她探索程式碼庫、提出含有相依關係的議題拆分方案,然後等待你的核准。 工作代理是並行運作的 Claude(或 Codex)工作階段,各自在自己的 git worktree 中,從佇列認領議題並實作。 合併管線則是另一個代理,負責對已完成的工作執行 rebase 和測試,並將成果合併回 main。
核心設計原則:確定性的協調工作由 Python 負責,模糊情況下的決策則交給 LLM 工作階段。 狀態機轉移、任務認領、升級處理? Python。 解決衝突、診斷測試問題、策略性拆分? Claude。
以下是完整的架構:
You
  ├─ CLI / Queen (TUI)
  └─ Daemon (background)
       ↓
SQLite Database (~/.hive/hive.db)
  ├─ Issues (work queue)
  ├─ Dependencies (DAG)
  ├─ Agents (ephemeral identity)
  ├─ Events (audit trail)
  ├─ Notes (inter-agent knowledge)
  └─ Merge Queue
       ↓
Orchestrator (async event loop)
  ├─ Main Loop (spawn workers when slots open)
  ├─ Event Consumer (status updates from backends)
  └─ Merge Processor (per-project)
       ↓
Backend Pool
  ├─ Claude WS Backend (claude CLI via WebSocket)
  ├─ Codex App Server Backend (stdio protocol)
  └─ Tau Backend (testing)
       ↓
Workers (each in its own git worktree)
狀態機
每個議題都會經歷包含 7 種狀態的生命週期。這是理解 hive 最重要的部分,因為 每一項設計決策 都以維持這個狀態機的正確性為出發點。
OPEN ──(claim)──→ IN_PROGRESS ──(success)──→ DONE ──(merge)──→ FINALIZED
  ↑                    │
  └──(retry/switch)────┘
                       │
                  (exhausted)──→ ESCALATED
                       │
                  (manual)─────→ CANCELED
升級處理策略依序分為三個層級。
- 由同一個代理重試,最多嘗試 2 次。也許模型只是這一次表現失常。
- 更換代理,改用一個全新且配有乾淨 worktree 的代理,最多更換 2 次。
- 轉交人工處理。
另外還有異常偵測器:在 10 分鐘的時間窗內出現 3 次以上失敗,就會立即觸發升級處理,不受重試次數限制。 這能在 token 被耗光之前,偵測出系統性故障(測試套件損壞、缺少相依項目、供應商問題)。
認領工作
就緒佇列是一段會解析相依關係 DAG 的 SQL 查詢:
SELECT * FROM issues
WHERE status = 'open'
  AND assignee IS NULL
  AND type != 'epic'
  AND NOT EXISTS (
    SELECT 1 FROM dependencies d
    JOIN issues blocker ON d.depends_on = blocker.id
    WHERE d.issue_id = issues.id
      AND blocker.status NOT IN ('done', 'finalized', 'canceled')
  )
ORDER BY priority ASC, created_at ASC
只有在所有阻擋它的議題都已解決後,議題才會變成「就緒」。
認領採用 CAS 式的原子更新:確認議題仍處於開啟狀態且未指派負責人、確認相依條件仍然滿足,然後在單一交易中完成更新。若兩個工作代理同時爭取同一個議題,其中一個會成功,另一個則會收到 False。
後端抽象層
這是我最滿意的部分。
HiveBackend 介面約有 15 個方法,涵蓋工作階段管理(create_session、abort_session、get_session_status)、通訊(send_message_async、get_messages、reply_permission),以及事件串流(on(event_type, handler)、connect_with_reconnect())。
協調器不在乎執行的是哪個後端;它只會呼叫介面。
這為什麼重要? 前沿模型的領先寶座每隔幾個月就會易主。 而不同模型與不同 CLI 封裝工具搭配時會如何互動,也還不明朗(我聽說在 Claude Code 中使用 GPT 5.4 相當不錯)。 不綁定特定模型或執行框架,意味著當其他一切都在快速迭代時,核心協調程式碼也不必隨之更動。
合併管線
工作代理完成一個議題後,工作成果就會進入合併管線。
合併由一個名為「Refinery」的專用 Claude 工作階段處理。Refinery 會取得衝突的上下文或測試輸出,解決問題,並寫出一份結構化的結果檔。它可以合併工作成果(衝突已解決、測試通過)、退回(送回 open 重新處理),或轉交人工處理(過於複雜或不明確)。
每個專案都有一個長期存續的 Refinery 工作階段,會在多次合併作業中重複使用。當累積的上下文過多(>100k token 或 >20 則訊息)時,hive 就會重開工作階段,讓上下文保持清爽。每個專案都有自己的 MergeProcessor,因此同時協調多個專案也不會造成跨專案的合併爭用。
代理之間的知識傳遞
工作代理會在執行期間寫入 .hive-notes.jsonl:
{"category": "discovery", "content": "postgres dependency in main.py requires PGHOST to be set"}
{"category": "gotcha", "content": "tests require PYTHONPATH=src/"}
工作代理完成工作後,hive 會收集它的筆記並存入資料庫。在為相關議題(同一個 epic、同一個專案)啟動新的工作代理時,hive 會將同組代理的相關筆記注入提示詞。
這代表,如果 1 號代理發現測試套件需要特定的環境變數,3 號代理(處理相關任務)在開始之前就會知道這件事。知識會在整個代理群中累積,任何單一代理都不必將所有知識保留在上下文中。
蜂后
蜂后是你與 hive 互動的主要窗口。
它是一個在你的終端機中執行的 Claude 工作階段(TUI 模式)。
你給它一份規格,它就會探索程式碼庫、讀取 .hive/project-context.md 以取得累積的專案知識、提出含有相依關係的議題拆分方案,等待你的核准,然後建立議題並啟動常駐程式。
另外也有供指令碼使用的無介面模式:
hive queen --headless -p "Bump all dependencies and update the lockfile"
透過蜂后,你就能從引導個別代理,轉為管理整個專案。 你思考的是需要做 什麼,以及 如何拆分工作。
設定與可改造性
Hive 採用 4 層設定堆疊:內建預設值 → 全域 TOML(~/.hive/config.toml)→ 專案 TOML(.hive.toml)→ 環境變數。以下是幾個有意思的設定項目:
| 設定 | 預設值 | 控制內容 |
|---|---|---|
max_agents |
3 | 並行工作代理數 |
worker_model |
claude-sonnet-4-6 | 實作使用的模型 |
refinery_model |
claude-opus-4-6 | 處理合併衝突的模型 |
max_tokens_per_issue |
200,000 | 每個議題的 token 預算 |
max_retries |
2 | 更換代理前的重試次數 |
max_agent_switches |
2 | 升級處理前的代理更換次數 |
backend |
claude | claude | codex |
test_command |
-- | 合併關卡的測試指令 |
我學到的事
整個程式碼庫約有 6,500 行 Python 程式碼。 它的設計目標是在本機執行、耗用極少資源,而且足夠簡單,讓你能在一個下午讀完整份程式碼,並開始動手修改。
開發 hive 的過程中,我學到了一些事:
SQLite 就是適合這項工作的資料庫。 WAL 模式讓你能在寫入期間並行讀取,而 busy_timeout pragma 能妥善處理鎖定爭用。 整個協調層都可以只靠 SQL 查詢實作。 對 3-20 個並行代理而言,SQLite 綽綽有餘,而且維運簡便也很有價值。
Git worktree 仍然被低估了。 每個代理都有屬於自己的儲存庫 worktree,從 main 建立分支。 它們無法干擾彼此的檔案,工作完成後,再進行 rebase 與合併。 如果失敗,就刪除 worktree。 隔離效果完美,清理也輕而易舉。
筆記系統這部分,我還沒有定論。 按理說,代理發現程式碼庫的相關資訊,並與同組代理分享這些發現,應該能有效降低相關任務的失敗率。 但要設計出能準確衡量這一點的任務與基準測試,並不容易。 未來還需要投入許多工作來探索這一點。
程式碼放在 github.com/nwyin/hive。它採用 MIT 授權,設計上就是要讓人 fork 並動手修改。 如果你正在 tmux 裡管理 3 個以上的代理,想要更有條理的做法,不妨看看。