内容
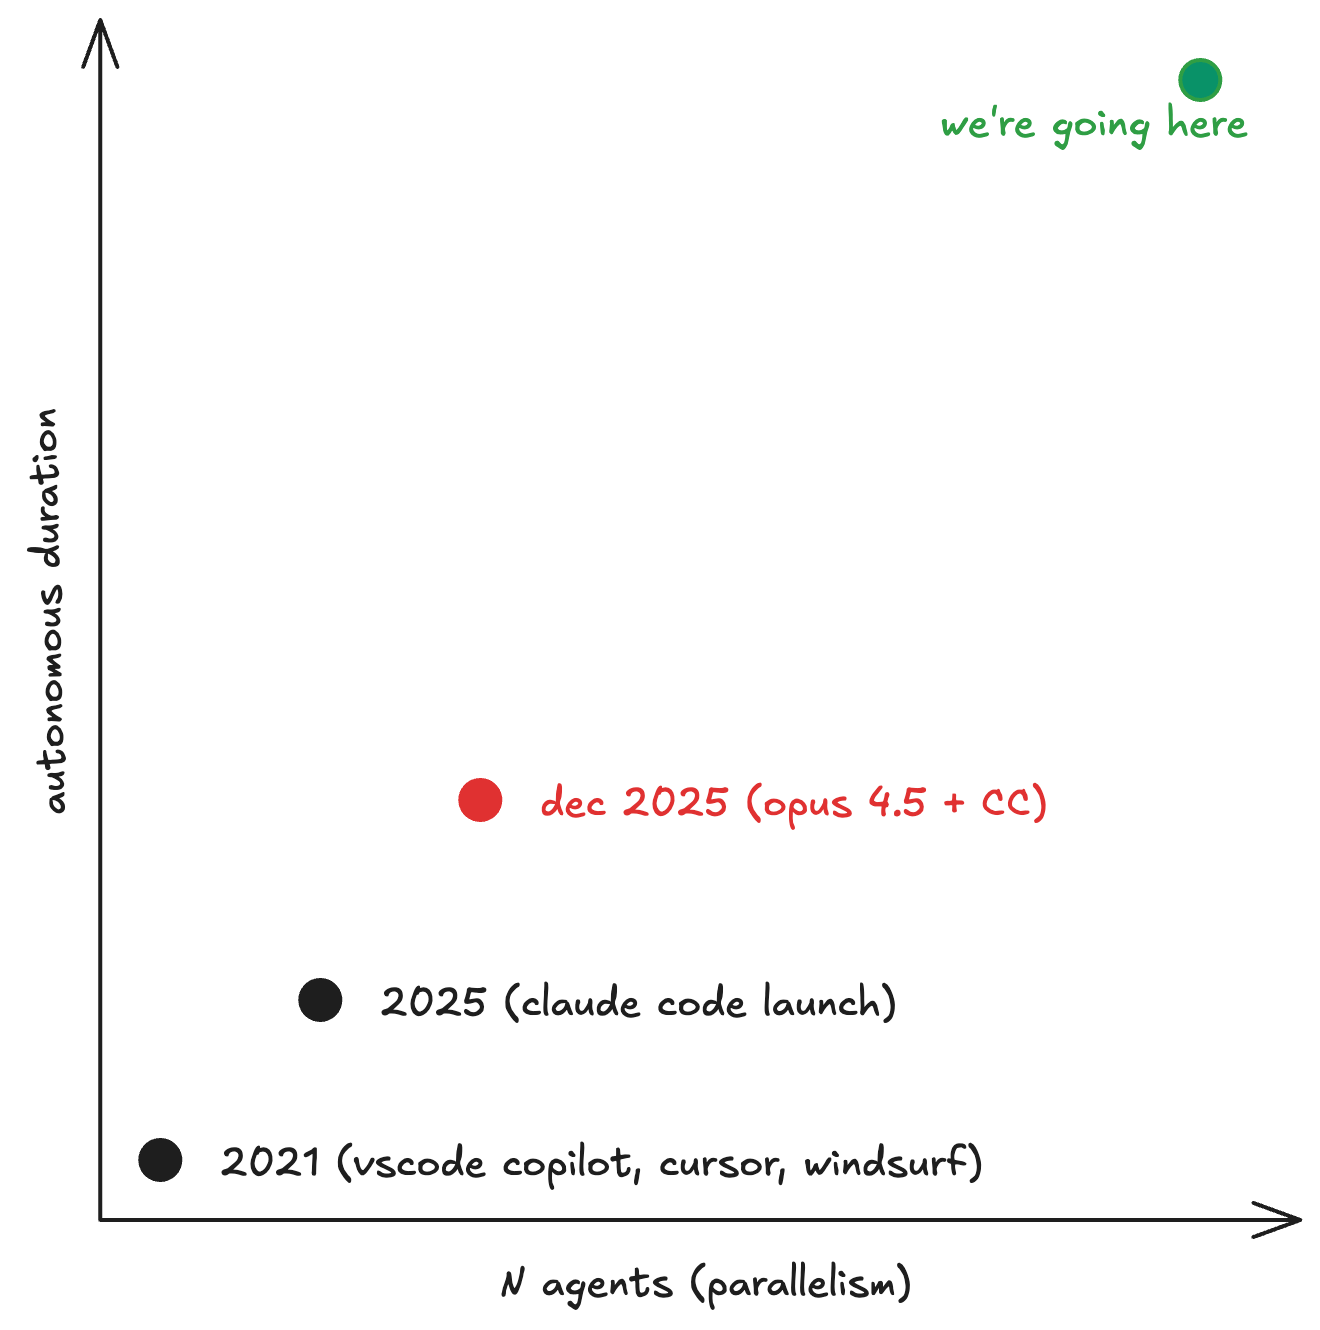
2025 年是智能体之年。 Claude Code 让与 LLM 协作变得像是在和一位技能娴熟但经验不足的初级开发者结对编程。 2025 年 12 月的某个时候,随着 Opus 4.5 的发布,模型能力出现了明显的跃升。 Claude 已经可以一次连续自主工作好几个小时。
显而易见的下一步,就是 tmux 多个 Claude Code 实例,让它们分别处理不同的任务。
这种做法变得如此普遍,以至于 Anthropic 开始将其称为“multi-Clauding”。
按照 Steve Yegge 的说法,这属于智能体编程的第 6/7 级。
tmux 很棒,但认知负担会变得极其沉重。
你得不断在构思、引导和审查之间切换。
很明显,你自己成了瓶颈,而你没法管理更多智能体,是个“水平问题”。
肯定有更好的办法。
于是我做了 hive。
它是什么
Hive 是一个单进程的异步 Python 编排器,通过 SQLite 队列协调多个 LLM 编程智能体,并使用 git 工作树作为执行沙箱。
它有三个组成部分。 蜂后是一个担任项目经理的 Claude 会话:你描述要做的工作,她探索代码库,提出将工作拆分为带有依赖关系的任务的方案,然后等待你批准。 工作智能体是并行运行的 Claude(或 Codex)会话,每个会话都有自己的 git 工作树,从队列中领取任务并实现。 合并流水线是另一个智能体,负责变基、测试,并将完成的工作合并回 main。
核心设计原则是:由 Python 负责确定性的编排,将存在模糊性的决策交给 LLM 会话。 状态机转换、任务领取、升级处理? Python。 冲突解决、测试问题诊断、策略性的任务拆分? Claude。
完整图景如下:
You
  ├─ CLI / Queen (TUI)
  └─ Daemon (background)
       ↓
SQLite Database (~/.hive/hive.db)
  ├─ Issues (work queue)
  ├─ Dependencies (DAG)
  ├─ Agents (ephemeral identity)
  ├─ Events (audit trail)
  ├─ Notes (inter-agent knowledge)
  └─ Merge Queue
       ↓
Orchestrator (async event loop)
  ├─ Main Loop (spawn workers when slots open)
  ├─ Event Consumer (status updates from backends)
  └─ Merge Processor (per-project)
       ↓
Backend Pool
  ├─ Claude WS Backend (claude CLI via WebSocket)
  ├─ Codex App Server Backend (stdio protocol)
  └─ Tau Backend (testing)
       ↓
Workers (each in its own git worktree)
状态机
每项任务都会经历一个包含 7 种状态的生命周期。这是理解 hive 最重要的一点,因为每一项设计决策都围绕着确保这个状态机的正确性展开。
OPEN ──(claim)──→ IN_PROGRESS ──(success)──→ DONE ──(merge)──→ FINALIZED
  ↑                    │
  └──(retry/switch)────┘
                       │
                  (exhausted)──→ ESCALATED
                       │
                  (manual)─────→ CANCELED
升级处理策略分为三级。
- 用同一个智能体重试,最多尝试 2 次。也许模型只是这一次没发挥好。
- 切换智能体,换一个全新的智能体,使用干净的工作树,最多切换 2 次。
- 转交人工处理。
此外还有一个异常检测器:在 10 分钟的时间窗口内出现 3 次或更多失败,就会立即触发升级处理,跳过重试次数限制。 这样可以在系统性故障(测试套件损坏、缺少依赖、服务提供商出问题)消耗大量 token 之前发现它们。
领取任务
就绪队列通过一条 SQL 查询来解析依赖关系 DAG:
SELECT * FROM issues
WHERE status = 'open'
  AND assignee IS NULL
  AND type != 'epic'
  AND NOT EXISTS (
    SELECT 1 FROM dependencies d
    JOIN issues blocker ON d.depends_on = blocker.id
    WHERE d.issue_id = issues.id
      AND blocker.status NOT IN ('done', 'finalized', 'canceled')
  )
ORDER BY priority ASC, created_at ASC
只有当所有阻塞该任务的依赖都已解决时,它才会进入“就绪”状态。
领取任务采用 CAS 式的原子更新:在单个事务中,先确认任务仍处于开放状态且尚无负责人,再确认依赖条件仍然满足,最后完成更新。如果两个工作智能体争抢同一项任务,一个会成功,另一个则会收到 False。
后端抽象
这是我最满意的部分。
HiveBackend 接口大约有 15 个方法,涵盖会话管理(create_session、abort_session、get_session_status)、通信(send_message_async、get_messages、reply_permission)和事件流(on(event_type, handler)、connect_with_reconnect())。
编排器不关心运行的是哪个后端,只管调用接口。
为什么这一点很重要? 前沿模型中最先进的那个,每隔几个月就会换一个。 而且,不同模型与不同 CLI 封装工具搭配时会有什么表现,目前也不明确(听说 GPT 5.4 在 Claude Code 中的表现相当不错)。 不依赖特定模型或运行框架,意味着即使其他一切都在快速迭代,核心编排代码也无需随之改变。
合并流水线
工作智能体完成一项任务后,成果就会进入合并流水线。
合并由一个名为“Refinery”的专用 Claude 会话处理。Refinery 会获取冲突上下文或测试输出,解决问题,并写出一份结构化的结果文件。它可以合并成果(冲突已解决、测试已通过),也可以拒绝合并(退回 open 返工),或者转交人工处理(问题过于复杂或模糊)。
每个项目都有一个长期运行的 Refinery 会话,在多次合并操作中复用。当它积累的上下文过多(>100k token 或 >20 条消息)时,hive 就会更换会话,以保持上下文清爽。每个项目都有自己的 MergeProcessor,因此多项目编排不会造成跨项目的合并争用。
智能体之间的知识传递
工作智能体会在执行过程中编写 .hive-notes.jsonl:
{"category": "discovery", "content": "postgres dependency in main.py requires PGHOST to be set"}
{"category": "gotcha", "content": "tests require PYTHONPATH=src/"}
工作智能体完成任务后,hive 会收集它的笔记并存入数据库。为相关任务(同一 epic、同一项目)启动新的工作智能体时,hive 会将相关的同级任务笔记注入提示词。
这意味着,如果 1 号智能体发现测试套件需要某个特定的环境变量,3 号智能体(正在处理相关任务)在开始之前就会知道这一点。知识会在整个智能体群中不断积累,无需任何一个智能体在上下文中保留全部知识。
蜂后
蜂后是与 hive 交互的主要入口。
她是一个在终端中运行的 Claude 会话(TUI 模式)。
你给她一份需求说明,她便会探索代码库,读取 .hive/project-context.md 以了解积累的项目知识,提出将工作拆分为带有依赖关系的任务的方案,等待你批准,然后创建任务并启动守护进程。
此外还有供脚本使用的无界面模式:
hive queen --headless -p "Bump all dependencies and update the lockfile"
通过蜂后,你可以从引导单个智能体转向管理整个项目。 你思考的是需要做什么,以及如何拆分工作。
配置与可改造性
Hive 使用四层配置:内置默认值 → 全局 TOML(~/.hive/config.toml) → 项目 TOML(.hive.toml) → 环境变量。几个值得关注的配置项:
| 配置项 | 默认值 | 控制内容 |
|---|---|---|
max_agents |
3 | 并发工作智能体数量 |
worker_model |
claude-sonnet-4-6 | 用于实现任务的模型 |
refinery_model |
claude-opus-4-6 | 用于处理合并冲突的模型 |
max_tokens_per_issue |
200,000 | 每项任务的 token 预算 |
max_retries |
2 | 切换智能体前的重试次数 |
max_agent_switches |
2 | 升级处理前的切换次数 |
backend |
claude | claude | codex |
test_command |
-- | 合并准入检查的测试命令 |
我的心得
代码库大约有 6,500 行 Python 代码。 它的设计目标是在本地运行、尽量少占用资源,而且足够简单,让你一个下午就能读完整个代码库并开始动手修改。
开发 hive 的过程中,我学到了一些东西:
SQLite 很适合这里的需求。 WAL 模式支持在写入时并发读取,busy_timeout pragma 则能妥善处理锁争用。 整个协调层都可以只用 SQL 查询来实现。 对于 3 到 20 个并发智能体,SQLite 绰绰有余,而运维上的简单也很有价值。
Git 工作树仍然被低估了。 每个智能体都会获得仓库的一个独立工作树,从 main 创建分支。 它们不会互相覆盖文件,工作完成后,进行变基再合并即可。 失败了就删掉工作树。 隔离效果非常好,清理也轻而易举。
我对笔记系统仍有些拿不准。 从道理上说,智能体发现代码库中的信息,再将这些发现分享给同级智能体,应该能明显降低相关任务的失败率。 但要设计出能准确衡量这一效果的任务和基准测试,并不容易。 今后还有很多工作应该探索这一点。
代码在 github.com/nwyin/hive。它采用 MIT 许可证,设计时就希望大家能 fork 并动手改造。 如果你正在 tmux 中管理 3 个或更多智能体,想要一套更有条理的方案,不妨看看。