يتيح لنا تدريب النماذج على التنسيق بين وكلاء متعددين استثمار قدر أكبر بكثير من موارد الحوسبة بصورة منتجة خلال مرحلة ما بعد التدريب، مقارنةً بإعدادات التعلّم المعزز الحالية التي تعتمد على وكيل واحد.
من الحلقة الأخيرة من بودكاست دواركيش مع نوام براون:
نوام براون
لكن هذه نقطة بيانات واحدة. لا نعرف كم من الوقت سيستغرق وكيل واحد لحل معادلات نافييه-ستوكس، لأننا لم نُجرِ تلك التجربة بعد. ربما نفعل، لكن ذلك أيضًا مجرد نقطة بيانات واحدة.
إذا أردنا إجراء دراسة استبعاد شاملة ، فالتجارب باهظة التكلفة جدًا على ذلك النطاق. لذا علينا إجراء نوع من البحث العلمي المنهجي في ما يحدث عندما ننتقل إلى 64 أو 128 أو 256 أو نحو ذلك، لنكوّن تصورًا عن السلوك. لكن سيكون من الصعب جدًا الوصول بذلك إلى 10,000، ومعرفة الفائدة التي حققناها فعلًا من استخدام 10,000 وكيل مقارنةً باستخدام 1,000 على وجه اليقين.
هناك أمر واحد أريد توضيحه. إن الجهد المبذول لحل إحدى مسائل جائزة الألفية لم يكن بفضل تعدد الوكلاء. ولا أنسب حتى 10% من الفضل إلى تعدد الوكلاء. الواقع هو أن OpenAI درّبت نموذجًا قويًا جدًا. يمكننا جعل ذلك النموذج يعمل على امتداد آفاق زمنية طويلة جدًا. ويمكننا جعله يفكّر بالتوازي.
لكن السبب الأساسي الذي يمكّننا من فعل ذلك هو أن لدينا ببساطة نموذجًا عامًا للأغراض وقويًا جدًا. أمور مثل تعدد الوكلاء جديدة ولافتة للأنظار، وربما تنال لهذا السبب قدرًا مبالغًا فيه من الفضل. لكن السبب الجوهري هو أن هذا ببساطة نموذج قوي جدًا.
يشير نوام إلى الإعلان عن GPT-5.6.
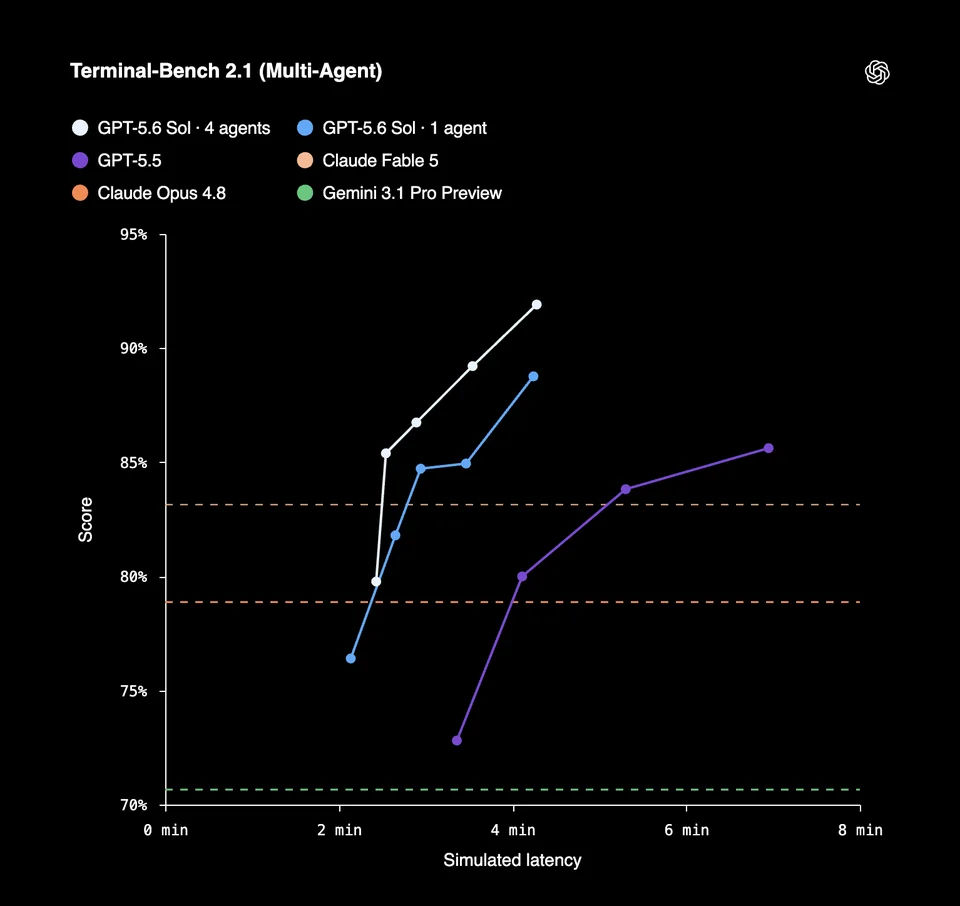
ويلمّح أيضًا دليل OpenAI للمطوّرين حول GPT-5.6 إلى موضع إدخال السلوك متعدد الوكلاء ضمن منظومة التدريب (خلال مرحلة ما بعد التدريب بالتعلّم المعزز):
درّبنا GPT-5.6 من البداية إلى النهاية باستخدام ثلاثة تدخلات معمارية متكاملة تتيح للوكلاء العمل بكفاءة أكبر:
- إعادة استخدام العمل المنجَز بالفعل: من خلال السماح بالاحتفاظ بالاستدلال عبر جولات تفاعل النموذج، واستخدام آلية ضغط مدمجة لضغط المحادثات الممتدة، يستطيع النموذج الحفاظ على اتساق عمله على مدى مهام أطول أمدًا، دون أن يرتبك أو يضطر إلى إعادة بناء السياق السابق.
- التقسيم إلى مهام متوازية عند الاقتضاء: يتيح استخدام التنسيق المدمج متعدد الوكلاء تنسيق عمل عدة وكلاء عبر مسارات عمل متوازية لإنجاز المهام المعقدة بسرعة أكبر.
- نقل العمل الحتمي إلى الشيفرة: باستخدام استدعاء الأدوات برمجيًا لتصفية مخرجات الأدوات وتجميعها وتنسيقها خارج نافذة سياق النموذج، مع تخصيص رموز النموذج لإصدار الأحكام التقديرية وتقليل التكلفة وزمن الاستجابة وتدهور السياق.
البنية التحتية اللازمة لتنسيق تحديثات أوزان النموذج مع عمل وحدات الاستدلال التي تولّد جولات تنفيذ للتعلّم المعزز معقّدة. وناثان لامبرت كتب عن بعض أعمال هندسة الأنظمة اللازمة لجعل التدريب بالتعلّم المعزز أكثر كفاءة.
تبدو الصورة المبسّطة بإفراط لنظام تدريب بالتعلّم المعزز على النحو الآتي تقريبًا:
- مجموعة من وحدات التعلّم التي تحدّث أوزان النموذج؛
- مجموعة من وحدات الاستدلال التي تستخدم نسخةً ما من تلك الأوزان لتوليد جولات تنفيذ؛
- بنية تحتية تنقل الأوزان والمكافآت وبيانات الحالة الأخرى بين المجموعتين.
في مهمة ينفّذها وكيل واحد، تتمثّل جولة التنفيذ الواحدة في توليد نموذجٍ لمسار خطّي (استدعاءات أدوات، ورموز مخرجات).
لكن ما إن تصبح السياسة التي يجري تدريبها قادرة على إنشاء وكلاء آخرين وتنسيق عملهم، حتى يتّسع نطاق جولة التنفيذ الواحدة. إذ تصبح الجولة الواحدة شجرة غير متزامنة تضم عشرات أو مئات من مسارات النماذج.
يعني هذا أن مقدار موارد حوسبة الاستدلال التي يمكن توظيفها بصورة مفيدة لإنتاج مسار تدريبي واحد قد يزداد بدرجة هائلة. وإذا أردت أن يتعلّم النموذج سلوكًا جيدًا في التنسيق - لا أن تكتفي بإضافة طبقة تنسيق إلى نموذج سبق تدريبه - فستريد إدراج بعض هذه المسارات الكبيرة متعددة الوكلاء ضمن حلقة ما بعد التدريب.
أخمّن أن النسخة الداخلية من Astra تُدرَّب بوصفة منقّحة لتشجيع سلوك التنسيق المدمج متعدد الوكلاء. وحتى مع هذه الوصفة المنقّحة، يُرجَّح أن بعض السلوكيات الغريبة ما زالت تحتاج إلى معالجة، ولهذا يعزو نوام أقل من 10% من نتائج نافييه-ستوكس إلى كون النظام الذي استخدموه لإنتاج الحل متعدد الوكلاء.
ومع تحسين الوصفة، سنرى أنظمة متعددة الوكلاء تعمل بكفاءة أكبر وتُظهر سلوكًا أكثر اتساقًا. فبدلًا من إنفاق 300 مليار رمز لإنتاج حل، قد ينتج سرب أكثر كفاءة من الوكلاء حلًا باستخدام عدد أقل بكثير من الرموز.
وكما يذكر نوام أيضًا في المقابلة، ما تزال هذه العملية التدريبية هشّة. فمن الصعب تشجيع النماذج على استخدام التواصل بين المثيلات بفاعلية؛ وغالبًا ما سترى مسارات "غير مجدية" لا تتواصل فيها النماذج ولا تضيف أي سياق إلى مثيلات أخرى على الإطلاق.
لكن في ضوء التفاؤل والشائعات المتعلقة بالنموذج الجديد من فئة GPT-6، يبدو أن فريق OpenAI قد أحرز بالفعل تقدمًا كبيرًا في هذا الاتجاه.
نُشر أصلًا على LessWrong.