Modelleri birden fazla ajan arasında koordinasyon sağlayacak şekilde eğitmek, eğitim sonrası aşamada mevcut tek ajanlı RL düzeneklerine kıyasla çok daha fazla hesaplama kaynağını verimli biçimde kullanmamıza olanak tanıyor.
Yakın zamanda yayımlanan Noam Brown'ın konuk olduğu Dwarkesh Podcast bölümünden:
Noam Brown
Ama bu tek bir veri noktası. Tek bir ajanın Navier-Stokes'u çözmesinin ne kadar süreceğini bilmiyoruz, çünkü o deneyi henüz yapmadık. Belki yaparız, ama bu da yalnızca tek bir veri noktası olur.
Eğer kapsamlı bir ablasyon çalışması yapmak istiyorsak, bu ölçekte deneylerin maliyeti çok yüksek. Dolayısıyla 64, 128, 256 gibi sayılara çıktığımızda neler olduğunu sistematik bir bilimsel yaklaşımla incelememiz ve davranış hakkında fikir edinmemiz gerekiyor. Ama bunu 10.000'e kadar götürmek ve 1.000 yerine 10.000 ajan kullanmanın bize gerçekte ne kadar fayda sağladığını kesin olarak bilmek çok zor olacak.
Açıklığa kavuşturmak istediğim bir şey var. Milenyum Ödüllü Problemlerden birini çözmeye yönelik bu çalışma, çok ajanlı yapı sayesinde gerçekleşmedi. Başarının %10'unu bile çok ajanlı yapıya atfetmem. Gerçek şu ki OpenAI çok güçlü bir model eğitti. Bu modelin çok uzun süreler boyunca çalışmasını sağlayabiliyoruz. Paralel düşünmesini sağlayabiliyoruz.
Ama özünde bunu yapabilmemizin nedeni, elimizde genel amaçlı, çok güçlü bir model olması. Çok ajanlı yapı gibi şeyler gösterişli ve yeni; muhtemelen bu yüzden başarıdaki payları olduğundan büyük görülüyor. Ama asıl neden, bunun çok güçlü bir model olması.
Noam, GPT-5.6 duyurusuna atıfta bulunuyor.
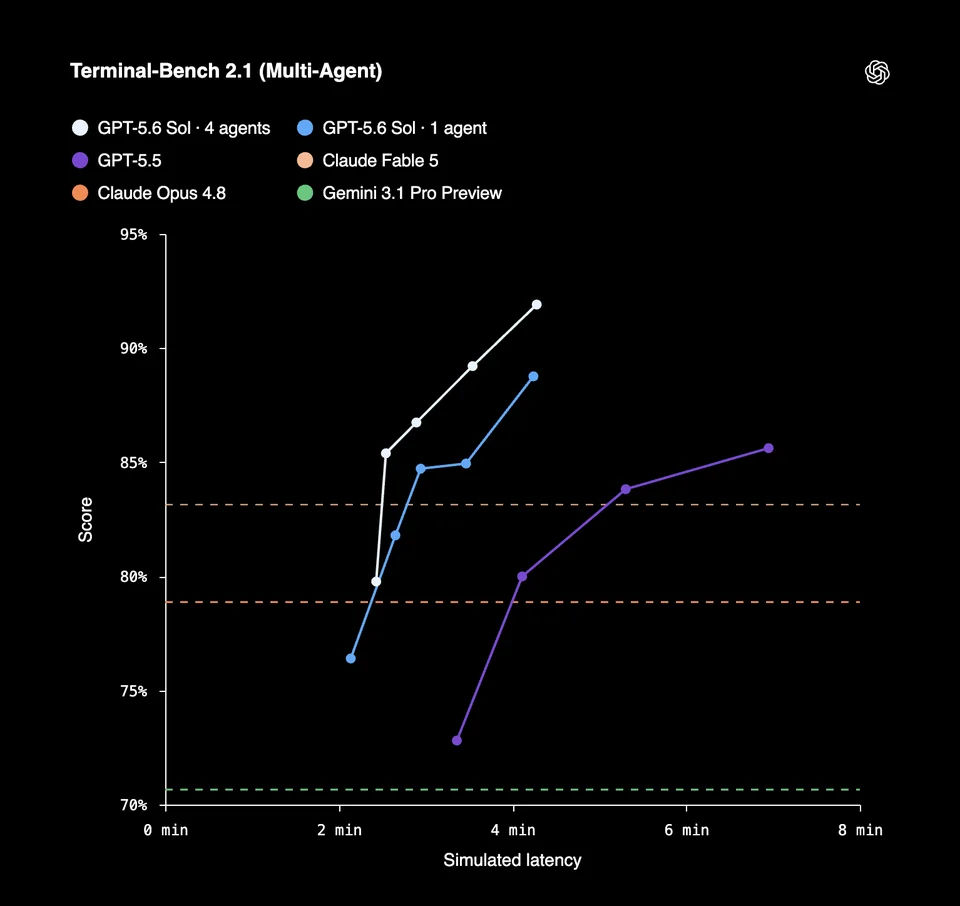
OpenAI GPT-5.6 Geliştirici Rehberi de çok ajanlı davranışın eğitim sürecinin hangi aşamasında devreye girdiğine dair ipuçları veriyor (RL ile eğitim sonrası aşamada):
GPT-5.6'yı, birbirini tamamlayan üç mimari müdahaleyle uçtan uca eğittik; bu müdahaleler ajanların daha verimli çalışmasını sağlıyor:
- Daha önce yapılan çalışmaları yeniden kullanma: akıl yürütmenin model turları arasında korunmasına olanak tanınması ve uzun süren konuşmaları sıkıştırmak için yerleşik sıkıştırmanın kullanılması sayesinde model, daha uzun süreye yayılan görevlerde kafa karışıklığı yaşamadan veya önceki bağlamı yeniden oluşturmak zorunda kalmadan çalışmasındaki tutarlılığı koruyabilir.
- Uygun olduğunda paralel parçalara ayırma: yerleşik çok ajanlı orkestrasyon kullanımı, karmaşık görevleri daha hızlı tamamlamak için paralel iş akışlarında birden fazla ajanın koordine edilmesini sağlar.
- Deterministik işleri koda taşıma: araç çıktılarını modelin bağlam penceresinin dışında filtrelemek, toplulaştırmak ve yönetmek için programatik araç çağrılarını kullanarak model tokenlarını muhakemeye ayırmak ve maliyeti, gecikmeyi ve bağlam bozulmasını azaltmak.
Model ağırlık güncellemelerini RL rolloutları üreten çıkarım işçileriyle koordine etmek için gereken altyapı karmaşık. Nathan Lambert, RL eğitimini verimli hâle getirmek için gereken sistem çalışmalarının bir kısmı üzerine yazdı.
Bir RL eğitim sisteminin fazlasıyla basitleştirilmiş bir tasviri aşağı yukarı şöyledir:
- model ağırlıklarını güncelleyen bir grup öğrenici işçi;
- rolloutlar üretmek için bu ağırlıkların bir sürümünü kullanan bir grup çıkarım işçisi;
- ikisi arasında ağırlıkları, ödülleri ve diğer durum bilgilerini taşıyan altyapı.
Tek ajanlı bir görevde bir rollout, modelin doğrusal bir yörünge (araç çağrıları, çıktı tokenları) üretmesinden oluşur.
Ancak eğitilen politika başka ajanlar oluşturup koordine edebildiğinde, rollout birimi de büyür. Bir rollout artık onlarca veya yüzlerce model yörüngesi içeren asenkron bir ağaç hâline gelir.
Bu, tek bir eğitim yörüngesini üretmek için faydalı biçimde kullanılabilecek çıkarım hesaplama kaynağı miktarının çarpıcı ölçüde artabileceği anlamına geliyor. Ve modelin iyi bir koordinasyon davranışı öğrenmesini istiyorsanız - önceden eğitilmiş bir modele yalnızca bir orkestrasyon katmanı eklemek yerine - bu büyük çok ajanlı yörüngelerin bir kısmını eğitim sonrası aşamanın döngüsüne dahil etmek istersiniz.
Astra'nın kurum içi sürümünün, yerleşik çok ajanlı orkestrasyon davranışını teşvik etmek için iyileştirilmiş bir reçeteyle eğitildiğini tahmin ediyorum. Bu iyileştirilmiş reçeteyle bile muhtemelen hâlâ giderilmesi gereken bazı pürüzler var; Noam'ın Navier-Stokes sonuçlarının %10'undan azını, çözümü üretmek için kullandıkları sistemin çok ajanlı yapısına bağlamasının nedeni de bu.
Reçete geliştirildikçe çok ajanlı sistemlerin daha verimli çalıştığını ve daha tutarlı davrandığını göreceğiz. Daha verimli bir çok ajanlı sürü, bir çözüm üretmek için 300 milyar token harcamak yerine çok daha az tokenla çözüm üretebilir.
Noam'ın söyleşide de belirttiği gibi, bu eğitim süreci hâlâ kırılgan. Modelleri, model örnekleri arasındaki iletişimi etkili biçimde kullanmaya teşvik etmek zor; modellerin diğer model örnekleriyle hiç iletişim kurmadığı ve onlara hiç bağlam aktarmadığı "işe yaramaz" yörüngelere sık sık rastlıyorsunuz.
Yine de yeni GPT-6 seviyesindeki modele ilişkin iyimserliğe ve söylentilere bakılırsa, OpenAI ekibi bu yönde şimdiden önemli ilerleme kaydetmiş gibi görünüyor.
İlk olarak LessWrong'da yayımlandı.