训练模型学会在多个智能体之间进行协调,让我们能够在后训练中有效利用远多于当前单智能体 RL 配置所用的算力。
以下摘自近期的 Dwarkesh 播客对 Noam Brown 的访谈:
Noam Brown
但那只是一个数据点。我们不知道单个智能体需要多长时间才能解决 Navier-Stokes 问题,因为我们还没有做过那个实验。也许我们会做,但那也只是一个数据点。
如果我们想做一次 全面的消融实验 ,在那种规模下做实验的成本实在太高了。 因此,我们得用某种系统性的科学方法,研究智能体数量增加到 64、128、256 等规模时会发生什么,了解它们的行为。但要一路扩展到 10,000 个智能体,并确切知道使用 10,000 个而非 1,000 个智能体究竟带来了多少收益,会非常困难。
有一件事我想说清楚。这次解决一道千禧年大奖难题的工作,并不是多智能体的功劳。我甚至不会把 10% 的功劳归给多智能体。 事实是,OpenAI 训练出了一个非常强大的模型。我们能让这个模型持续工作很长时间,也能让它并行思考。
但归根结底,我们之所以能做到这些,是因为我们有一个通用且非常强大的模型。多智能体这类东西既亮眼又新颖,可能正因如此,人们给了它过多的功劳。但核心原因就是,这个模型本身非常强大。
Noam 指的是 GPT-5.6 发布公告。
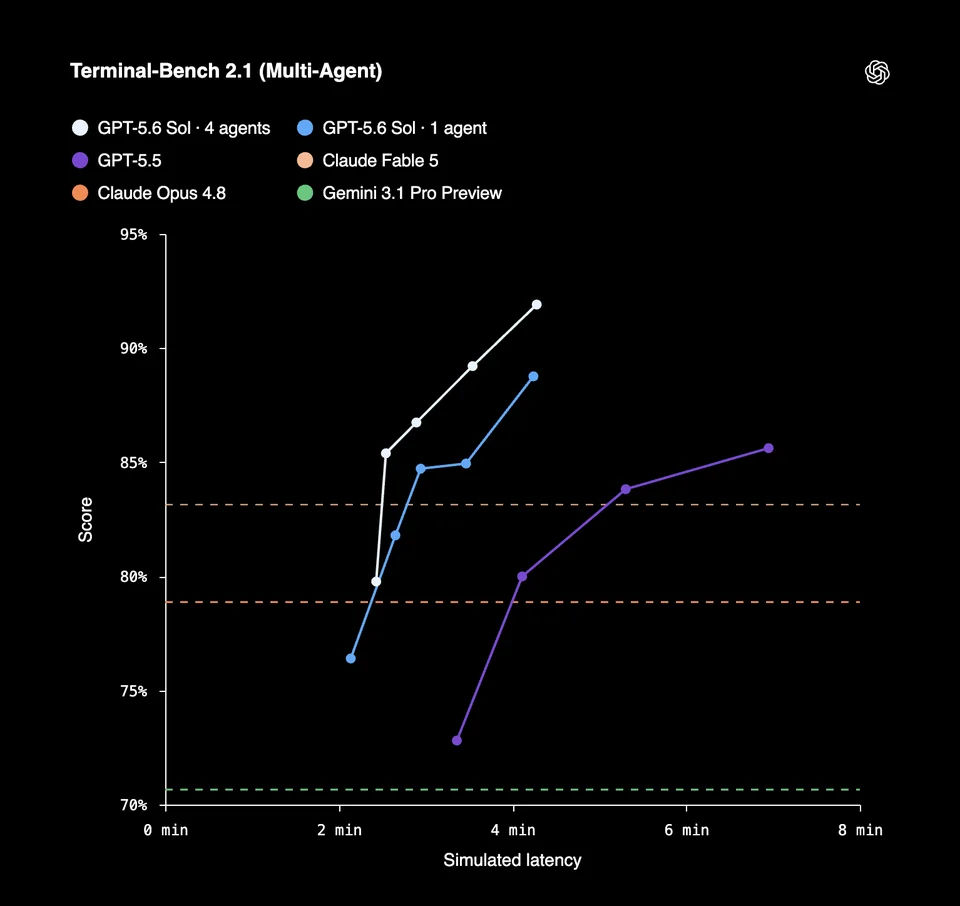
OpenAI GPT-5.6 开发者指南也暗示了多智能体行为是在训练流程的哪个环节引入的(在 RL 后训练期间):
我们通过三项互补的架构调整,对 GPT-5.6 进行了端到端训练,让智能体能更高效地运行:
- 复用已完成的工作: 通过让推理过程能够跨模型轮次保留,并利用原生压缩功能压缩持续时间较长的对话,模型能够在更长的任务周期内保持工作的连贯性,不会陷入混乱,也不必重建先前的上下文。
- 在适合时并行拆分任务: 利用原生多智能体编排,协调多个智能体在并行工作流中开展工作,从而更快地完成复杂任务。
- 将确定性的工作交给代码: 利用程序化工具调用,在模型的上下文窗口之外筛选、汇总和编排工具输出,将模型 token 留给判断工作,从而降低成本和延迟,并减轻上下文退化。
要协调模型权重更新与负责生成 RL rollout 的推理工作进程,所需的基础设施很复杂。Nathan Lambert 曾 撰文介绍过一些系统工程工作,这些工作是实现高效 RL 训练所必需的。
一个经过过度简化的 RL 训练系统,大致是这样的:
- 一组负责更新模型权重的训练工作进程;
- 一组运行这些权重的某个版本、生成 rollout 的推理工作进程;
- 在两者之间传输权重、奖励和其他状态的基础设施。
对于单智能体任务,一次 rollout 就是模型生成一条线性轨迹(工具调用、输出 token)的过程。
但一旦正在训练的策略能够创建并协调其他智能体,一次 rollout 的规模就会扩大。此时,一次 rollout 会变成一棵包含数十或数百条模型轨迹的异步树。
这意味着,能够有效投入到生成单条训练轨迹中的推理算力,可能会大幅增加。而如果你想让模型 学会 良好的协调行为——而不只是给一个已经训练好的模型加上一层编排层——就需要在后训练循环中纳入一些这样的大规模多智能体轨迹。
我猜,内部版本的 Astra 正在使用一套经过改进的训练方案进行训练,以促进原生多智能体编排行为。即便采用了这套经过改进的方案,可能仍有一些小毛病需要解决,这也是为什么 Noam 把 Navier-Stokes 问题相关成果中不到 10% 的功劳归于他们用来得出解答的系统的多智能体特性。
随着训练方案的改进,我们会看到多智能体系统运行得更高效,行为也更连贯。更高效的多智能体集群或许只需少得多的 token 就能得出一个解答,而不必消耗 3000 亿个 token。
正如 Noam 在访谈中也提到的,这个训练过程仍然很脆弱。很难促使模型有效利用跨实例通信;你经常会看到一些“无用”的轨迹,在这些轨迹中,模型完全没有相互通信,也没有向其他实例注入上下文。
不过,从围绕新款 GPT-6 级别模型的乐观预期和传闻来看,OpenAI 团队似乎已经在这个方向上取得了相当大的进展。
最初发表于 LessWrong。