複数のエージェント間で協調できるようにモデルを訓練することで、現在の単一エージェントによるRLの構成よりも、ポストトレーニング中に大幅に多くの計算資源を有効に使えるようになります。
最近のNoam Brownが出演したDwarkesh Podcastから:
Noam Brown
ただ、それは1つのデータ点です。単一のエージェントでナビエ・ストークス問題を解くのにどれほど時間がかかるかは分かりません。まだその実験をしていないからです。いずれやるかもしれませんが、それもまた1つのデータ点にすぎません。
もし 徹底的なアブレーション を行いたいなら、その規模では実験のコストがあまりにも高すぎます。 ですから、エージェント数を64、128、256などに増やしたときに何が起きるのかを、何らかの体系的な科学的検証によって調べ、挙動を把握する必要があります。ただ、そこから10,000まで増やして、1,000のエージェントを使う場合と比べ、10,000を使うことで実際にどれほどの効果が得られたのかを確実に把握するのは、とても難しいでしょう。
はっきりさせておきたいことが1つあります。ミレニアム懸賞問題を解こうとする今回の取り組みができたのは、マルチエージェントのおかげではありません。マルチエージェントの貢献は10%にも満たないと私は考えています。 実際のところ、OpenAIが非常に強力なモデルを訓練したのです。私たちは、そのモデルを非常に長い時間軸にわたって動作させることができます。並列に思考させることもできます。
ただ、根本的には、これができる理由は、汎用的で非常に強力なモデルがあるからです。マルチエージェントのようなものは華やかで目新しいので、おそらくそのために、実際の貢献以上に評価されているのでしょう。しかし、根本的な理由は、これがとにかく非常に強力なモデルだということです。
Noamが言及しているのは、GPT-5.6の発表です。
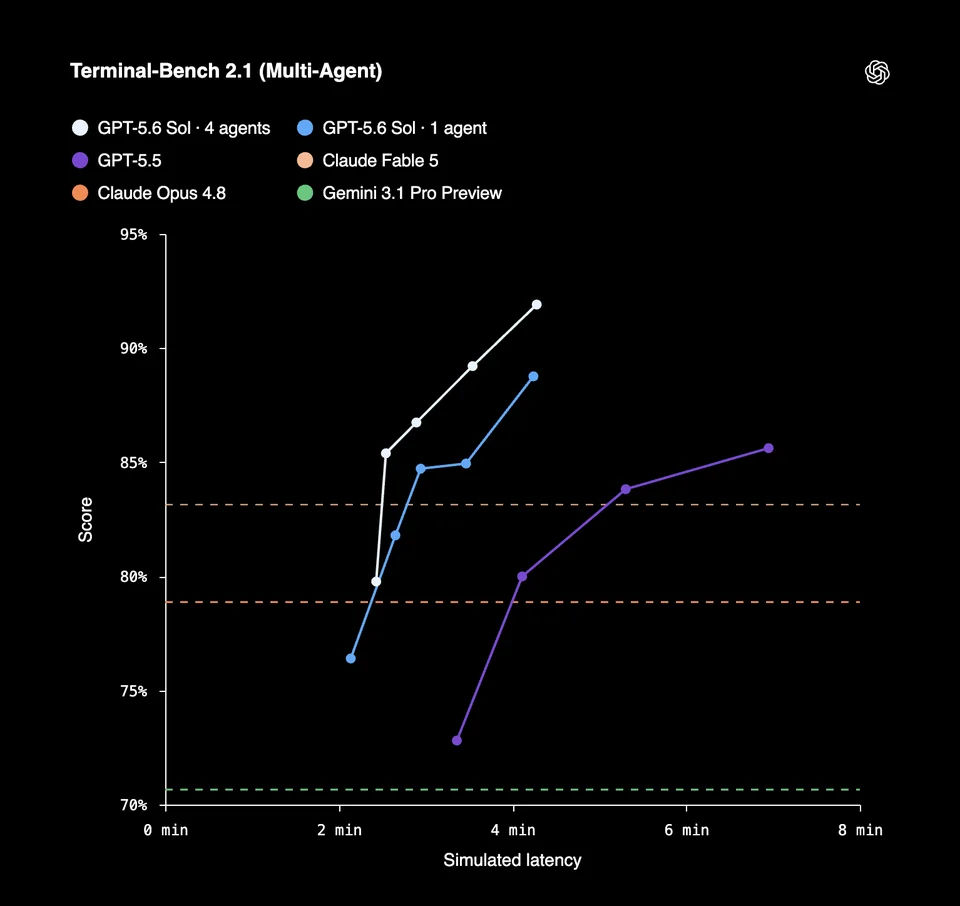
OpenAIのGPT-5.6開発者向けガイドにも、学習の仕組みのどの段階でマルチエージェントの動作が組み込まれるのか(RLによるポストトレーニングの段階)が示唆されています:
私たちは、相互に補完する3つのアーキテクチャ上の工夫を取り入れ、GPT-5.6をエンドツーエンドで訓練しました。これにより、エージェントはより効率的に動作できるようになります:
- すでに行った作業を再利用する: モデルのターンをまたいで推論を保持できるようにし、ネイティブのコンパクションで長期にわたる会話を圧縮することで、モデルは混乱したり、それまでの文脈を再構成したりせずに、より長いタスクにわたって作業の一貫性を維持できます。
- 必要に応じてタスクを分解して並列化する: ネイティブのマルチエージェント・オーケストレーションを使うことで、並行して進める複数の作業にわたってエージェント同士を連携させ、複雑なタスクをより速く完了できます。
- 決定論的な作業をコードに移す: プログラムによるツール呼び出しを使い、モデルのコンテキストウィンドウの外でツールの出力をフィルタリング、集約、統括することで、モデルのトークンを判断に充て、コスト、レイテンシ、コンテキストの劣化を抑えます。
モデルの重みの更新を、RLのロールアウトを生成する推論ワーカーと連動させるためのインフラは複雑です。Nathan Lambertは、RLの学習を効率化するために必要なシステム面での取り組みの一部について書いています。
RLの学習システムをかなり単純化すると、次のようになります:
- モデルの重みを更新する学習ワーカー群;
- その重みのいずれかのバージョンを使ってロールアウトを生成する推論ワーカー群;
- 両者の間で重み、報酬、その他の状態をやり取りするインフラ。
単一エージェントのタスクでは、1回のロールアウトは、モデルが生成する線形の軌跡(ツール呼び出し、出力トークン)です。
しかし、学習対象の方策が他のエージェントを起動し、協調させられるようになると、ロールアウトという単位はより大きくなります。1回のロールアウトは、数十、数百ものモデルの軌跡を含む非同期のツリーになるのです。
つまり、1本の学習軌跡の生成に有効に投入できる推論計算資源の量が、飛躍的に増える可能性があります。そして、学習済みのモデルにオーケストレーション層を後付けするだけでなく、モデルに適切な協調行動を 学習 させたいのであれば、こうした大規模なマルチエージェントの軌跡を、ポストトレーニングのループにいくらか含めたいところです。
私の推測ですが、Astraの社内版は、ネイティブのマルチエージェント・オーケストレーションの動作を促すように改良された学習レシピで訓練されているのではないでしょうか。この改良されたレシピでも、まだ解消すべき癖が残っているのでしょう。Noamが、ナビエ・ストークス問題で得られた成果に対する、解を生成したシステムのマルチエージェントという性質の貢献を10%未満と見ているのも、そのためでしょう。
レシピの改良が進めば、マルチエージェントシステムはより効率的に動作し、より一貫性のある振る舞いを見せるようになるでしょう。解を得るのに3,000億トークンを費やす代わりに、より効率的なマルチエージェント群なら、はるかに少ないトークンで解を得られるかもしれません。
Noamもインタビューで述べているように、この学習プロセスは依然として脆さを抱えています。インスタンス間の通信を効果的に使うようモデルを促すのは難しく、モデルがまったく通信せず、他のインスタンスにコンテキストを渡すこともない「役に立たない」軌跡がよく見られます。
ただ、新しいGPT-6級のモデルへの期待感や噂を踏まえると、OpenAIのチームはすでにこの方向で大きく前進しているように思えます。
初出はLessWrongです。