Wenn wir Modelle darauf trainieren, mehrere Agenten zu koordinieren, können wir während des Post-Trainings deutlich mehr Rechenleistung sinnvoll einsetzen als mit aktuellen RL-Setups mit nur einem Agenten.
Aus dem kürzlich erschienenen Dwarkesh-Podcast mit Noam Brown:
Noam Brown
Aber das ist ein einzelner Datenpunkt. Wir wissen nicht, wie lange ein einzelner Agent brauchen würde, um Navier-Stokes zu lösen, weil wir dieses Experiment noch nicht durchgeführt haben. Vielleicht tun wir das noch, aber auch das wäre nur ein einzelner Datenpunkt.
Wenn wir eine gründliche Ablationsstudie durchführen wollen, sind die Experimente in dieser Größenordnung schlicht zu teuer. Wir müssen also auf eine systematische, wissenschaftliche Weise untersuchen, was passiert, wenn man auf 64, 128, 256 oder so hochgeht, um ein Gefühl für das Verhalten zu bekommen. Aber es wird sehr schwer sein, das bis auf 10.000 zu steigern und mit Sicherheit zu wissen, welchen Nutzen wir tatsächlich dadurch hatten, 10.000 statt 1.000 Agenten einzusetzen.
Eines möchte ich klarstellen. Die Bemühungen um die Lösung eines Millennium-Problems waren nicht dem Multi-Agenten-Ansatz zu verdanken. Ich würde dem Multi-Agenten-Ansatz nicht einmal 10 % des Verdienstes zuschreiben. Tatsache ist, dass OpenAI ein sehr leistungsfähiges Modell trainiert hat. Wir können dieses Modell über sehr lange Zeithorizonte hinweg arbeiten lassen. Wir können es parallel denken lassen.
Im Kern können wir das aber deshalb tun, weil wir einfach ein universell einsetzbares, sehr leistungsfähiges Modell haben. Dinge wie Multi-Agenten-Systeme sind spektakulär und neu, und deshalb wird ihnen wahrscheinlich ein unverhältnismäßig großer Teil des Verdienstes zugeschrieben. Aber der entscheidende Grund ist, dass es sich einfach um ein sehr leistungsfähiges Modell handelt.
Noam bezieht sich auf die Ankündigung von GPT-5.6.
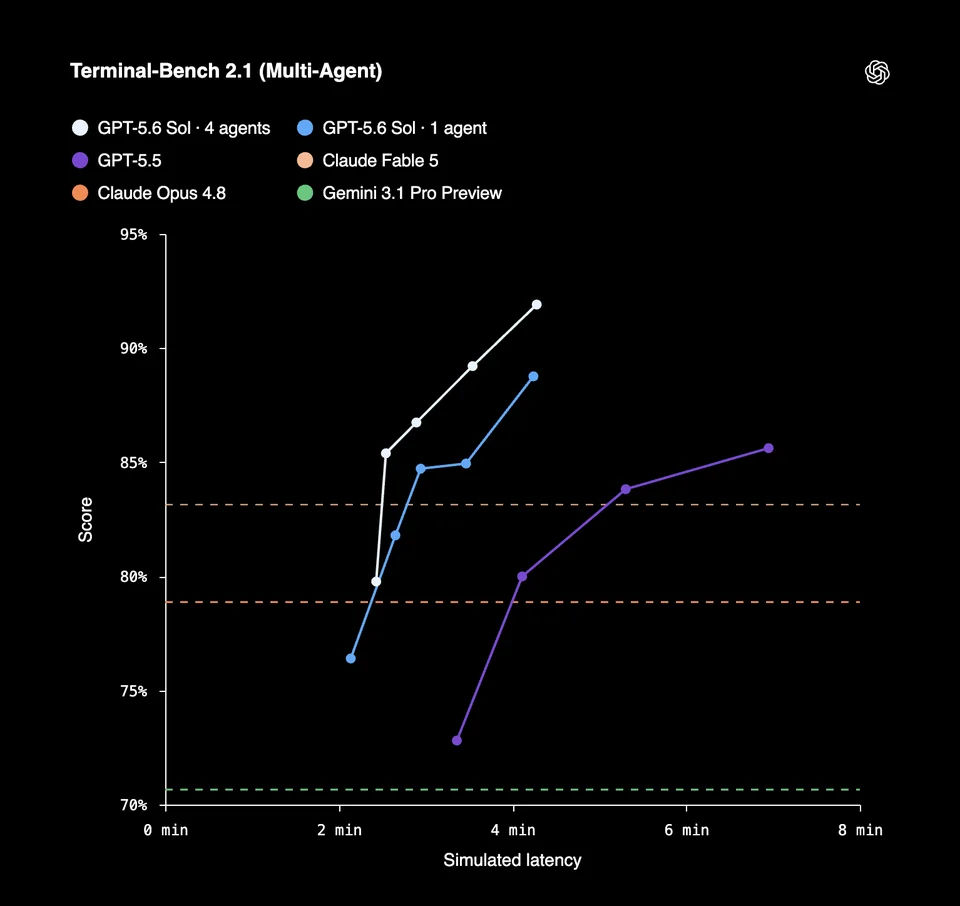
Auch der OpenAI-Leitfaden für Entwickler zu GPT-5.6 deutet an, an welcher Stelle des Trainingsablaufs das Multi-Agenten-Verhalten ins Spiel kommt (während des RL-Post-Trainings):
Wir haben GPT-5.6 end-to-end mit drei sich ergänzenden Eingriffen in die Architektur trainiert, die es Agenten ermöglichen, effizienter zu arbeiten:
- Bereits geleistete Arbeit wiederverwenden: Indem Denkschritte über mehrere Modell-Turns hinweg gespeichert und lange laufende Unterhaltungen durch native Kompaktierung komprimiert werden können, kann das Modell auch über längere Aufgabenzeiträume hinweg kohärent arbeiten, ohne durcheinanderzugeraten oder früheren Kontext rekonstruieren zu müssen.
- Parallele Aufteilung, wo sinnvoll: Die native Multi-Agenten-Orchestrierung ermöglicht es, mehrere Agenten über parallele Arbeitsstränge hinweg zu koordinieren, um komplexe Aufgaben schneller abzuschließen.
- Deterministische Arbeit in Code verlagern: Durch programmatische Tool-Aufrufe lassen sich Tool-Ausgaben außerhalb des Kontextfensters des Modells filtern, aggregieren und orchestrieren. So bleiben die Tokens des Modells für die Urteilsfindung reserviert, und Kosten, Latenz sowie Kontextverfall werden reduziert.
Die Infrastruktur, die nötig ist, um Aktualisierungen der Modellgewichte mit den Inferenz-Workern zu koordinieren, die RL-Rollouts erzeugen, ist komplex. Nathan Lambert hat über einen Teil der Arbeit an der Systeminfrastruktur geschrieben, die nötig ist, um RL-Training effizient zu machen.
Stark vereinfacht sieht ein RL-Trainingssystem etwa so aus:
- eine Gruppe von Learner-Workern, die die Modellgewichte aktualisieren;
- eine Gruppe von Inferenz-Workern, die eine Version dieser Gewichte verwenden, um Rollouts zu erzeugen;
- Infrastruktur, die Gewichte, Belohnungen und andere Zustandsdaten zwischen beiden überträgt.
Bei einer Aufgabe mit nur einem Agenten besteht ein Rollout darin, dass ein Modell eine lineare Trajektorie erzeugt (Tool-Aufrufe, Ausgabe-Tokens).
Sobald die trainierte Policy jedoch andere Agenten starten und koordinieren kann, wird die Einheit eines Rollouts größer. Ein Rollout wird dann zu einem asynchronen Baum, der Dutzende oder Hunderte von Modelltrajektorien enthält.
Das bedeutet, dass die Menge an Inferenzrechenleistung, die sich sinnvoll zur Erzeugung einer einzelnen Trainingstrajektorie einsetzen lässt, drastisch steigen kann. Und wenn das Modell gutes Koordinationsverhalten lernen soll - man einem bereits trainierten Modell also nicht bloß eine Orchestrierungsschicht hinzufügen will -, dann sollten einige dieser großen Multi-Agenten-Trajektorien in die Post-Training-Schleife einfließen.
Ich würde vermuten, dass die interne Version von Astra mit einem verfeinerten Trainingsrezept trainiert wird, um das Modell zur nativen Multi-Agenten-Orchestrierung anzuregen. Selbst mit diesem verfeinerten Rezept müssen wahrscheinlich noch einige Eigenheiten ausgebügelt werden, weshalb Noam weniger als 10 % der Navier-Stokes-Ergebnisse dem Multi-Agenten-Charakter des Systems zuschreibt, mit dem sie die Lösung erarbeitet haben.
Mit der Verbesserung des Rezepts werden wir sehen, dass Multi-Agenten-Systeme effizienter arbeiten und sich kohärenter verhalten. Statt 300 Milliarden Tokens für eine Lösung zu verbrauchen, könnte ein effizienterer Multi-Agenten-Schwarm mit deutlich weniger Tokens eine Lösung erarbeiten.
Wie Noam im Interview ebenfalls anmerkt, ist dieser Trainingsprozess noch fragil. Es ist schwierig, die Modelle dazu anzuregen, die Kommunikation zwischen Instanzen effektiv zu nutzen; oft sieht man "nutzlose" Trajektorien, bei denen die Modelle überhaupt nicht kommunizieren und keinerlei Kontext in andere Instanzen einbringen.
Angesichts des Optimismus und der Gerüchte über das neue Modell auf GPT-6-Niveau scheint das Team bei OpenAI allerdings bereits erhebliche Fortschritte in diese Richtung gemacht zu haben.
Ursprünglich auf LessWrong veröffentlicht.