मॉडलों को कई एजेंटों के बीच समन्वय करना सिखाने से हमें मौजूदा सिंगल-एजेंट RL सेटअप की तुलना में पोस्ट-ट्रेनिंग के दौरान काफ़ी अधिक कंप्यूट का उपयोगी ढंग से इस्तेमाल करने का तरीका मिलता है।
हाल ही में आए नोआम ब्राउन के साथ द्वारकेश पॉडकास्ट से:
नोआम ब्राउन
लेकिन यह सिर्फ़ एक डेटा पॉइंट है। हमें नहीं पता कि एक अकेले एजेंट को Navier-Stokes को हल करने में कितना समय लगेगा, क्योंकि हमने अभी तक वह प्रयोग किया ही नहीं है। शायद हम करें, लेकिन वह भी बस एक डेटा पॉइंट ही होगा।
अगर हम विस्तृत एब्लेशन अध्ययन करना चाहें, तो उस पैमाने पर प्रयोग करना बेहद महँगा पड़ता है। इसलिए हमें किसी व्यवस्थित वैज्ञानिक तरीके से यह जाँचना होगा कि 64, 128, 256 या ऐसी किसी संख्या तक पहुँचने पर क्या होता है, और उससे व्यवहार का कुछ अंदाज़ा लगाना होगा। लेकिन इसे 10,000 तक ले जाना और निश्चित रूप से जानना बहुत कठिन होगा कि 1,000 के मुकाबले 10,000 एजेंटों का इस्तेमाल करने से हमें वास्तव में कितना फ़ायदा हुआ।
मैं एक बात स्पष्ट कर देना चाहता हूँ। एक Millennium Prize Problem को हल करने का यह प्रयास मल्टी-एजेंट की वजह से नहीं हुआ। मैं इसका 10% श्रेय भी मल्टी-एजेंट को नहीं दूँगा। असल बात यह है कि OpenAI ने एक बहुत शक्तिशाली मॉडल ट्रेन किया है। हम उस मॉडल से बहुत लंबी अवधि तक काम करवा सकते हैं। हम उससे समानांतर रूप से सोचने का काम ले सकते हैं।
लेकिन मूल रूप से, हम ऐसा इसलिए कर पा रहे हैं क्योंकि हमारे पास सामान्य उपयोग के लिए बना एक बहुत मज़बूत मॉडल है। मल्टी-एजेंट जैसी चीज़ें ध्यान खींचने वाली और नई हैं, और शायद इसी वजह से उन्हें अपने योगदान के अनुपात से ज़्यादा श्रेय मिलता है। लेकिन मूल वजह यही है कि यह एक बहुत शक्तिशाली मॉडल है।
नोआम का इशारा GPT-5.6 की घोषणा की ओर है।
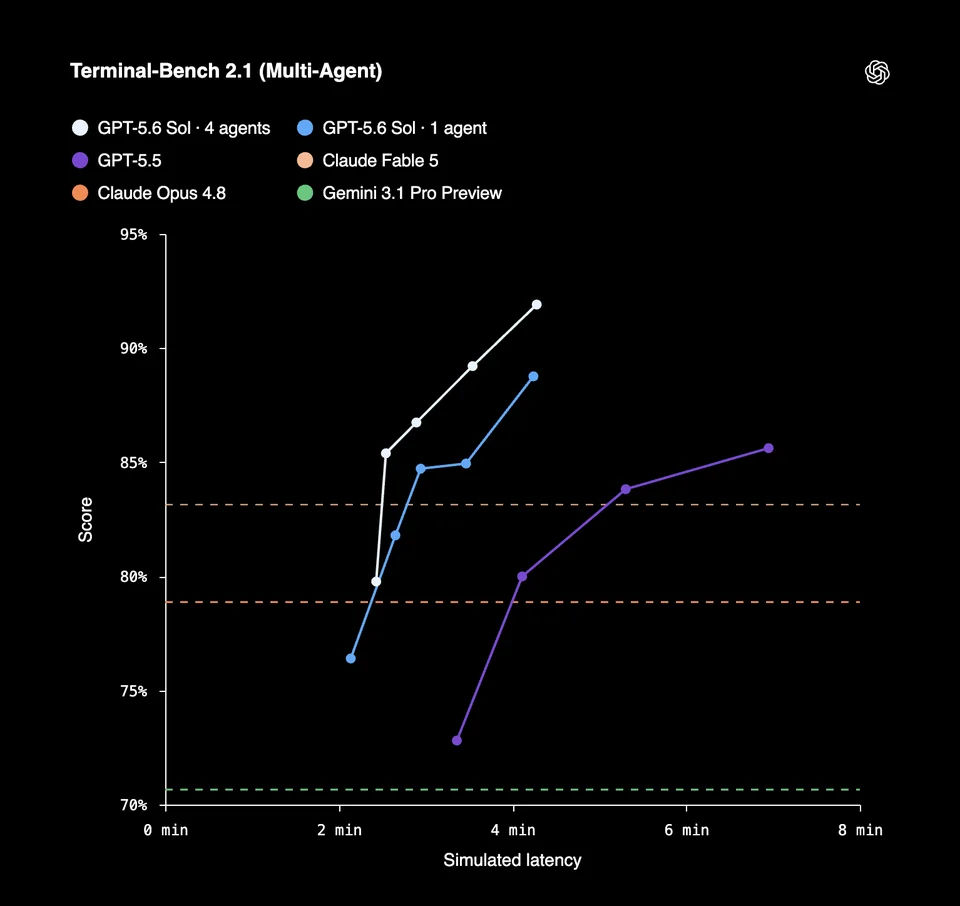
GPT-5.6 के लिए OpenAI की बिल्डर गाइड भी संकेत देती है कि ट्रेनिंग स्टैक में मल्टी-एजेंट व्यवहार कहाँ शामिल होता है (RL पोस्ट-ट्रेनिंग के दौरान):
हमने आर्किटेक्चर में तीन पूरक बदलावों के साथ GPT-5.6 को एंड-टू-एंड ट्रेन किया, जिनसे एजेंट अधिक कुशलता से काम कर पाते हैं:
- पहले से किए गए काम का दोबारा उपयोग करें: मॉडल के अलग-अलग टर्न के बीच रीजनिंग को सहेजे रखने की सुविधा देने और लंबे समय तक चलने वाली बातचीत को संक्षिप्त करने के लिए नेटिव कॉम्पैक्शन का उपयोग करने से मॉडल लंबी अवधि के कार्यों में भी अपने काम में सुसंगति बनाए रख सकता है, बिना भ्रमित हुए और पिछले संदर्भ को फिर से तैयार किए बिना।
- जहाँ उपयुक्त हो, काम को समानांतर हिस्सों में बाँटें: नेटिव मल्टी-एजेंट ऑर्केस्ट्रेशन का उपयोग करने से समानांतर रूप से चल रहे कामों में कई एजेंटों के बीच समन्वय संभव होता है, ताकि जटिल कार्य जल्दी पूरे हो सकें।
- नियतात्मक काम को कोड में ले जाएँ: टूल के आउटपुट को मॉडल की कॉन्टेक्स्ट विंडो के बाहर फ़िल्टर करने, एकत्र करने और उनका ऑर्केस्ट्रेशन करने के लिए प्रोग्रामेटिक टूल कॉलिंग का उपयोग करना, जिससे मॉडल के टोकन निर्णय लेने के लिए बचें और लागत, लेटेंसी तथा कॉन्टेक्स्ट रॉट कम हों।
RL रोलआउट बनाने वाले इन्फ़रेंस वर्करों के साथ मॉडल वेट के अपडेट का समन्वय करने के लिए आवश्यक इंफ़्रास्ट्रक्चर जटिल है। नेथन लैम्बर्ट ने RL ट्रेनिंग को कुशल बनाने के लिए ज़रूरी सिस्टम से जुड़े कुछ कामों के बारे में लिखा है।
RL ट्रेनिंग सिस्टम की बहुत ही सरलीकृत तस्वीर कुछ ऐसी दिखती है:
- मॉडल के वेट अपडेट करने वाले लर्नर वर्करों का एक समूह;
- रोलआउट बनाने के लिए उन वेट के किसी संस्करण का इस्तेमाल करने वाले इन्फ़रेंस वर्करों का एक समूह;
- दोनों के बीच वेट, रिवॉर्ड और अन्य स्टेट पहुँचाने वाला इंफ़्रास्ट्रक्चर।
सिंगल-एजेंट कार्य में, एक रोलआउट में मॉडल एक रैखिक ट्रैजेक्टरी (टूल कॉल, आउटपुट टोकन) बनाता है।
लेकिन जब ट्रेन की जा रही पॉलिसी दूसरे एजेंट शुरू कर सकती है और उनके बीच समन्वय कर सकती है, तो रोलआउट की इकाई बड़ी हो जाती है। तब एक रोलआउट एक असिंक्रोनस ट्री बन जाता है, जिसमें मॉडल की दर्जनों या सैकड़ों ट्रैजेक्टरी होती हैं।
इसका अर्थ है कि एक ट्रेनिंग ट्रैजेक्टरी बनाने में उपयोगी ढंग से लगाया जा सकने वाला इन्फ़रेंस कंप्यूट बहुत अधिक बढ़ सकता है। और अगर आप चाहते हैं कि मॉडल समन्वय का अच्छा व्यवहार सीखे - न कि पहले से ट्रेन किए गए मॉडल पर बस ऑर्केस्ट्रेशन की एक परत जोड़ दी जाए - तो आप पोस्ट-ट्रेनिंग लूप में इनमें से कुछ बड़ी मल्टी-एजेंट ट्रैजेक्टरी भी शामिल करना चाहेंगे।
मेरा अनुमान है कि Astra के आंतरिक संस्करण को एक परिष्कृत विधि से ट्रेन किया जा रहा है, ताकि उसमें नेटिव मल्टी-एजेंट ऑर्केस्ट्रेशन का व्यवहार विकसित हो। इस परिष्कृत विधि के साथ भी, शायद कुछ पेचीदगियाँ अभी सुलझानी बाकी हैं, इसीलिए नोआम Navier-Stokes के नतीजों में 10% से भी कम श्रेय उस सिस्टम की मल्टी-एजेंट प्रकृति को देते हैं, जिसका इस्तेमाल उन्होंने समाधान तैयार करने के लिए किया था।
जैसे-जैसे यह विधि बेहतर होगी, हम मल्टी-एजेंट सिस्टमों को अधिक कुशलता से काम करते और अधिक सुसंगत व्यवहार दिखाते देखेंगे। समाधान तैयार करने में 300B टोकन खर्च करने के बजाय, एक अधिक कुशल मल्टी-एजेंट समूह काफ़ी कम टोकन में समाधान तैयार कर सकता है।
जैसा कि नोआम इंटरव्यू में भी कहते हैं, यह ट्रेनिंग प्रक्रिया अभी भी नाज़ुक है। मॉडलों को अलग-अलग इंस्टेंस के बीच संचार का प्रभावी इस्तेमाल करने के लिए प्रेरित करना कठिन है; अक्सर आपको ऐसी "बेकार" ट्रैजेक्टरी दिखेंगी, जिनमें मॉडल न तो आपस में संवाद करते हैं, न ही दूसरे इंस्टेंस में कोई संदर्भ जोड़ते हैं।
फिर भी, नए GPT-6 स्तर के मॉडल को लेकर आशावाद और अफ़वाहों को देखते हुए लगता है कि OpenAI की टीम इस दिशा में पहले ही काफ़ी प्रगति कर चुकी है।
मूल रूप से LessWrong पर प्रकाशित।