Addestrare i modelli al coordinamento tra più agenti ci permette di impiegare in modo produttivo molte più risorse di calcolo durante il post-training rispetto alle attuali configurazioni di RL a singolo agente.
Dal recente Dwarkesh Podcast con Noam Brown:
Noam Brown
Ma questo è un singolo dato. Non sappiamo quanto tempo impiegherebbe un singolo agente a risolvere Navier-Stokes, perché non abbiamo ancora fatto quell'esperimento. Forse lo faremo, ma anche quello sarebbe soltanto un singolo dato.
Se vogliamo svolgere uno studio di ablazione approfondito , gli esperimenti sono semplicemente troppo costosi su quella scala. Dobbiamo quindi fare una qualche forma di ricerca sistematica su cosa succede quando si passa a 64, 128, 256 o numeri simili, e farci un'idea del comportamento. Ma sarà molto difficile spingerci fino a 10.000 e sapere con certezza quale vantaggio abbiamo effettivamente ottenuto usando 10.000 agenti invece di 1.000.
C'è una cosa che voglio chiarire. Il lavoro per risolvere uno dei problemi del millennio non è stato merito dell'approccio multi-agente. Non attribuirei all'approccio multi-agente nemmeno il 10% del merito. La realtà è che OpenAI ha addestrato un modello molto potente. Riusciamo a far operare quel modello su orizzonti temporali molto lunghi. Riusciamo a farlo pensare in parallelo.
Ma, in fondo, il motivo per cui riusciamo a farlo è che abbiamo semplicemente un modello generalista molto potente. Soluzioni come il multi-agente sono nuove e fanno colpo, e probabilmente è per questo che ricevono una quota sproporzionata del merito. Ma il motivo di fondo è che si tratta semplicemente di un modello molto potente.
Noam si riferisce all'annuncio di GPT-5.6.
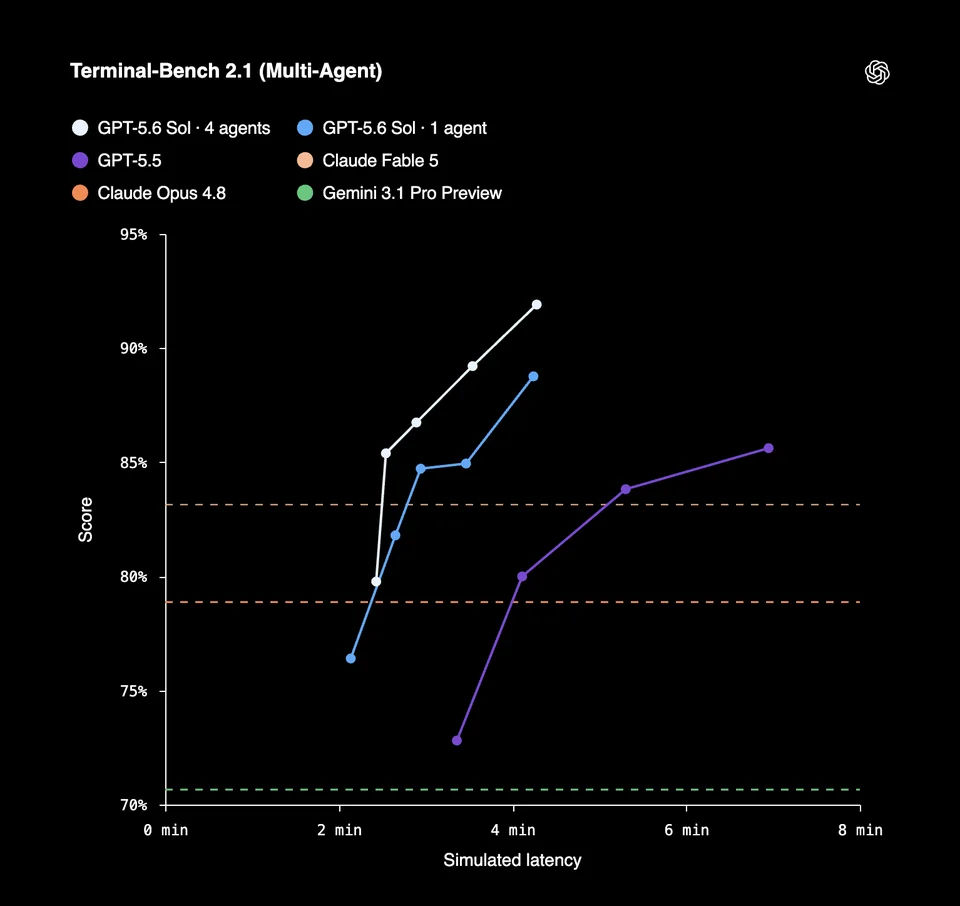
La guida di OpenAI a GPT-5.6 per sviluppatori accenna anche al punto in cui il comportamento multi-agente entra nello stack di addestramento (durante il post-training con RL):
Abbiamo addestrato GPT-5.6 end-to-end con tre interventi architetturali complementari che consentono agli agenti di operare in modo più efficiente:
- Riutilizzare il lavoro già svolto: consentendo di conservare il ragionamento tra un turno e l'altro del modello e usando la compattazione nativa per comprimere le conversazioni di lunga durata, il modello può mantenere la coerenza del proprio lavoro anche in compiti di durata maggiore senza confondersi o dover ricostruire il contesto precedente.
- Scomporre in attività parallele dove opportuno: l'orchestrazione multi-agente nativa consente di coordinare più agenti su flussi di lavoro paralleli per completare più velocemente compiti complessi.
- Spostare il lavoro deterministico nel codice: usando chiamate programmatiche agli strumenti per filtrare, aggregare e orchestrare i loro output al di fuori della finestra di contesto del modello, riservando i token del modello alle valutazioni e riducendo i costi, la latenza e il deterioramento del contesto.
L'infrastruttura necessaria per coordinare gli aggiornamenti dei pesi del modello con i worker di inferenza che generano i rollout di RL è complessa. Nathan Lambert ha scritto di parte del lavoro sui sistemi necessario per rendere efficiente l'addestramento con RL.
Una rappresentazione fin troppo semplificata di un sistema di addestramento con RL è più o meno questa:
- un insieme di worker di addestramento che aggiornano i pesi del modello;
- un insieme di worker di inferenza che usano una qualche versione di quei pesi per generare rollout;
- un'infrastruttura che trasferisce pesi, ricompense e altre informazioni di stato tra i due insiemi.
Per un compito a singolo agente, un rollout consiste in un modello che produce una traiettoria lineare (chiamate agli strumenti, token di output).
Ma quando la policy in fase di addestramento può avviare e coordinare altri agenti, il rollout diventa un'unità più grande. Un singolo rollout diventa allora un albero asincrono che contiene decine o centinaia di traiettorie del modello.
Questo significa che la quantità di risorse di calcolo per l'inferenza che si può impiegare utilmente per produrre una singola traiettoria di addestramento può aumentare enormemente. E se vogliamo che il modello impari a coordinarsi bene - anziché limitarci ad aggiungere un livello di orchestrazione a un modello già addestrato - ci conviene includere alcune di queste grandi traiettorie multi-agente nel ciclo di post-training.
La mia ipotesi è che la versione interna di Astra venga addestrata con una ricetta affinata per favorire comportamenti di orchestrazione multi-agente nativa. Anche con questa ricetta affinata, è probabile che ci siano ancora alcune stranezze da sistemare, ed è per questo che Noam attribuisce meno del 10% dei risultati su Navier-Stokes alla natura multi-agente del sistema usato per produrre la soluzione.
Man mano che la ricetta migliorerà, vedremo i sistemi multi-agente operare con maggiore efficienza e comportarsi in modo più coerente. Anziché consumare 300 miliardi di token per produrre una soluzione, uno sciame multi-agente più efficiente potrebbe produrre una soluzione con un numero significativamente inferiore di token.
Come osserva anche Noam nell'intervista, questo processo di addestramento è ancora fragile. È difficile incoraggiare i modelli a usare in modo efficace la comunicazione tra istanze; spesso si vedono traiettorie "inutili" in cui i modelli non comunicano e non inseriscono alcun contesto nelle altre istanze.
Visti però l'ottimismo e le voci sul nuovo modello di livello GPT-6, sembra che il team di OpenAI abbia già fatto progressi sostanziali in questa direzione.
Pubblicato originariamente su LessWrong.