訓練模型在多個代理之間協同運作,讓我們能在後訓練期間有效運用比目前單代理 RL 設定多得多的運算資源。
以下引自近期 Dwarkesh Podcast 對 Noam Brown 的訪談:
Noam Brown
但那只是一個資料點。我們不知道單一代理要花多久才能解決 Navier-Stokes,因為我們還沒做過那個實驗。也許我們會做,但那也仍然只是一個資料點。
如果我們想做一次 徹底的消融實驗 ,在那種規模下,實驗的成本實在太高了。 所以,我們必須透過某種有系統的科學研究,觀察代理數量增加到 64、128、256 或類似規模時會發生什麼事,了解它的行為。但要一路推進到 10,000 個代理,並確切知道使用 10,000 個代理比使用 1,000 個究竟帶來多少效益,會非常困難。
有一點我想說清楚。這次嘗試解決一項千禧年大獎難題,並不是多代理的功勞。我甚至不會把 10% 的功勞歸給多代理。 事實是,OpenAI 訓練出了一個非常強大的模型。我們能讓這個模型在很長的任務時程中持續運作。我們能讓它平行思考。
但從根本上來說,我們之所以能做到這一點,是因為我們有一個通用而且非常強大的模型。多代理這類技術既新穎又吸睛,可能因此被高估了貢獻。但核心原因,就是這個模型本身非常強大。
Noam 指的是 GPT-5.6 發布公告。
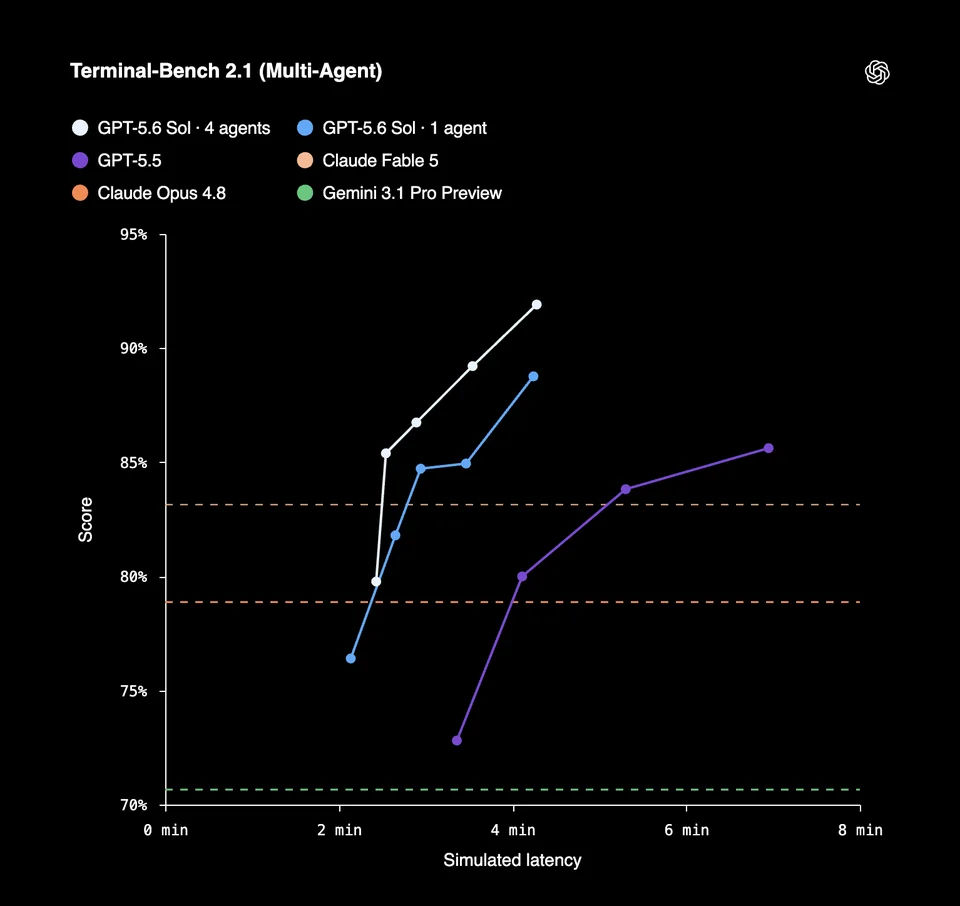
OpenAI 的 GPT-5.6 開發者指南也暗示了多代理行為是在訓練流程的哪個階段引入的(也就是 RL 後訓練期間):
我們以三項互補的架構調整,對 GPT-5.6 進行端到端訓練,讓代理能更有效率地運作:
- 重用已完成的工作: 透過在模型的不同回合之間保留推理內容,並使用原生壓縮功能來壓縮長時間持續的對話,模型可以在更長的任務時程中維持工作的連貫性,不會陷入混亂,也不必重建先前的上下文。
- 在適當時平行拆解任務: 使用原生多代理編排功能,協調多個代理平行推進各項工作,更快完成複雜任務。
- 將確定性的工作移至程式碼: 透過程式化工具呼叫,在模型的上下文視窗之外篩選、彙整及編排工具輸出,將模型的 token 留給需要判斷的工作,並降低成本、延遲及上下文劣化。
要協調模型權重更新與產生 RL rollout 的推論工作程序,需要複雜的基礎設施。Nathan Lambert 曾撰文談過一些系統工程工作,這些工作是提升 RL 訓練效率所必需的。
如果把 RL 訓練系統過度簡化,大致會是這樣:
- 一組負責更新模型權重的學習工作程序;
- 一組使用某個版本的模型權重來產生 rollout 的推論工作程序;
- 在兩者之間傳遞權重、獎勵與其他狀態的基礎設施。
對單代理任務而言,一次 rollout 就是模型產生一條線性軌跡(工具呼叫、輸出 token)。
但當訓練中的策略能夠建立並協調其他代理時,一次 rollout 所涵蓋的範圍就會變大。此時,一次 rollout 會變成一棵非同步樹,包含數十或數百條模型軌跡。
這表示,在產生單條訓練軌跡時,能有效投入的推論運算資源可能會大幅增加。而且,如果你希望模型 學會 良好的協調行為 - 而不只是在已訓練好的模型上加上一層編排機制 - 就會想在後訓練迴圈中納入一些這類大型多代理軌跡。
我猜,內部版本的 Astra 正採用經過改良的配方來訓練,以促進原生的多代理編排行為。即使配方已經改良,可能仍有一些異常行為需要處理。這也是為什麼,對於 Navier-Stokes 的成果,Noam 將不到 10% 的功勞歸於他們用來產生解答的系統所具備的多代理特性。
隨著訓練配方持續改良,我們會看到多代理系統運作得更有效率,行為也更連貫。比起耗費 3,000 億個 token 產生一個解答,效率更高的多代理群體或許能用少得多的 token 產生解答。
正如 Noam 在訪談中也提到的,這個訓練過程仍然很脆弱。要促使模型有效運用跨實例通訊並不容易;你經常會看到「無用」的軌跡,當中的模型完全沒有互相溝通,也沒有將上下文注入其他實例。
不過,從對新的 GPT-6 等級模型的樂觀期待與相關傳聞來看,OpenAI 團隊似乎已在這個方向上取得相當大的進展。
原文刊登於 LessWrong。