Trenowanie modeli tak, by koordynowały pracę wielu agentów, daje nam sposób na efektywne wykorzystanie na etapie post-trainingu znacznie większej mocy obliczeniowej, niż umożliwiają obecne konfiguracje RL z jednym agentem.
Z niedawnego odcinka Dwarkesh Podcast z Noamem Brownem:
Noam Brown
Ale to tylko jeden punkt danych. Nie wiemy, ile czasu zajęłoby pojedynczemu agentowi rozwiązanie problemu Naviera–Stokesa, bo jeszcze nie przeprowadziliśmy takiego eksperymentu. Może go przeprowadzimy, ale to też będzie tylko jeden punkt danych.
Jeśli chcemy przeprowadzić dokładne badanie ablacyjne , eksperymenty na taką skalę są po prostu zbyt kosztowne. Musimy więc metodycznie badać, co się dzieje, gdy przechodzimy do 64, 128, 256 czy podobnej liczby agentów, i wyrobić sobie pojęcie o ich zachowaniu. Bardzo trudno będzie jednak dojść z tym aż do 10 000 i wiedzieć na pewno, jaką korzyść faktycznie uzyskaliśmy dzięki użyciu 10 000 agentów w porównaniu z 1000.
Chcę wyjaśnić jedną rzecz. Prace nad rozwiązaniem jednego z problemów milenijnych nie były zasługą podejścia wieloagentowego. Nie przypisałbym mu nawet 10% zasług. W rzeczywistości OpenAI wytrenowało bardzo potężny model. Potrafimy sprawić, by ten model działał w bardzo długim horyzoncie. Potrafimy sprawić, by myślał równolegle.
Ale zasadniczo jesteśmy w stanie to robić dlatego, że po prostu mamy bardzo mocny model ogólnego przeznaczenia. Rzeczy takie jak podejście wieloagentowe są efektowne i nowe, i prawdopodobnie z tego powodu przypisuje się im nieproporcjonalnie dużą część zasług. Zasadniczy powód jest jednak taki, że to po prostu bardzo potężny model.
Noam odnosi się do ogłoszenia dotyczącego GPT-5.6.
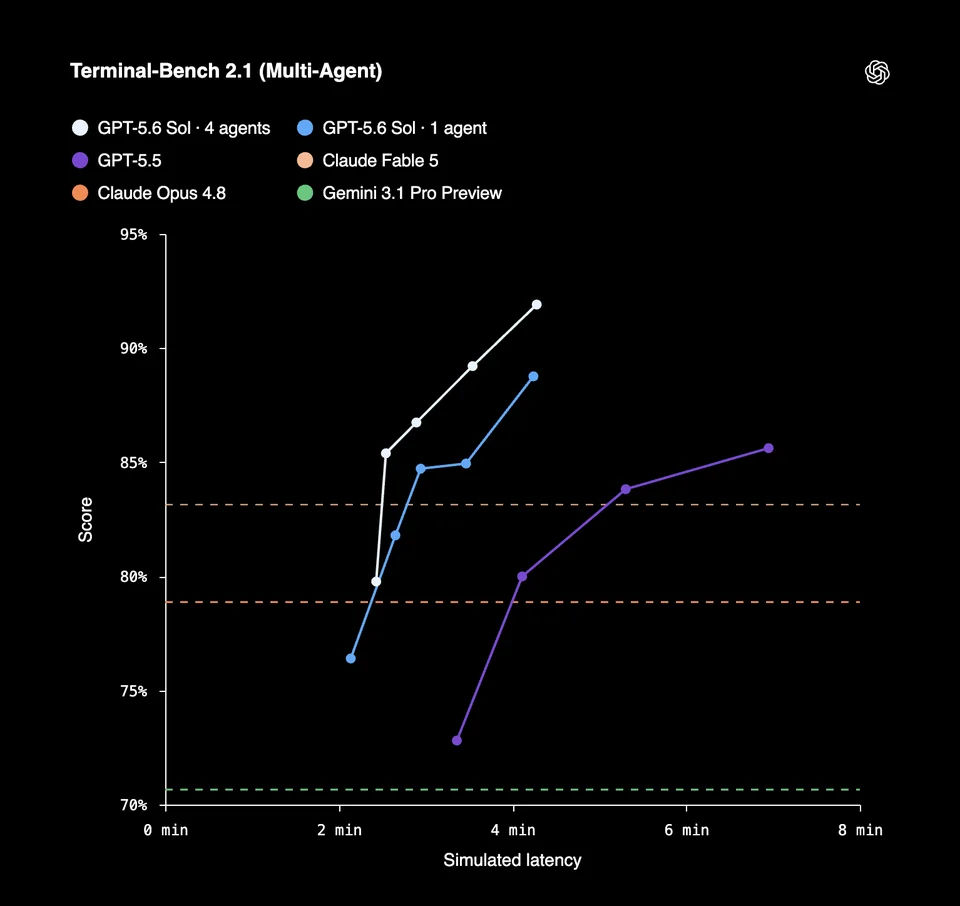
Przewodnik OpenAI po GPT-5.6 dla twórców również sugeruje, na którym etapie procesu trenowania pojawiają się zachowania wieloagentowe (podczas post-trainingu z użyciem RL):
Wytrenowaliśmy GPT-5.6 w trybie end-to-end, stosując trzy uzupełniające się zmiany w architekturze, które pozwalają agentom działać wydajniej:
- Wykorzystuj ponownie już wykonaną pracę: dzięki możliwości zachowywania rozumowania między turami modelu oraz wykorzystaniu natywnej kompakcji do kompresji długich rozmów model może zachować spójność pracy w dłuższym horyzoncie realizacji zadań, nie gubiąc się ani nie musząc odtwarzać wcześniejszego kontekstu.
- Dziel pracę na równoległe zadania tam, gdzie ma to sens: wykorzystanie natywnej orkiestracji wielu agentów pozwala koordynować ich działania w równoległych strumieniach pracy, by szybciej kończyć złożone zadania.
- Przenoś deterministyczne operacje do kodu: wywoływanie narzędzi z poziomu kodu pozwala filtrować, agregować i organizować wyniki ich działania poza oknem kontekstowym modelu, rezerwując tokeny modelu na podejmowanie decyzji oraz ograniczając koszty, opóźnienia i degradację kontekstu.
Infrastruktura potrzebna do koordynowania aktualizacji wag modelu z pracą procesów roboczych wykonujących wnioskowanie i generujących rollouty na potrzeby RL jest złożona. Nathan Lambert pisał o części prac nad systemami niezbędnych do zapewnienia wydajnego trenowania metodą RL.
Mocno uproszczony obraz systemu treningowego RL wygląda mniej więcej tak:
- grupa procesów roboczych uczących model i aktualizujących jego wagi;
- grupa procesów roboczych wykonujących wnioskowanie z użyciem pewnej wersji tych wag, by generować rollouty;
- infrastruktura przesyłająca między nimi wagi, nagrody i pozostałe elementy stanu.
W zadaniu wykonywanym przez jednego agenta jeden rollout polega na tym, że model generuje liniową trajektorię (wywołania narzędzi, tokeny wyjściowe).
Gdy jednak trenowana polityka potrafi uruchamiać innych agentów i koordynować ich działania, zwiększa się zakres pojedynczego rolloutu. Jeden rollout przyjmuje wówczas postać asynchronicznego drzewa zawierającego dziesiątki lub setki trajektorii modeli.
Oznacza to, że ilość mocy obliczeniowej przeznaczanej na wnioskowanie, którą można z pożytkiem wykorzystać do wygenerowania pojedynczej trajektorii treningowej, może radykalnie wzrosnąć. A jeśli zależy ci na tym, by model nauczył się skutecznej koordynacji - a nie tylko na dodaniu warstwy orkiestracji do już wytrenowanego modelu - zależy ci też na uwzględnieniu części tych dużych trajektorii wieloagentowych w pętli post-trainingu.
Przypuszczam, że wewnętrzna wersja Astry jest trenowana według dopracowanej receptury, która ma sprzyjać natywnej orkiestracji wielu agentów. Nawet przy tej dopracowanej recepturze zapewne nadal pozostają pewne niedoskonałości do usunięcia, dlatego Noam przypisuje <10% wyników dotyczących problemu Naviera–Stokesa wieloagentowemu charakterowi systemu, którego użyli do uzyskania rozwiązania.
W miarę udoskonalania tej receptury zobaczymy, jak systemy wieloagentowe działają wydajniej i zachowują się bardziej spójnie. Zamiast zużywać 300 mld tokenów na uzyskanie rozwiązania, wydajniejszy rój agentów może uzyskać rozwiązanie przy znacznie mniejszej liczbie tokenów.
Jak Noam również zauważa w wywiadzie, ten proces trenowania wciąż jest kruchy. Trudno skłonić modele do skutecznego korzystania z komunikacji między instancjami; często można zobaczyć „bezużyteczne” trajektorie, w których modele w ogóle nie komunikują się z innymi instancjami ani nie przekazują im kontekstu.
Biorąc jednak pod uwagę optymizm i pogłoski o nowym modelu na poziomie GPT-6, wygląda na to, że zespół OpenAI poczynił już znaczne postępy w tym kierunku.
Pierwotnie opublikowano na LessWrong.