การฝึกโมเดลให้เอเจนต์หลายตัวประสานงานกันเปิดทางให้เราใช้ทรัพยากรประมวลผลระหว่าง post-training ให้เกิดประโยชน์ได้มากกว่าระบบ RL แบบเอเจนต์เดียวในปัจจุบันอย่างมาก
จาก Dwarkesh Podcast ตอนที่คุยกับ Noam Brown เมื่อไม่นานมานี้:
Noam Brown
แต่นั่นก็เป็นข้อมูลเพียงจุดเดียว เราไม่รู้ว่าเอเจนต์ตัวเดียวจะใช้เวลานานแค่ไหนในการแก้ปัญหา Navier-Stokes เพราะเรายังไม่ได้ทำการทดลองนั้น เราอาจจะทำก็ได้ แต่นั่นก็ยังเป็นข้อมูลเพียงจุดเดียวเช่นกัน
ถ้าเราต้องการทำ การทดลอง ablation อย่างละเอียด การทดลองที่สเกลนั้นก็มีค่าใช้จ่ายสูงเกินไป ดังนั้นเราต้องศึกษากันอย่างเป็นระบบว่าเกิดอะไรขึ้นเมื่อเพิ่มไปเป็น 64, 128, 256 หรือจำนวนประมาณนั้น เพื่อให้พอเห็นพฤติกรรม แต่การขยายไปจนถึง 10,000 แล้วรู้แน่ชัดว่าการใช้เอเจนต์ 10,000 ตัวให้ประโยชน์อะไรจริง ๆ เมื่อเทียบกับ 1,000 ตัว จะเป็นเรื่องยากมาก
มีเรื่องหนึ่งที่ผมอยากพูดให้ชัดเจน ความพยายามแก้โจทย์ Millennium Prize Problem ครั้งนี้ไม่ได้เป็นผลมาจากการใช้หลายเอเจนต์ ผมให้เครดิตกับการใช้หลายเอเจนต์ไม่ถึง 10% ด้วยซ้ำ ความจริงก็คือ OpenAI ได้ฝึกโมเดลที่ทรงพลังมากขึ้นมา เราทำให้โมเดลนั้นทำงานต่อเนื่องได้ยาวนานมาก เราทำให้มันคิดแบบขนานได้
แต่โดยพื้นฐานแล้ว เหตุผลที่เราทำสิ่งนี้ได้ก็เพราะเรามีโมเดลอเนกประสงค์ที่เก่งมาก สิ่งอย่างระบบหลายเอเจนต์นั้นหวือหวาและใหม่ จึงน่าจะได้รับเครดิตเกินสัดส่วนจริงด้วยเหตุนี้ แต่เหตุผลหลักก็คือ โมเดลนี้ทรงพลังมากเท่านั้นเอง
Noam กำลังพูดถึง ประกาศเปิดตัว GPT-5.6
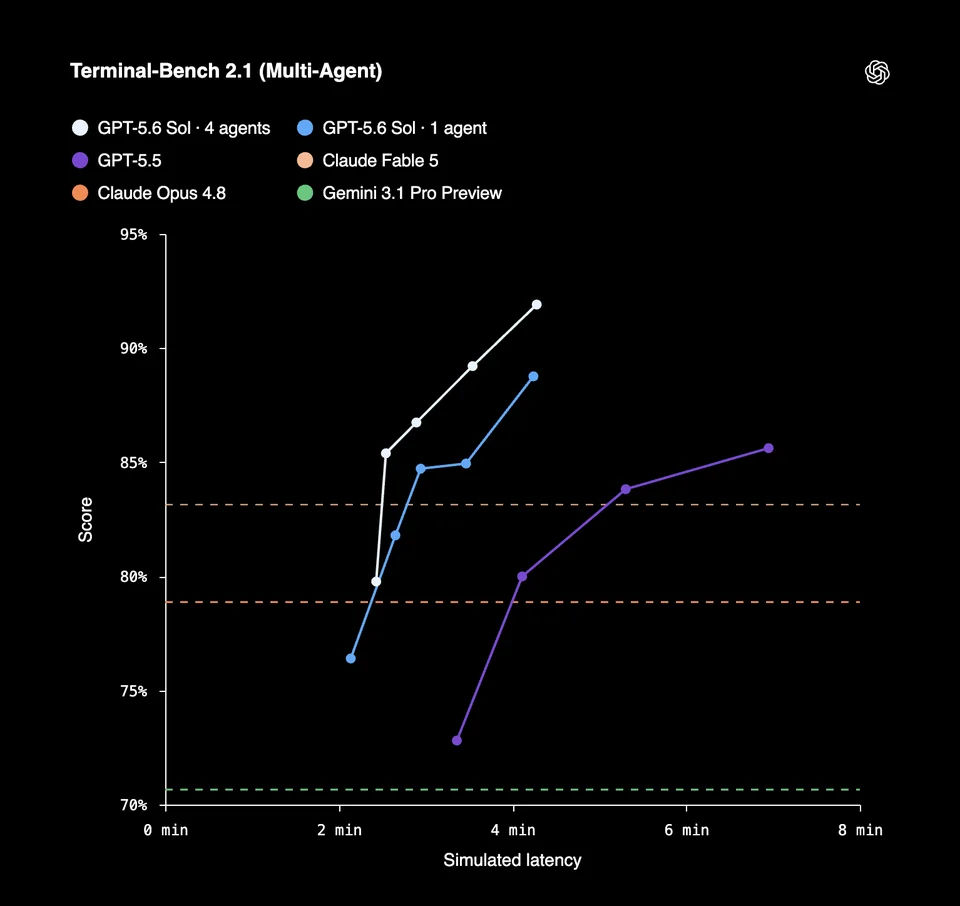
คู่มือ GPT-5.6 สำหรับนักพัฒนาของ OpenAI ยังบอกเป็นนัยด้วยว่า พฤติกรรมแบบหลายเอเจนต์เข้ามามีบทบาทตรงไหนในระบบการฝึก (ระหว่าง post-training ด้วย RL):
เราได้ฝึก GPT-5.6 แบบ end-to-end ด้วยการปรับเปลี่ยนเชิงสถาปัตยกรรมสามอย่างที่เสริมกัน ซึ่งช่วยให้เอเจนต์ทำงานได้อย่างมีประสิทธิภาพมากขึ้น:
- นำงานที่ทำแล้วกลับมาใช้: การเก็บกระบวนการให้เหตุผลไว้ข้ามเทิร์นของโมเดล และใช้การย่อบริบทที่รองรับในตัวเพื่อบีบอัดบทสนทนาที่ยาวนาน ช่วยให้โมเดลทำงานได้อย่างสอดคล้องต่อเนื่องตลอดกระบวนการทำงานที่ยาวขึ้น โดยไม่สับสนหรือต้องสร้างบริบทเดิมขึ้นมาใหม่
- แบ่งงานเพื่อทำแบบขนานตามความเหมาะสม: การจัดการเอเจนต์หลายตัวที่รองรับในตัวช่วยให้ประสานงานเอเจนต์หลายตัวในสายงานที่ดำเนินไปพร้อมกัน เพื่อให้งานที่ซับซ้อนเสร็จเร็วขึ้น
- ย้ายงานที่มีผลลัพธ์ตายตัวไปไว้ในโค้ด: ใช้การเรียกเครื่องมือผ่านโปรแกรมเพื่อกรอง รวม และจัดการผลลัพธ์จากเครื่องมือนอกหน้าต่างบริบทของโมเดล เก็บโทเคนของโมเดลไว้ใช้กับการใช้วิจารณญาณ และลดต้นทุน เวลาแฝง และการเสื่อมคุณภาพของบริบท
โครงสร้างพื้นฐานที่ต้องใช้เพื่อประสานการอัปเดตค่าน้ำหนักโมเดลกับเวิร์กเกอร์อนุมานที่สร้าง rollout สำหรับ RL มีความซับซ้อน Nathan Lambert ได้ เขียนถึงงานด้านระบบบางส่วน ที่จำเป็นต่อการทำให้การฝึกด้วย RL มีประสิทธิภาพ
ถ้าลดทอนรายละเอียดของระบบฝึกด้วย RL ลงอย่างมาก ภาพที่ได้ก็จะประมาณนี้:
- เวิร์กเกอร์ฝึกโมเดลชุดหนึ่งที่อัปเดตค่าน้ำหนักของโมเดล;
- เวิร์กเกอร์อนุมานชุดหนึ่งที่ใช้ค่าน้ำหนักเหล่านั้นเวอร์ชันใดเวอร์ชันหนึ่งเพื่อสร้าง rollout;
- โครงสร้างพื้นฐานที่ส่งผ่านค่าน้ำหนัก รางวัล และสถานะอื่น ๆ ระหว่างทั้งสองกลุ่ม
สำหรับงานแบบเอเจนต์เดียว rollout หนึ่งครั้งคือการที่โมเดลสร้างลำดับการทำงานแบบเส้นตรง (การเรียกใช้เครื่องมือ โทเคนเอาต์พุต)
แต่เมื่อนโยบายที่กำลังฝึกสามารถสร้างเอเจนต์อื่นขึ้นมาและประสานงานกับเอเจนต์เหล่านั้นได้ หน่วยที่นับเป็น rollout ก็ขยายใหญ่ขึ้น โดย rollout หนึ่งครั้งจะกลายเป็นโครงสร้างต้นไม้แบบอะซิงโครนัสที่ประกอบด้วยลำดับการทำงานของโมเดลหลายสิบหรือหลายร้อยลำดับ
นั่นหมายความว่า ปริมาณทรัพยากรประมวลผลสำหรับการอนุมานที่ใช้ให้เกิดประโยชน์ในการสร้างลำดับการทำงานสำหรับฝึกหนึ่งลำดับอาจเพิ่มขึ้นได้อย่างมาก และถ้าคุณต้องการให้โมเดล เรียนรู้ พฤติกรรมการประสานงานที่ดี - ไม่ใช่เพียงนำชั้นการจัดการมาแปะเข้ากับโมเดลที่ฝึกเสร็จแล้ว - คุณก็ควรรวมลำดับการทำงานแบบหลายเอเจนต์ขนาดใหญ่เหล่านี้บางส่วนไว้ในวงรอบ post-training ด้วย
ฉันคาดว่า Astra เวอร์ชันภายในกำลังได้รับการฝึกด้วยสูตรการฝึกที่ปรับปรุงให้ดีขึ้น เพื่อส่งเสริมพฤติกรรมการจัดการเอเจนต์หลายตัวโดยตัวโมเดลเอง แม้จะใช้สูตรที่ปรับปรุงแล้วนี้ ก็ยังน่าจะมีพฤติกรรมแปลก ๆ ที่ต้องแก้ไข ซึ่งเป็นเหตุผลที่ Noam ยกเครดิตของผลลัพธ์เรื่อง Navier-Stokes ไม่ถึง 10% ให้กับการทำงานแบบหลายเอเจนต์ของระบบที่พวกเขาใช้หาคำตอบ
เมื่อสูตรการฝึกได้รับการปรับปรุง เราจะเห็นระบบหลายเอเจนต์ทำงานอย่างมีประสิทธิภาพยิ่งขึ้น และมีพฤติกรรมที่สอดคล้องกันมากขึ้น แทนที่จะใช้โทเคน 300 พันล้านโทเคนเพื่อหาคำตอบ ฝูงเอเจนต์ที่มีประสิทธิภาพยิ่งขึ้นอาจหาคำตอบได้โดยใช้โทเคนน้อยลงอย่างมาก
อย่างที่ Noam กล่าวไว้ในบทสัมภาษณ์เช่นกัน กระบวนการฝึกนี้ยังเปราะบาง การส่งเสริมให้โมเดลใช้การสื่อสารระหว่างอินสแตนซ์อย่างมีประสิทธิภาพเป็นเรื่องยาก บ่อยครั้งคุณจะเห็นลำดับการทำงานที่ "ไร้ประโยชน์" ซึ่งโมเดลไม่ได้สื่อสารหรือส่งบริบทเข้าไปในอินสแตนซ์อื่นเลย
แต่เมื่อดูจากมุมมองเชิงบวกและข่าวลือเกี่ยวกับโมเดลใหม่ระดับ GPT-6 แล้ว ก็ดูเหมือนว่าทีม OpenAI จะมีความคืบหน้าในทิศทางนี้ไปมากแล้ว
เผยแพร่ครั้งแรกบน LessWrong