Entrenar modelos para coordinar varios agentes nos permite aprovechar muchos más recursos de cómputo durante el postentrenamiento que con las configuraciones actuales de RL con un solo agente.
Del reciente episodio de Dwarkesh Podcast con Noam Brown:
Noam Brown
Pero eso es solo un dato. No sabemos cuánto tardaría un solo agente en resolver Navier-Stokes, porque todavía no hemos hecho ese experimento. Quizá lo hagamos, pero eso también sería solo un dato.
Si queremos hacer un estudio de ablación exhaustivo , los experimentos son sencillamente demasiado caros a esa escala. Así que tenemos que investigar de forma metódica qué ocurre cuando pasamos a 64, 128, 256 o algo así, y hacernos una idea del comportamiento. Pero va a ser muy difícil llevar eso hasta 10.000 y saber con certeza qué beneficio obtuvimos realmente al usar 10.000 agentes en lugar de 1.000.
Hay algo que quiero dejar claro. El trabajo para resolver uno de los Problemas del Milenio no se debió al uso de múltiples agentes. Ni siquiera atribuiría el 10 % del mérito al uso de múltiples agentes. La realidad es que OpenAI ha entrenado un modelo muy potente. Podemos hacer que ese modelo opere en horizontes muy largos. Podemos hacer que piense en paralelo.
Pero, en esencia, podemos hacer esto porque tenemos un modelo de propósito general muy potente. Cosas como los sistemas multiagente son llamativas y nuevas, y probablemente por eso reciben un mérito desproporcionado. Pero la razón fundamental es que este modelo es muy potente.
Noam se refiere al anuncio de GPT-5.6.
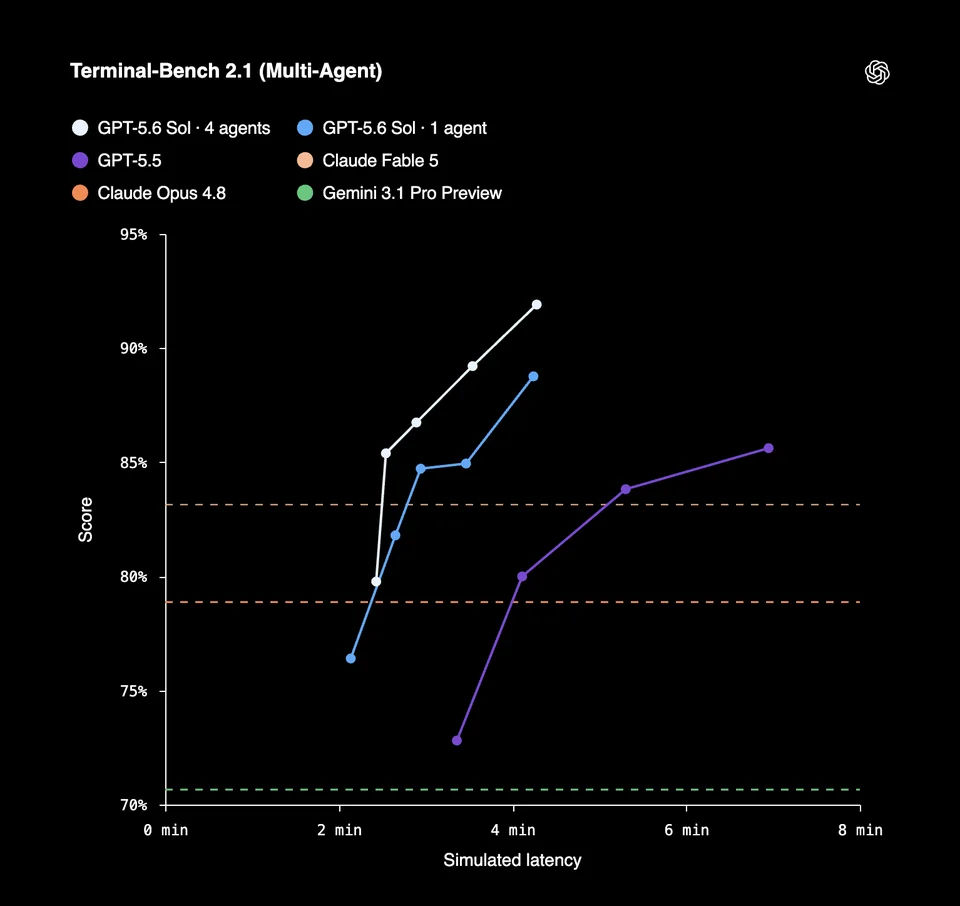
La guía de OpenAI para desarrolladores sobre GPT-5.6 también da pistas sobre dónde se incorpora el comportamiento multiagente en el proceso de entrenamiento (durante el postentrenamiento con RL):
Entrenamos GPT-5.6 de extremo a extremo con tres intervenciones arquitectónicas complementarias que permiten a los agentes trabajar de forma más eficiente:
- Reutilizar el trabajo ya realizado: al permitir que el razonamiento se conserve entre turnos del modelo y usar la compactación nativa para comprimir conversaciones prolongadas, el modelo puede mantener la coherencia de su trabajo a lo largo de horizontes de tareas más extensos sin confundirse ni tener que reconstruir el contexto previo.
- Descomposición en paralelo cuando corresponda: usar la orquestación nativa de múltiples agentes permite coordinar varios agentes en líneas de trabajo paralelas para completar tareas complejas más rápido.
- Trasladar el trabajo determinista al código: usar llamadas programáticas a herramientas para filtrar, agregar y orquestar sus resultados fuera de la ventana de contexto del modelo, reservando los tokens del modelo para tareas que requieren criterio y reduciendo el coste, la latencia y el deterioro del contexto.
La infraestructura necesaria para coordinar las actualizaciones de los pesos del modelo con los procesos de inferencia que generan rollouts de RL es compleja. Nathan Lambert ha escrito sobre parte del trabajo de sistemas necesario para que el entrenamiento con RL sea eficiente.
Una visión excesivamente simplificada de un sistema de entrenamiento con RL sería algo así:
- un conjunto de procesos de entrenamiento que actualizan los pesos del modelo;
- un conjunto de procesos de inferencia que ejecutan alguna versión de esos pesos para generar rollouts;
- infraestructura que transfiere pesos, recompensas y otros datos de estado entre ambos.
Para una tarea con un solo agente, un rollout consiste en un modelo que genera una trayectoria lineal (llamadas a herramientas, tokens de salida).
Pero, una vez que la política que se está entrenando puede crear y coordinar otros agentes, la unidad que constituye un rollout se amplía. Un rollout pasa a ser un árbol asíncrono que contiene decenas o cientos de trayectorias de modelos.
Esto significa que la cantidad de recursos de cómputo de inferencia que se pueden dedicar de forma útil a producir una sola trayectoria de entrenamiento puede aumentar drásticamente. Y si quieres que el modelo aprenda a coordinarse bien - y no limitarte a añadir una capa de orquestación a un modelo ya entrenado -, querrás incluir algunas de estas grandes trayectorias multiagente dentro del ciclo de postentrenamiento.
Yo diría que la versión interna de Astra se está entrenando con una receta perfeccionada para fomentar la orquestación nativa de múltiples agentes. Incluso con esta receta perfeccionada, es probable que aún queden aspectos por pulir, por lo que Noam atribuye <10% de los resultados de Navier-Stokes al carácter multiagente del sistema que usaron para producir la solución.
A medida que se perfeccione la receta, veremos sistemas multiagente que actúan de forma más eficiente y muestran un comportamiento más coherente. En lugar de gastar 300.000 millones de tokens para producir una solución, un enjambre multiagente más eficiente podría producirla con muchos menos tokens.
Como también señala Noam en la entrevista, este proceso de entrenamiento sigue siendo frágil. Es difícil conseguir que los modelos usen eficazmente la comunicación entre instancias; a menudo se ven trayectorias "inútiles" en las que los modelos no se comunican ni aportan contexto alguno a otras instancias.
Aun así, dado el optimismo y los rumores sobre el nuevo modelo de nivel GPT-6, parece que el equipo de OpenAI ya ha logrado avances sustanciales en esta dirección.
Publicado originalmente en LessWrong.