Treinar modelos para coordenar o trabalho entre múltiplos agentes nos dá uma forma de usar produtivamente muito mais poder computacional durante o pós-treinamento do que nas configurações atuais de RL com um único agente.
Do recente episódio do Dwarkesh Podcast com Noam Brown:
Noam Brown
Mas esse é um ponto de dados. Não sabemos quanto tempo um único agente levaria para resolver Navier-Stokes, porque ainda não fizemos esse experimento. Talvez façamos, mas isso também seria apenas um ponto de dados.
Se quisermos fazer uma ablação completa , os experimentos são caros demais nessa escala. Então precisamos fazer algum tipo de investigação científica metódica sobre o que acontece quando passamos para 64, 128, 256 ou algo assim, para ter uma ideia do comportamento. Mas vai ser muito difícil levar isso até 10.000 e saber com certeza qual foi o benefício que realmente obtivemos ao usar 10.000 agentes em vez de 1.000.
Quero deixar uma coisa clara. O esforço para resolver um Problema do Prêmio do Milênio não se deveu ao uso de múltiplos agentes. Eu não atribuiria nem 10% do mérito ao uso de múltiplos agentes. A realidade é que a OpenAI treinou um modelo muito poderoso. Conseguimos fazer esse modelo operar ao longo de horizontes muito extensos. Conseguimos fazê-lo pensar em paralelo.
Mas, no fundo, o motivo de conseguirmos fazer isso é que temos um modelo de uso geral muito capaz. Coisas como o uso de múltiplos agentes chamam a atenção e são novidade, e provavelmente recebem um mérito desproporcional por isso. Mas o motivo central é que esse é um modelo muito poderoso.
Noam está se referindo ao anúncio do GPT-5.6.
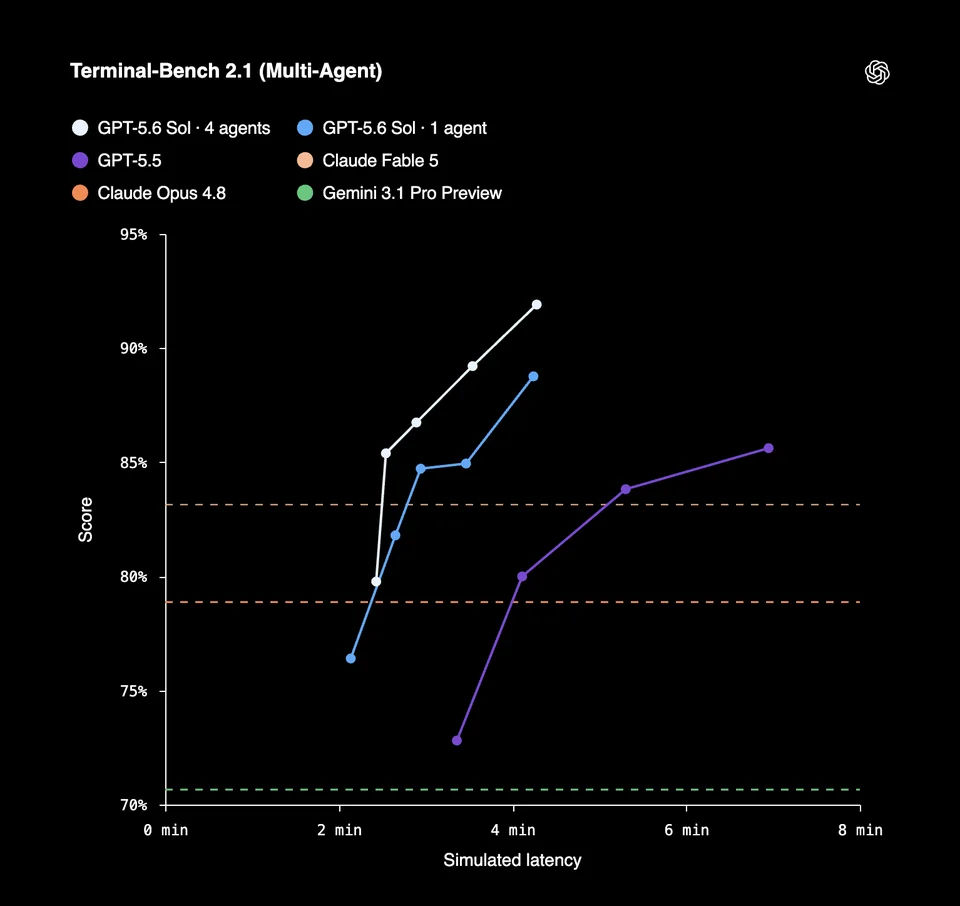
O Guia da OpenAI para desenvolvedores sobre o GPT-5.6 também dá pistas sobre onde o comportamento multiagente entra na pilha de treinamento (durante o pós-treinamento com RL):
Treinamos o GPT-5.6 de ponta a ponta com três intervenções arquiteturais complementares que permitem que os agentes operem com mais eficiência:
- Reutilizar o trabalho já realizado: ao permitir que o raciocínio seja preservado entre os turnos do modelo e usar a compactação nativa para comprimir conversas de longa duração, o modelo consegue manter a coerência do seu trabalho ao longo de horizontes de tarefa mais extensos, sem se confundir ou precisar reconstruir o contexto anterior.
- Decomposição paralela quando apropriado: usar a orquestração nativa de múltiplos agentes permite coordenar vários agentes em frentes de trabalho paralelas para concluir tarefas complexas mais rapidamente.
- Transferir o trabalho determinístico para código: usar chamadas programáticas de ferramentas para filtrar, agregar e orquestrar as saídas das ferramentas fora da janela de contexto do modelo, reservando os tokens do modelo para a tomada de decisões e reduzindo o custo, a latência e a degradação do contexto.
A infraestrutura necessária para coordenar as atualizações dos pesos do modelo com os workers de inferência que geram rollouts de RL é complexa. Nathan Lambert escreveu sobre parte do trabalho de sistemas necessário para tornar o treinamento com RL eficiente.
Uma visão simplificada ao extremo de um sistema de treinamento com RL seria mais ou menos assim:
- um conjunto de workers de aprendizado que atualizam os pesos do modelo;
- um conjunto de workers de inferência que usam alguma versão desses pesos para gerar rollouts;
- infraestrutura que transfere pesos, recompensas e outros estados entre os dois.
Para uma tarefa com um único agente, um rollout consiste em um modelo produzindo uma trajetória linear (chamadas de ferramentas, tokens de saída).
Mas, quando a política que está sendo treinada pode criar e coordenar outros agentes, a unidade de um rollout se torna maior. Nesse caso, um rollout passa a ser uma árvore assíncrona que contém dezenas ou centenas de trajetórias de modelos.
Isso significa que a quantidade de poder computacional de inferência que pode ser usada de forma útil para produzir uma única trajetória de treinamento pode aumentar drasticamente. E, se você quer que o modelo aprenda a se coordenar bem - em vez de simplesmente acoplar uma camada de orquestração a um modelo já treinado -, vai querer incluir algumas dessas grandes trajetórias multiagentes no ciclo de pós-treinamento.
Eu diria que a versão interna do Astra está sendo treinada com uma receita aprimorada para incentivar um comportamento nativo de orquestração de múltiplos agentes. Mesmo com essa receita aprimorada, provavelmente ainda há arestas a aparar, o que explica por que Noam atribui <10% dos resultados de Navier-Stokes ao caráter multiagente do sistema que usaram para produzir a solução.
À medida que a receita melhorar, veremos sistemas multiagentes operarem com mais eficiência e apresentarem um comportamento mais coerente. Em vez de gastar 300 bilhões de tokens para produzir uma solução, um enxame multiagente mais eficiente pode produzir uma solução com um número significativamente menor de tokens.
Como Noam também observa na entrevista, esse processo de treinamento ainda é frágil. É difícil incentivar os modelos a usar a comunicação entre instâncias de forma eficaz; muitas vezes você verá trajetórias "inúteis" em que os modelos não se comunicam nem inserem qualquer contexto em outras instâncias.
Dado o otimismo e os rumores sobre o novo modelo de nível GPT-6, porém, parece que a equipe da OpenAI já fez avanços substanciais nessa direção.
Publicado originalmente no LessWrong.