Entraîner les modèles à se coordonner entre agents nous permet d’utiliser de manière productive beaucoup plus de ressources de calcul pendant le post-entraînement qu’avec les configurations actuelles de RL à agent unique.
Dans le récent épisode du podcast Dwarkesh avec Noam Brown :
Noam Brown
Mais ce n’est qu’un point de données. Nous ne savons pas combien de temps il faudrait à un seul agent pour résoudre Navier-Stokes, parce que nous n’avons pas encore fait cette expérience. Peut-être que nous la ferons, mais cela ne donnera encore qu’un seul point de données.
Si nous voulons réaliser une étude d’ablation approfondie , les expériences sont tout simplement trop coûteuses à cette échelle. Nous devons donc adopter une démarche scientifique méthodique pour étudier ce qui se passe quand on passe à 64, 128, 256 agents, ou quelque chose de cet ordre, et nous faire une idée du comportement. Mais il sera très difficile de pousser cela jusqu’à 10 000 et de savoir avec certitude quel bénéfice nous avons réellement tiré de l’utilisation de 10 000 agents par rapport à 1 000.
Il y a une chose que je tiens à clarifier. Le travail mené pour résoudre un problème du prix du millénaire, ce n’était pas grâce à l’approche multi-agents. Je ne lui attribuerais même pas 10 % du mérite. La réalité est qu’OpenAI a entraîné un modèle très puissant. Nous pouvons faire fonctionner ce modèle sur de très longs horizons. Nous pouvons le faire réfléchir en parallèle.
Mais, au fond, la raison pour laquelle nous sommes capables de faire cela, c’est que nous avons tout simplement un modèle généraliste très performant. Des techniques comme l’approche multi-agents sont spectaculaires et nouvelles, et c’est probablement pour cette raison qu’on leur attribue un mérite disproportionné. Mais la raison fondamentale, c’est simplement que ce modèle est très puissant.
Noam fait référence à l’annonce de GPT-5.6.
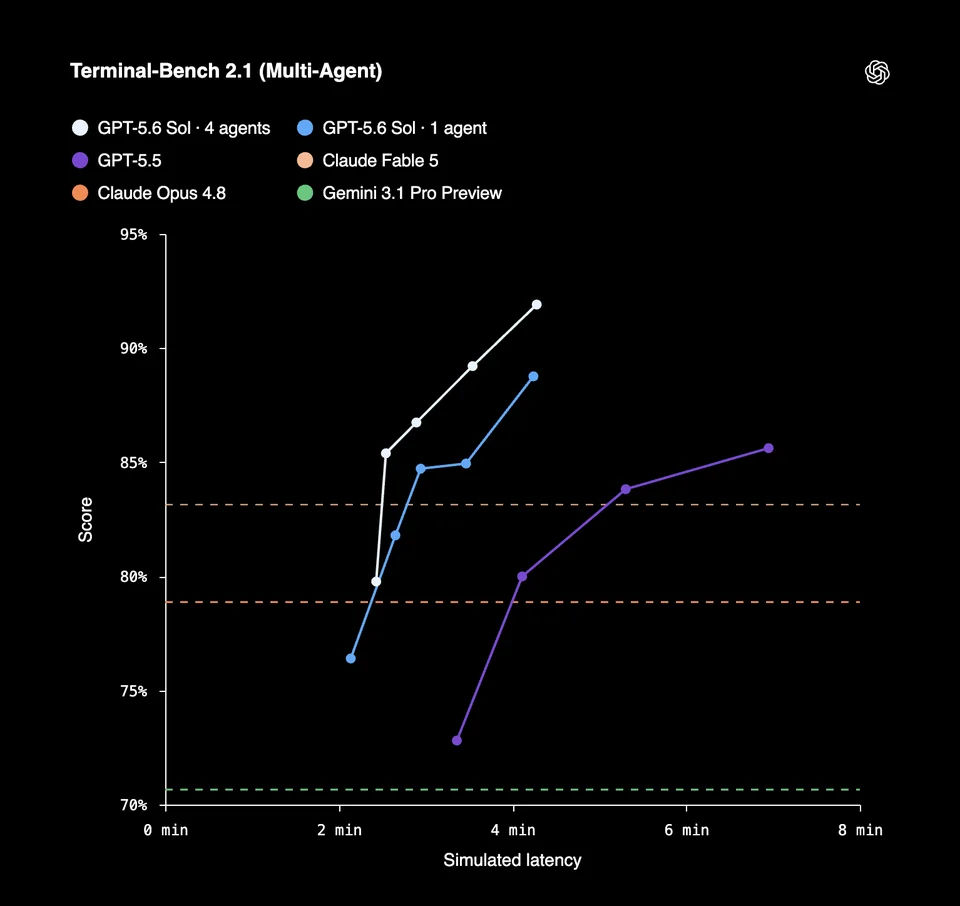
Le guide d’OpenAI sur GPT-5.6 à l’intention des développeurs laisse également entrevoir à quel stade du processus d’entraînement intervient le comportement multi-agents (pendant le post-entraînement par RL) :
Nous avons entraîné GPT-5.6 de bout en bout avec trois interventions architecturales complémentaires qui permettent aux agents de travailler plus efficacement :
- Réutiliser le travail déjà effectué : en permettant de conserver le raisonnement d’un tour du modèle à l’autre et en utilisant la compaction native pour compresser les conversations de longue durée, le modèle peut maintenir la cohérence de son travail sur des horizons de tâche plus longs sans s’embrouiller ni devoir reconstituer le contexte antérieur.
- Décomposer le travail en tâches parallèles lorsque c’est pertinent : l’orchestration multi-agents native permet de coordonner plusieurs agents sur des axes de travail parallèles afin d’achever plus rapidement des tâches complexes.
- Déplacer le travail déterministe vers du code : utiliser les appels d’outils par programmation pour filtrer, agréger et orchestrer les sorties des outils en dehors de la fenêtre de contexte du modèle, afin de réserver les tokens du modèle aux tâches de jugement et de réduire les coûts, la latence et la dégradation du contexte.
L’infrastructure nécessaire pour coordonner les mises à jour des poids du modèle avec les processus d’inférence qui génèrent les rollouts de RL est complexe. Nathan Lambert a décrit une partie du travail d’ingénierie des systèmes nécessaire pour rendre l’entraînement par RL efficace.
Une représentation très simplifiée d’un système d’entraînement par RL ressemble à ceci :
- un ensemble de processus d’apprentissage qui mettent à jour les poids du modèle ;
- un ensemble de processus d’inférence qui exécutent une version de ces poids pour générer des rollouts ;
- une infrastructure qui transfère les poids, les récompenses et d’autres éléments d’état entre les deux.
Pour une tâche à agent unique, un rollout correspond à la production, par un modèle, d’une trajectoire linéaire (appels d’outils, tokens de sortie).
Mais dès que la politique en cours d’entraînement peut lancer et coordonner d’autres agents, l’unité que constitue un rollout prend de l’ampleur. Un rollout devient alors un arbre asynchrone contenant des dizaines ou des centaines de trajectoires de modèles.
Cela signifie que la quantité de ressources de calcul d’inférence que l’on peut utilement consacrer à la production d’une seule trajectoire d’entraînement peut augmenter considérablement. Et si vous voulez que le modèle apprenne à bien se coordonner - plutôt que de simplement greffer une couche d’orchestration sur un modèle déjà entraîné - vous voudrez inclure certaines de ces grandes trajectoires multi-agents dans la boucle de post-entraînement.
Je suppose que la version interne d’Astra est entraînée selon une recette affinée visant à encourager un comportement natif d’orchestration multi-agents. Même avec cette recette affinée, il reste probablement des comportements inattendus à corriger, ce qui explique pourquoi Noam attribue <10 % des résultats sur Navier-Stokes au caractère multi-agents du système qu’ils ont utilisé pour produire la solution.
À mesure que la recette s’améliorera, nous verrons les systèmes multi-agents fonctionner plus efficacement et produire des comportements plus cohérents. Au lieu de dépenser 300 milliards de tokens pour produire une solution, un essaim multi-agents plus efficace pourrait produire une solution avec beaucoup moins de tokens.
Comme Noam le souligne également dans l’entretien, ce processus d’entraînement reste fragile. Il est difficile d’inciter les modèles à utiliser efficacement la communication entre instances ; on observe souvent des trajectoires « inutiles » où les modèles ne communiquent pas du tout et n’injectent aucun contexte dans les autres instances.
Toutefois, au vu de l’optimisme et des rumeurs autour du nouveau modèle de niveau GPT-6, il semble que l’équipe d’OpenAI ait déjà fait des progrès substantiels dans cette direction.
Publié à l’origine sur LessWrong.