Обучение моделей координации работы нескольких агентов позволяет нам продуктивно использовать при постобучении существенно больше вычислительных ресурсов, чем в нынешних одноагентных схемах RL.
Из недавнего выпуска подкаста Дваркеша с Ноамом Брауном:
Ноам Браун
Но это всего одно наблюдение. Мы не знаем, сколько времени понадобилось бы одному агенту, чтобы решить задачу Навье — Стокса, потому что ещё не проводили такого эксперимента. Возможно, проведём, но это тоже будет всего одно наблюдение.
Если мы хотим провести тщательное абляционное исследование , эксперименты в таком масштабе просто слишком дороги. Поэтому нам нужно методично исследовать, что происходит при переходе к 64, 128, 256 агентам или какому-то подобному числу, чтобы получить представление о поведении системы. Но дойти в этих исследованиях до 10 000 агентов и точно установить, какой выигрыш мы получили от использования 10 000 агентов вместо 1 000, будет очень трудно.
Я хочу прояснить одну вещь. Работа над решением одной из задач тысячелетия — это не заслуга многоагентного подхода. Я бы не приписал многоагентному подходу даже 10% заслуг. Реальность в том, что OpenAI обучила очень мощную модель. Мы можем добиться, чтобы эта модель работала на очень длинных горизонтах. Можем заставить её думать параллельно.
Но в основе всего этого — просто очень сильная модель общего назначения. Именно благодаря ей мы можем это делать. Такие вещи, как многоагентность, выглядят эффектно и новы, и, вероятно, поэтому им приписывают непропорционально большую долю заслуг. Но главная причина в том, что это просто очень мощная модель.
Ноам имеет в виду анонс GPT-5.6.
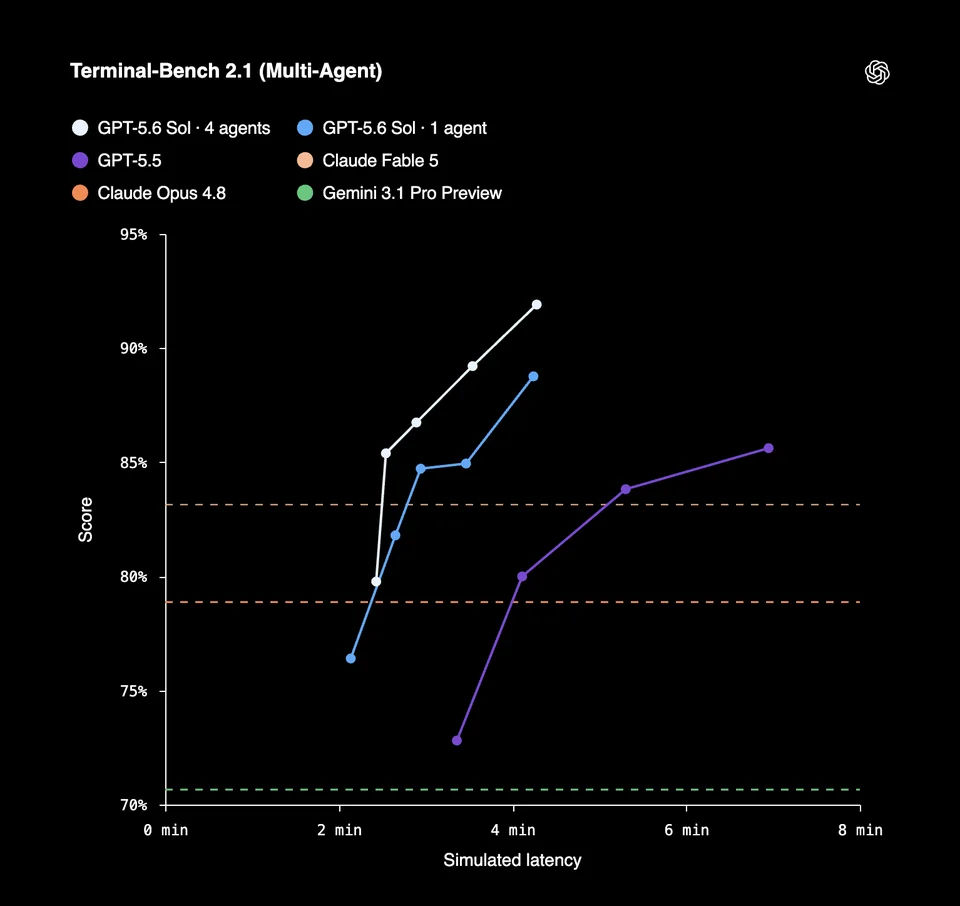
В руководстве OpenAI для разработчиков по GPT-5.6 также есть намёк на то, где в стеке обучения появляется многоагентное поведение (в ходе постобучения с RL):
Мы провели сквозное обучение GPT-5.6 с тремя взаимодополняющими архитектурными изменениями, которые позволяют агентам работать эффективнее:
- Повторно использовать уже выполненную работу: благодаря возможности сохранять рассуждения между ходами модели и встроенному сжатию длительных диалогов модель может сохранять согласованность своих действий при более длительной работе над задачами, не запутываясь и без необходимости восстанавливать предыдущий контекст.
- Параллельная декомпозиция там, где это уместно: использование встроенной многоагентной оркестрации позволяет координировать работу нескольких агентов по параллельным направлениям и быстрее выполнять сложные задачи.
- Переносить детерминированную работу в код: использование программных вызовов инструментов для фильтрации, агрегации и оркестрации их результатов за пределами контекстного окна модели позволяет оставлять токены модели для принятия решений и снижать стоимость, задержку и степень деградации контекста.
Инфраструктура, необходимая для согласования обновлений весов модели с работой инференс-воркеров, генерирующих роллауты для RL, сложна. Натан Ламберт писал о некоторых инженерных работах над такими системами, необходимых для эффективного RL-обучения.
В сильно упрощённом виде система RL-обучения выглядит примерно так:
- набор обучающих воркеров, обновляющих веса модели;
- набор инференс-воркеров, использующих одну из версий этих весов для генерации роллаутов;
- инфраструктура, передающая веса, вознаграждения и прочее состояние между ними.
Для одноагентной задачи один роллаут — это модель, создающая линейную траекторию (вызовы инструментов, выходные токены).
Но как только обучаемая политика получает возможность запускать других агентов и координировать их работу, роллаут становится более крупной единицей. Теперь один роллаут — это асинхронное дерево, содержащее десятки или сотни траекторий модели.
Это означает, что объём вычислительных ресурсов для инференса, который можно с пользой задействовать для создания одной обучающей траектории, может резко вырасти. И если вы хотите, чтобы модель научилась хорошо координировать работу, — а не просто добавить слой оркестрации к уже обученной модели, — стоит включить некоторые из этих крупных многоагентных траекторий в цикл постобучения.
Я бы предположил, что внутреннюю версию Astra обучают по доработанной схеме, чтобы развивать у неё встроенную способность к многоагентной оркестрации. Даже при такой доработанной схеме, вероятно, остаются особенности поведения, которые ещё нужно исправить, поэтому Ноам связывает <10% результатов по задаче Навье — Стокса с многоагентным характером системы, которую они использовали для получения решения.
По мере совершенствования схемы обучения мы увидим, как многоагентные системы работают эффективнее и ведут себя более согласованно. Вместо того чтобы тратить 300 млрд токенов на получение решения, более эффективный рой агентов может получить решение, потратив значительно меньше токенов.
Как Ноам также отмечает в интервью, этот процесс обучения всё ещё хрупок. Трудно побудить модели эффективно использовать обмен сообщениями между экземплярами; часто можно увидеть «бесполезные» траектории, в которых модели вообще не общаются и не передают контекст другим экземплярам.
Впрочем, судя по оптимизму и слухам о новой модели уровня GPT-6, команда OpenAI, похоже, уже существенно продвинулась в этом направлении.
Впервые опубликовано на LessWrong.