여러 에이전트 사이에서 작업을 조율하도록 모델을 학습시키면, 사후 학습 중에 현재의 단일 에이전트 RL 구성에서보다 훨씬 더 많은 연산 자원을 생산적으로 활용할 수 있다.
최근 노암 브라운이 출연한 Dwarkesh Podcast에서:
노암 브라운
하지만 그건 하나의 데이터 포인트일 뿐입니다. 단일 에이전트가 나비에-스토크스를 푸는 데 얼마나 걸릴지는 모릅니다. 아직 그 실험을 해보지 않았으니까요. 앞으로 해볼 수도 있겠지만, 그것 역시 데이터 포인트 하나에 불과합니다.
우리가 수행하려는 것이 철저한 어블레이션 실험 이라면, 그 규모에서는 실험 비용이 너무 많이 듭니다. 따라서 에이전트 수를 64개, 128개, 256개 정도로 늘렸을 때 어떤 일이 일어나는지 체계적으로 연구해 행동 양상을 파악해야 합니다. 하지만 이를 10,000개까지 늘리고, 에이전트 1,000개 대신 10,000개를 사용해서 실제로 얻은 이점이 무엇인지 확실히 알아내기는 매우 어려울 겁니다.
한 가지 분명히 하고 싶은 점이 있습니다. 밀레니엄 문제를 해결하기 위한 이번 작업은 멀티 에이전트 덕분에 이뤄진 것이 아닙니다. 저는 그 공의 10%조차 멀티 에이전트에 돌리지 않겠습니다. 실제로는 OpenAI가 매우 강력한 모델을 학습시킨 겁니다. 우리는 그 모델이 매우 긴 작업 구간에 걸쳐 작동하도록 할 수 있습니다. 병렬로 생각하게 할 수도 있습니다.
하지만 근본적으로 우리가 이런 일을 할 수 있는 이유는 그저 매우 강력한 범용 모델을 갖고 있기 때문입니다. 멀티 에이전트 같은 기술은 화려하고 새롭다 보니, 아마 그 때문에 실제 기여 이상으로 공을 인정받는 것 같습니다. 하지만 핵심적인 이유는 그저 모델이 매우 강력하다는 것입니다.
노암이 말하는 것은 GPT-5.6 발표다.
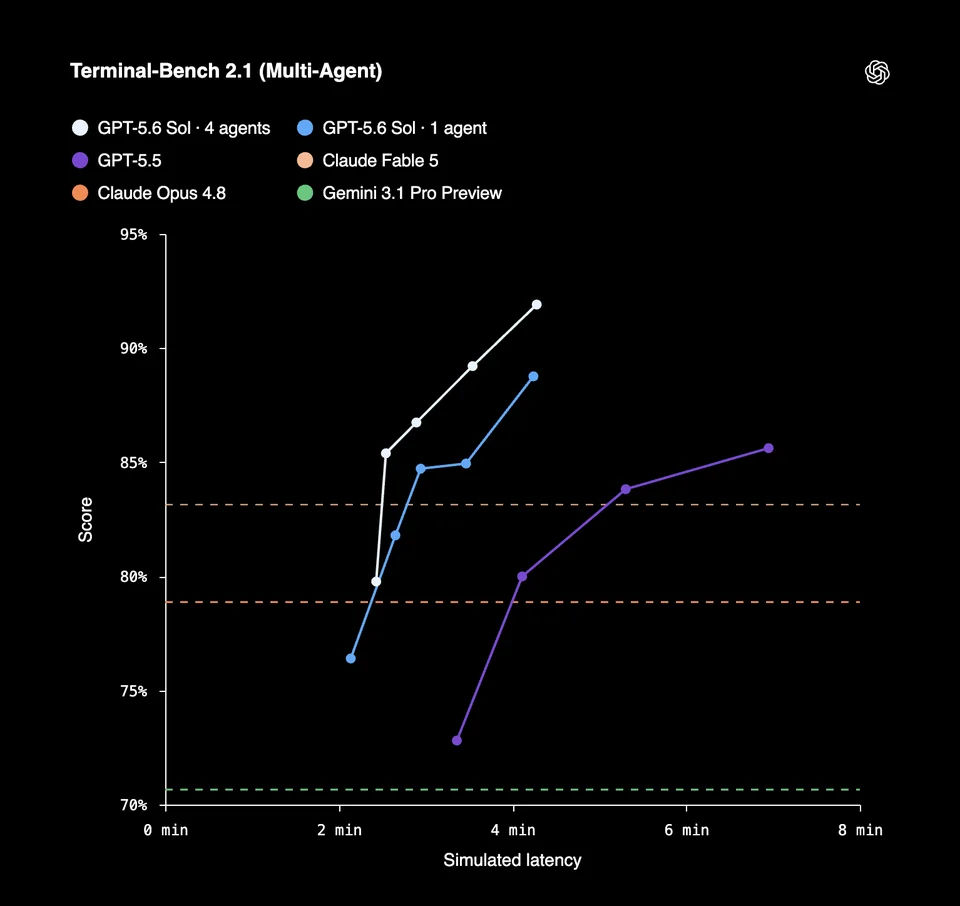
OpenAI의 GPT-5.6 빌더 가이드에도 멀티 에이전트 행동이 학습 스택의 어느 단계에 들어가는지(RL 사후 학습 중) 짐작할 수 있는 단서가 있다:
서로 보완적인 세 가지 아키텍처 변경을 적용해 GPT-5.6을 엔드투엔드로 학습시켰으며, 이를 통해 에이전트가 더 효율적으로 작동할 수 있게 했습니다:
- 이미 수행한 작업 재사용: 모델 턴 사이에 추론 내용을 보존하고 네이티브 압축 기능으로 장시간 이어지는 대화를 압축하면, 모델은 혼란에 빠지거나 이전 컨텍스트를 재구성할 필요 없이 더 긴 작업 구간에 걸쳐 일관성을 유지할 수 있습니다.
- 적절한 경우 병렬로 분해: 네이티브 멀티 에이전트 오케스트레이션을 사용하면 병렬 작업 흐름 전반에서 여러 에이전트를 조율해 복잡한 작업을 더 빠르게 완료할 수 있습니다.
- 결정론적 작업을 코드로 옮기기: 프로그래밍 방식의 도구 호출을 사용해 모델의 컨텍스트 창 밖에서 도구 출력을 필터링하고, 집계하고, 조율함으로써 모델 토큰을 판단에 쓸 수 있도록 남겨 두고 비용, 지연 시간, 컨텍스트 열화를 줄입니다.
모델 가중치 업데이트를 RL 롤아웃을 생성하는 추론 워커와 조율하려면 복잡한 인프라가 필요하다. 네이선 램버트는 RL 학습을 효율적으로 만드는 데 필요한 시스템 개발 작업의 일부에 관해 쓴 적이 있다.
RL 학습 시스템을 다소 과하게 단순화하면 대략 다음과 같다:
- 모델 가중치를 업데이트하는 학습 워커 집합;
- 해당 가중치의 특정 버전을 사용해 롤아웃을 생성하는 추론 워커 집합;
- 두 집합 사이에서 가중치, 보상, 그 밖의 상태를 전달하는 인프라.
단일 에이전트 작업에서 롤아웃 하나는 모델이 선형 궤적(도구 호출, 출력 토큰)을 생성하는 과정이다.
하지만 학습 중인 정책이 다른 에이전트를 생성하고 조율할 수 있게 되면 롤아웃의 단위가 더 커진다. 롤아웃 하나가 수십 개 또는 수백 개의 모델 궤적을 포함하는 비동기 트리가 되는 것이다.
이는 단일 학습 궤적을 생성하는 데 유용하게 투입할 수 있는 추론 연산량이 크게 늘어날 수 있다는 뜻이다. 그리고 이미 학습된 모델에 오케스트레이션 계층을 덧붙이는 데 그치지 않고, 모델이 효과적인 조율 행동을 학습하기를 원한다면 이런 대규모 멀티 에이전트 궤적 중 일부를 사후 학습 루프에 포함해야 한다.
내 추측으로는 내부 버전의 Astra는 네이티브 멀티 에이전트 오케스트레이션 행동을 유도하도록 다듬은 학습법으로 학습되고 있을 것이다. 이렇게 다듬은 학습법을 쓰더라도 아직 해결해야 할 특이한 동작이 남아 있을 가능성이 높다. 이는 노암이 나비에-스토크스 결과에서, 해법을 도출하는 데 사용한 시스템의 멀티 에이전트 특성이 기여한 비중을 10% 미만으로 보는 이유다.
학습법이 개선되면 멀티 에이전트 시스템이 더 효율적으로 작동하고 더 일관된 행동을 보이는 모습을 보게 될 것이다. 해법 하나를 도출하는 데 토큰 3,000억 개를 쓰는 대신, 더 효율적인 멀티 에이전트 군집은 훨씬 적은 토큰으로 해법을 도출할 수도 있다.
노암도 인터뷰에서 언급했듯이, 이 학습 과정은 여전히 불안정하다. 모델이 인스턴스 간 통신을 효과적으로 활용하도록 유도하기는 어렵다. 모델이 서로 소통하지도, 다른 인스턴스에 컨텍스트를 전달하지도 않는 "쓸모없는" 궤적을 자주 보게 된다.
다만 새로운 GPT-6급 모델을 둘러싼 낙관론과 소문을 보면, OpenAI 팀은 이미 이 방향으로 상당한 진전을 이룬 듯하다.
이 글은 원래 LessWrong에 게시되었다.