Melatih model untuk berkoordinasi antaragen memberi kita cara untuk menggunakan jauh lebih banyak komputasi secara produktif selama pascapelatihan dibandingkan dengan konfigurasi RL agen tunggal saat ini.
Dari Dwarkesh Podcast bersama Noam Brown baru-baru ini:
Noam Brown
Namun, itu hanya satu titik data. Kita tidak tahu berapa lama waktu yang dibutuhkan satu agen untuk memecahkan Navier-Stokes, karena kita belum melakukan eksperimen itu. Mungkin nanti akan kita lakukan, tetapi itu pun hanya satu titik data.
Jika kita ingin melakukan ablasi menyeluruh , eksperimennya terlalu mahal pada skala itu. Jadi, kita harus melakukan kajian ilmiah yang sistematis tentang apa yang terjadi ketika jumlahnya ditingkatkan menjadi 64, 128, 256, atau sekitar itu, agar kita mendapat gambaran tentang perilakunya. Namun, akan sangat sulit untuk meningkatkannya hingga 10.000 dan mengetahui dengan pasti manfaat yang benar-benar kita peroleh dari penggunaan 10.000 agen dibandingkan dengan 1.000 agen.
Ada satu hal yang ingin saya perjelas. Upaya memecahkan salah satu Millennium Prize Problem ini bukan berkat multiagen. Saya bahkan tidak akan memberi multiagen andil sebesar 10%. Kenyataannya, OpenAI telah melatih model yang sangat andal. Kita bisa membuat model itu bekerja dalam jangka waktu yang sangat panjang. Kita bisa membuatnya berpikir secara paralel.
Namun, pada dasarnya, alasan kita bisa melakukan ini adalah karena kita memiliki model serbaguna yang sangat andal. Hal-hal seperti multiagen tampak mencolok dan baru, dan mungkin karena itulah mendapat porsi pengakuan yang terlalu besar. Namun, alasan utamanya adalah model ini memang sangat andal.
Noam merujuk pada pengumuman GPT-5.6.
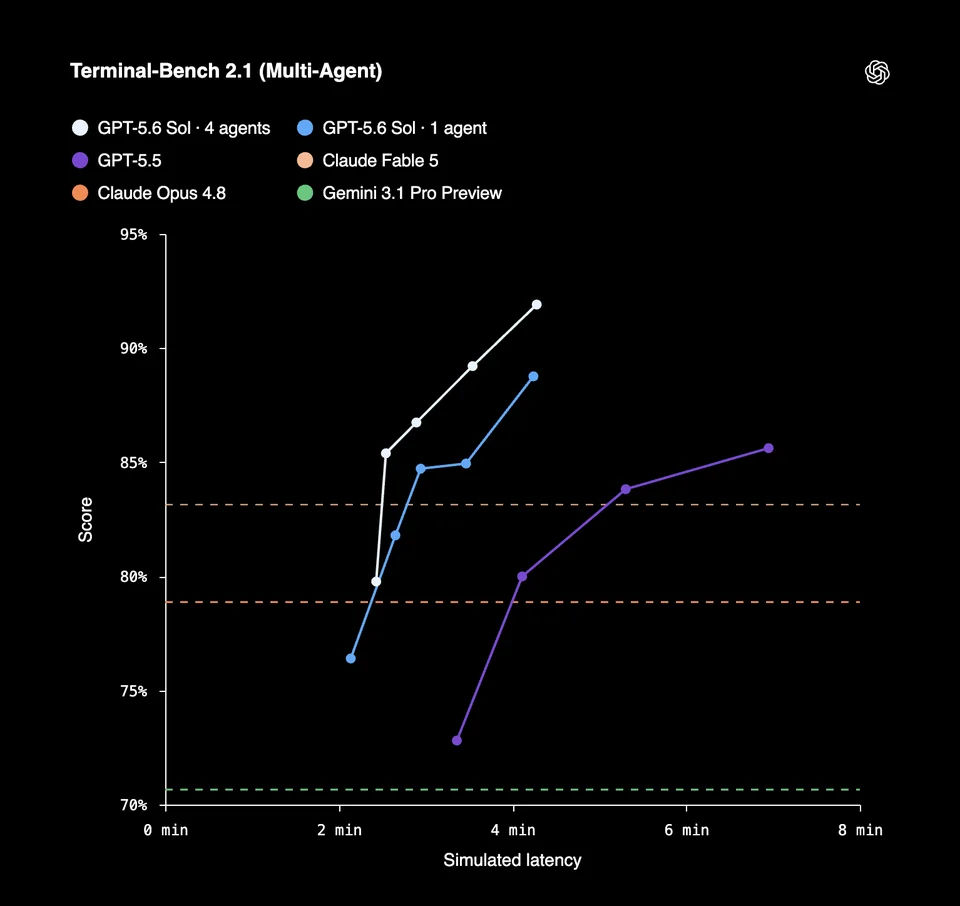
Panduan Pengembang GPT-5.6 dari OpenAI juga memberi petunjuk tentang pada tahap mana perilaku multiagen masuk ke dalam rangkaian pelatihan (selama pascapelatihan RL):
Kami melatih GPT-5.6 secara end-to-end dengan tiga intervensi arsitektural yang saling melengkapi agar agen dapat bekerja lebih efisien:
- Gunakan kembali hasil pekerjaan sebelumnya: dengan memungkinkan penalaran dipertahankan antargiliran model serta menggunakan pemadatan bawaan untuk memadatkan percakapan yang berlangsung lama, model dapat menjaga koherensi pekerjaannya dalam rentang tugas yang lebih panjang tanpa kebingungan atau harus merekonstruksi konteks sebelumnya.
- Penguraian secara paralel bila sesuai: penggunaan orkestrasi multiagen bawaan memungkinkan koordinasi beberapa agen di berbagai alur kerja paralel untuk menyelesaikan tugas kompleks dengan lebih cepat.
- Pindahkan pekerjaan deterministik ke kode: gunakan pemanggilan alat secara terprogram untuk menyaring, mengagregasi, dan mengorkestrasi keluaran alat di luar jendela konteks model, sehingga token model dapat dikhususkan untuk penilaian, sekaligus mengurangi biaya, latensi, dan penurunan kualitas konteks.
Infrastruktur yang diperlukan untuk mengoordinasikan pembaruan bobot model dengan worker inferensi yang menghasilkan rollout RL cukup kompleks. Nathan Lambert telah menulis tentang sebagian pekerjaan rekayasa sistem yang diperlukan agar pelatihan RL berjalan efisien.
Gambaran yang terlalu disederhanakan tentang sistem pelatihan RL kurang lebih seperti ini:
- sekumpulan worker pelatihan yang memperbarui bobot model;
- sekumpulan worker inferensi yang menjalankan suatu versi bobot tersebut untuk menghasilkan rollout;
- infrastruktur yang memindahkan bobot, reward, dan state lainnya di antara keduanya.
Untuk tugas dengan agen tunggal, satu rollout adalah proses ketika model menghasilkan sebuah trajektori linear (pemanggilan alat, token keluaran).
Namun, begitu kebijakan yang dilatih dapat membuat dan mengoordinasikan agen lain, unit rollout menjadi lebih besar. Satu rollout pun menjadi pohon asinkron yang berisi puluhan atau ratusan trajektori model.
Artinya, jumlah komputasi inferensi yang dapat digunakan secara produktif untuk menghasilkan satu trajektori pelatihan dapat meningkat drastis. Dan jika Anda ingin model mempelajari perilaku koordinasi yang baik - bukan sekadar menambahkan lapisan orkestrasi pada model yang sudah dilatih - Anda perlu memasukkan beberapa trajektori multiagen besar ini ke dalam loop pascapelatihan.
Saya menduga versi internal Astra sedang dilatih dengan resep yang telah disempurnakan untuk mendorong perilaku orkestrasi multiagen bawaan. Bahkan dengan resep yang telah disempurnakan ini, kemungkinan masih ada perilaku tak terduga yang perlu dibereskan. Itulah sebabnya Noam menilai bahwa sifat multiagen dari sistem yang mereka gunakan untuk menghasilkan solusi itu menyumbang <10% terhadap hasil Navier-Stokes tersebut.
Seiring penyempurnaan resepnya, kita akan melihat sistem multiagen bekerja lebih efisien dan menghasilkan perilaku yang lebih koheren. Alih-alih menghabiskan 300 miliar token untuk menghasilkan solusi, kawanan agen yang lebih efisien mungkin dapat menghasilkan solusi dengan token yang jauh lebih sedikit.
Seperti yang juga disampaikan Noam dalam wawancara tersebut, proses pelatihan ini masih rapuh. Sulit untuk mendorong model agar menggunakan komunikasi antarinstans secara efektif; sering kali kita akan melihat trajektori "tidak berguna" ketika model sama sekali tidak berkomunikasi maupun menyisipkan konteks ke instans lain.
Namun, melihat optimisme dan rumor tentang model baru sekelas GPT-6, tampaknya tim OpenAI sudah membuat kemajuan besar ke arah ini.
Pertama kali diterbitkan di LessWrong.