Huấn luyện mô hình phối hợp giữa nhiều tác nhân cho chúng ta một cách để sử dụng hiệu quả lượng tài nguyên tính toán lớn hơn đáng kể trong giai đoạn hậu huấn luyện so với các cấu hình RL đơn tác nhân hiện nay.
Trích từ tập Dwarkesh Podcast với Noam Brown gần đây:
Noam Brown
Nhưng đó chỉ là một điểm dữ liệu. Chúng ta không biết một tác nhân đơn lẻ sẽ mất bao lâu để giải Navier-Stokes, vì chúng ta chưa thực hiện thí nghiệm đó. Có thể chúng ta sẽ làm, nhưng đó cũng chỉ là một điểm dữ liệu.
Nếu muốn thực hiện một thử nghiệm loại bỏ thành phần toàn diện , thì các thí nghiệm ở quy mô đó quá tốn kém. Vì vậy, chúng ta phải thực hiện một dạng nghiên cứu khoa học có hệ thống về điều gì xảy ra khi tăng lên 64, 128, 256 hoặc một mức nào đó để nắm được phần nào hành vi của hệ thống. Nhưng sẽ rất khó để đẩy quy mô lên tới 10.000 và biết chắc lợi ích thực sự mà chúng ta thu được khi dùng 10.000 tác nhân so với 1.000 tác nhân là gì.
Có một điều tôi muốn làm rõ. Nỗ lực giải một Bài toán Giải thưởng Thiên niên kỷ này không phải nhờ hệ đa tác nhân. Tôi thậm chí còn không quy 10% công lao cho hệ đa tác nhân. Thực tế là OpenAI đã huấn luyện được một mô hình rất mạnh. Chúng ta có thể khiến mô hình đó hoạt động trong những chuỗi tác vụ rất dài. Chúng ta có thể khiến nó suy nghĩ song song.
Nhưng về cốt lõi, lý do chúng ta có thể làm được điều này là vì chúng ta có một mô hình đa dụng rất mạnh. Những thứ như hệ đa tác nhân mới mẻ và gây chú ý, nên có lẽ vì vậy mà chúng được ghi nhận công lao nhiều hơn mức xứng đáng. Nhưng lý do cốt lõi đơn giản là đây là một mô hình rất mạnh.
Noam đang nói đến thông báo ra mắt GPT-5.6.
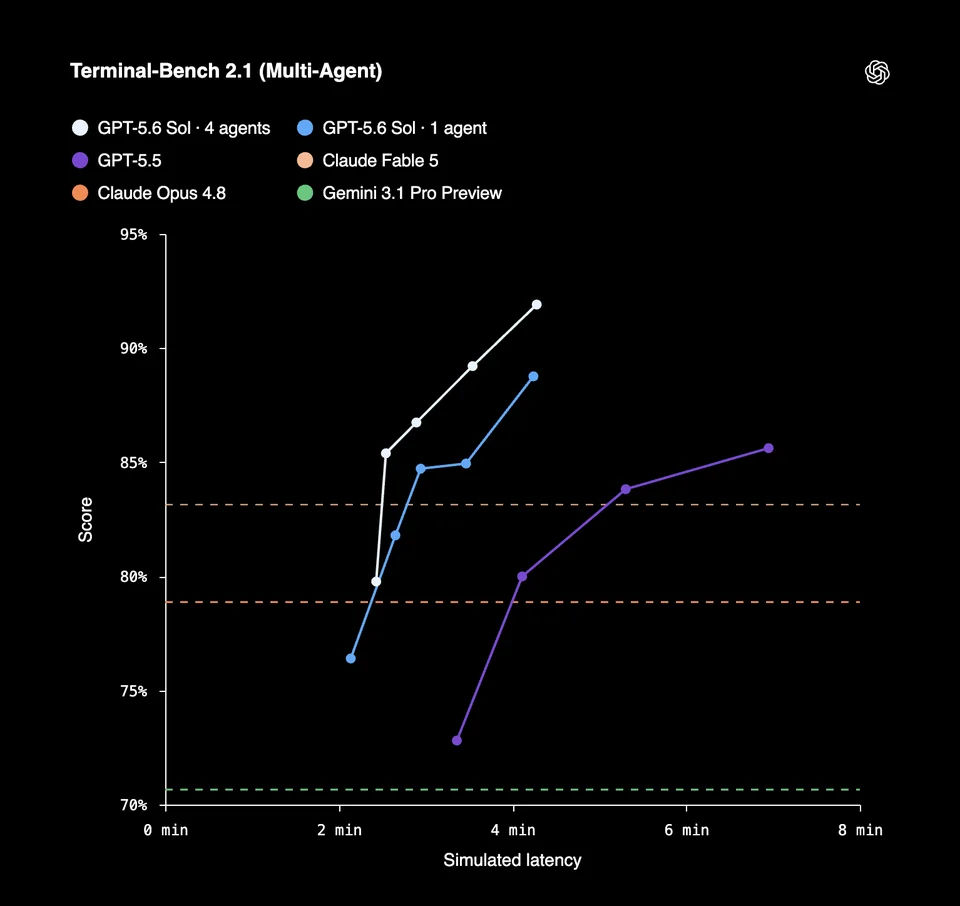
Hướng dẫn GPT-5.6 dành cho nhà phát triển của OpenAI cũng gợi ý về vị trí mà hành vi đa tác nhân được đưa vào hệ thống huấn luyện (trong giai đoạn hậu huấn luyện bằng RL):
Chúng tôi đã huấn luyện đầu cuối GPT-5.6 với ba điều chỉnh kiến trúc bổ trợ cho nhau, giúp các tác nhân hoạt động hiệu quả hơn:
- Tái sử dụng công việc đã thực hiện: bằng cách cho phép lưu giữ quá trình suy luận qua các lượt của mô hình và dùng cơ chế thu gọn tích hợp sẵn để nén các cuộc hội thoại kéo dài, mô hình có thể duy trì sự nhất quán trong công việc khi thực hiện những tác vụ dài hơi hơn mà không bị nhầm lẫn hoặc phải tái dựng ngữ cảnh trước đó.
- Phân rã để xử lý song song khi thích hợp: sử dụng cơ chế điều phối đa tác nhân tích hợp sẵn cho phép phối hợp nhiều tác nhân trên các luồng công việc song song để hoàn thành các tác vụ phức tạp nhanh hơn.
- Chuyển công việc có tính xác định sang mã: sử dụng cơ chế gọi công cụ bằng lập trình để lọc, tổng hợp và điều phối đầu ra của công cụ bên ngoài cửa sổ ngữ cảnh của mô hình, dành token của mô hình cho việc phán đoán và giảm chi phí, độ trễ cũng như tình trạng suy giảm chất lượng ngữ cảnh.
Hạ tầng cần thiết để phối hợp việc cập nhật trọng số mô hình với các worker suy luận đang tạo rollout cho RL rất phức tạp. Nathan Lambert đã viết về một số công việc ở cấp hệ thống cần thiết để huấn luyện bằng RL một cách hiệu quả.
Một bức tranh được đơn giản hóa quá mức về hệ thống huấn luyện bằng RL sẽ trông đại khái như sau:
- một nhóm worker huấn luyện cập nhật trọng số mô hình;
- một nhóm worker suy luận chạy một phiên bản nào đó của các trọng số ấy để tạo rollout;
- hạ tầng chuyển trọng số, phần thưởng và trạng thái khác giữa hai nhóm.
Với một tác vụ đơn tác nhân, một rollout là quá trình một mô hình tạo ra một quỹ đạo tuyến tính (các lệnh gọi công cụ, các token đầu ra).
Nhưng khi chính sách đang được huấn luyện có thể tạo và phối hợp các tác nhân khác, quy mô của mỗi rollout sẽ lớn hơn. Khi đó, một rollout trở thành một cây bất đồng bộ chứa hàng chục hoặc hàng trăm quỹ đạo của mô hình.
Điều này có nghĩa là lượng tài nguyên tính toán suy luận có thể được sử dụng hữu ích để tạo ra một quỹ đạo huấn luyện duy nhất có thể tăng lên rất nhiều. Và nếu bạn muốn mô hình học được hành vi phối hợp tốt - chứ không chỉ gắn thêm một lớp điều phối vào mô hình đã được huấn luyện - bạn sẽ muốn đưa một số quỹ đạo đa tác nhân quy mô lớn như vậy vào vòng lặp hậu huấn luyện.
Tôi đoán phiên bản Astra nội bộ đang được huấn luyện bằng một công thức đã được tinh chỉnh để khuyến khích hành vi điều phối đa tác nhân ngay trong mô hình. Ngay cả với công thức đã được tinh chỉnh này, có lẽ vẫn còn những điểm chưa ổn cần khắc phục, đó là lý do Noam quy <10% thành quả về Navier-Stokes cho tính chất đa tác nhân của hệ thống mà họ đã dùng để tạo ra lời giải.
Khi công thức được cải thiện, chúng ta sẽ thấy các hệ đa tác nhân hoạt động hiệu quả hơn và tạo ra hành vi nhất quán hơn. Thay vì tiêu tốn 300 tỷ token để tạo ra một lời giải, một nhóm tác nhân phối hợp hiệu quả hơn có thể tạo ra lời giải với số token ít hơn đáng kể.
Như Noam cũng lưu ý trong cuộc phỏng vấn, quá trình huấn luyện này vẫn chưa ổn định. Rất khó để khuyến khích các mô hình sử dụng hiệu quả việc giao tiếp giữa các phiên bản thực thi; bạn thường sẽ thấy những quỹ đạo "vô ích", trong đó các mô hình hoàn toàn không giao tiếp hay đưa ngữ cảnh vào các phiên bản thực thi khác.
Dù vậy, xét sự lạc quan và những tin đồn về mô hình mới ở tầm GPT-6, có vẻ nhóm tại OpenAI đã đạt được tiến bộ đáng kể theo hướng này.
Được đăng lần đầu trên LessWrong.